概要
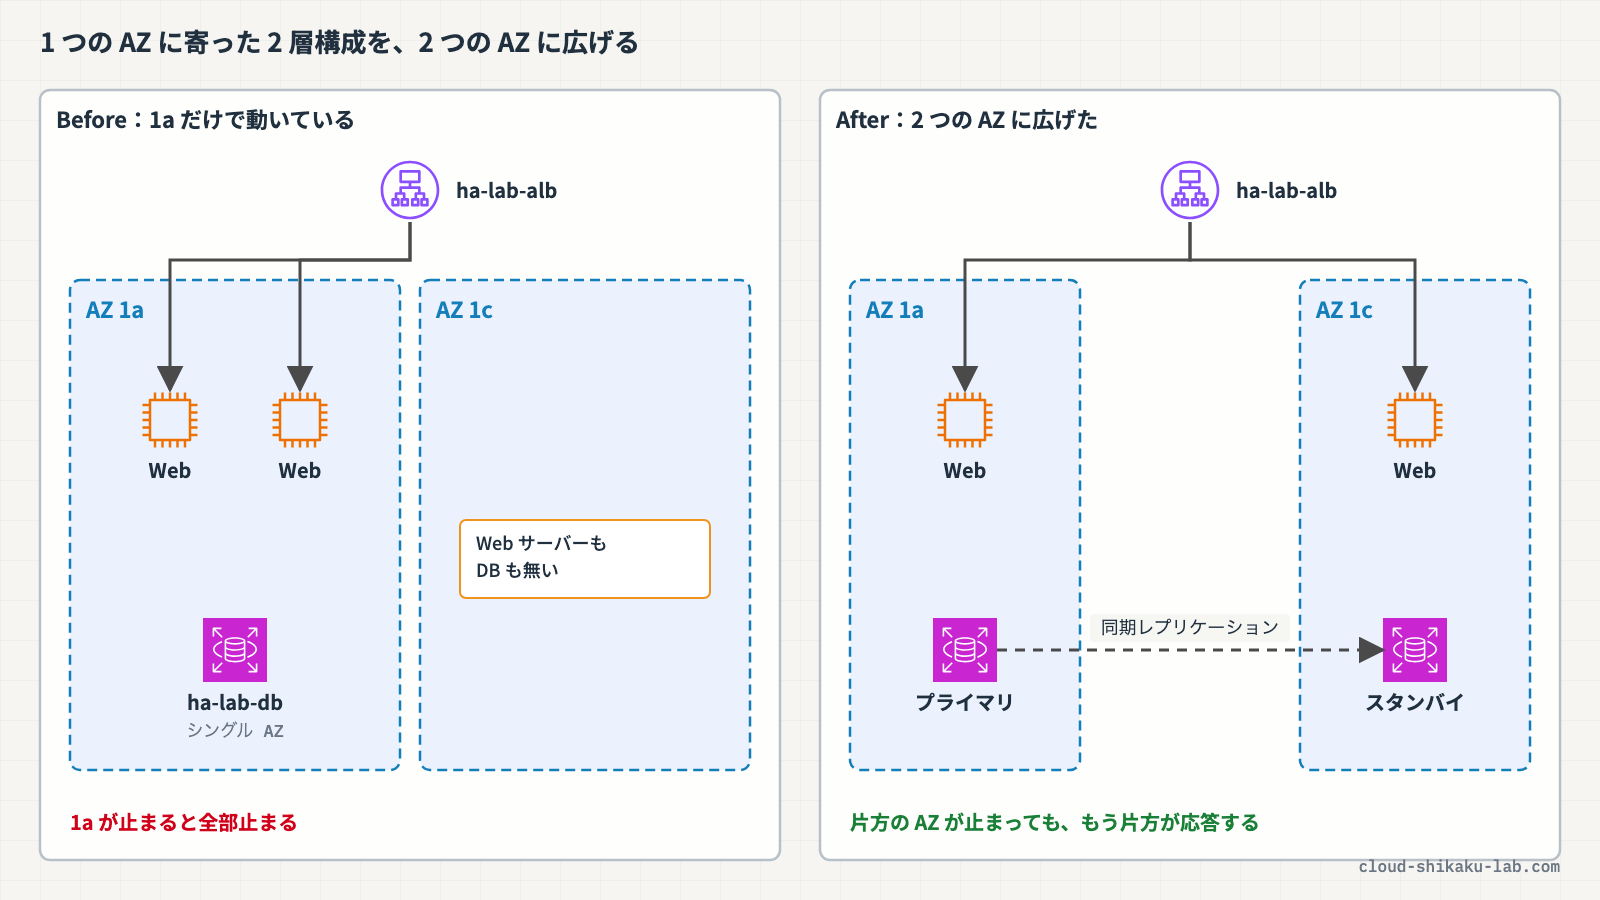
Web サーバーとデータベースを 1 つのアベイラビリティーゾーン(AZ)にまとめて置いた構成は、作るのが簡単な一方で、その AZ に障害が起きるとシステム全体が止まります。サブネットやインスタンスをいくら増やしても、同じ AZ の中に置いている限り、この弱点は変わりません。
高可用性を上げるには、層ごとに「別の AZ に分身を置く」仕組みを入れる必要があります。Web 層は Application Load Balancer(ALB)と Auto Scaling グループを複数の AZ にまたがらせ、データベース層は Amazon RDS のマルチ AZ 配置にします。どちらも、構成を作り直さずに既存の環境へ後から足せるのがポイントです。
この記事では、AZ 障害に耐える構成の考え方と、層ごとに使う仕組みの違いを整理します。実践では、1 つの AZ だけで動いている Web サーバーと RDS を複数 AZ に広げ、RDS のフェイルオーバーを起こしてもエンドポイントが変わらないことを確かめます。
 クラウドおさる
バナナ倉庫を 1 つの山にまとめておくと、その山で崖崩れが起きたら全部おしまいでござる。今日は、Web とデータベースを隣の山にも置いて、片方が崩れても回り続ける形に組み替えるでござるよ。
この記事のメリット
- 「サブネットを増やす」と「AZ を増やす」の違いを説明できるようになる
- Web 層・データベース層それぞれで、複数 AZ に広げるときに何を変えるかが分かる
- Auto Scaling グループに AZ を足したときの再調整(リバランス)の動きが分かる
- RDS マルチ AZ の同期レプリケーション・フェイルオーバー・エンドポイントの扱いを説明できるようになる
- 既存のシングル AZ の RDS をマルチ AZ に変換するときの影響を把握できる
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
 クラウドおさる
はじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
クラウドおさる基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
AZ 障害に耐えるとはどういうことか
AZ は、1 つ以上のデータセンターで構成される、リージョン内の独立した区画です。電源やネットワークが AZ ごとに分かれているため、1 つの AZ に障害が起きても、別の AZ は動き続けます。
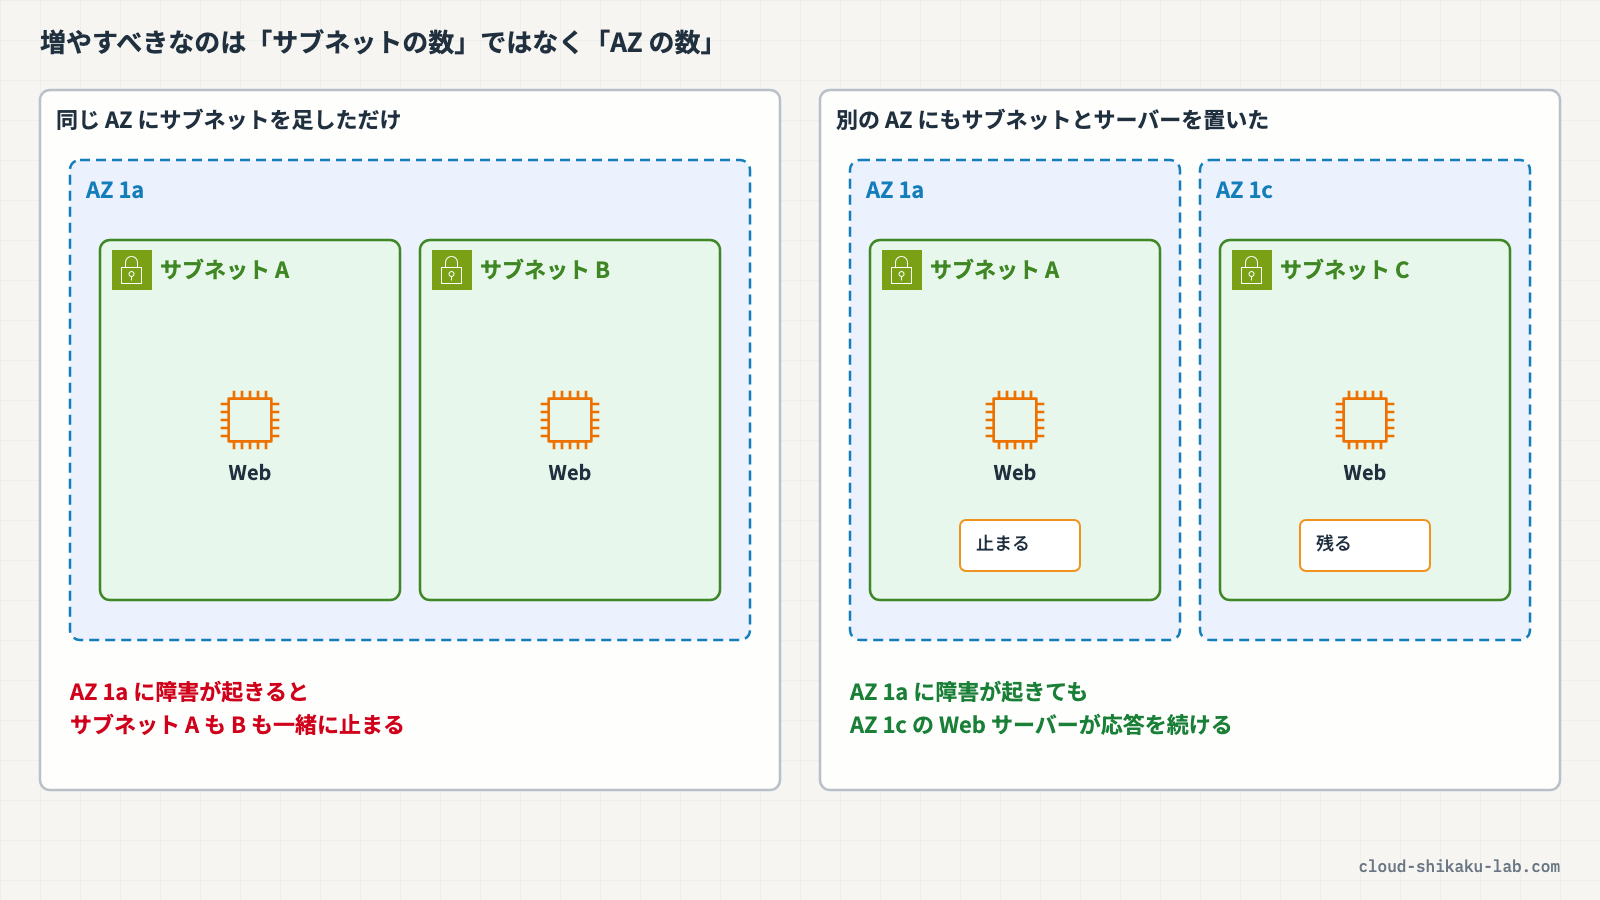
サブネットは必ず 1 つの AZ に属します。そのため、高可用性のために増やすべきなのは「サブネットの数」ではなく「使う AZ の数」です。
| やったこと | AZ 障害に耐えられるか | 理由 |
|---|---|---|
| 同じ AZ にサブネットを追加する | 耐えられない | 新しいサブネットも同じ AZ にあるため、AZ ごと止まる |
| 同じ AZ でインスタンスを増やす | 耐えられない | インスタンス障害には強くなるが、AZ 障害では全台止まる |
| 別の AZ にサブネットを作り、そこにも Web サーバーを置く | 耐えられる | 片方の AZ が止まっても、もう片方が応答する |
| 別の AZ にデータベースのスタンバイを置く | 耐えられる | プライマリの AZ が止まっても、スタンバイに切り替わる |
 クラウドおさる
同じ山に倉庫を 2 つ建てても、山が崩れれば 2 つとも埋まるでござる。増やすべきは倉庫の数ではなく、倉庫を置く山の数でござるな。
層ごとに使う仕組み
2 層構成を複数 AZ に広げるときは、層ごとに使う仕組みが違います。
| 層 | 使う仕組み | 複数 AZ に広げると何が起きるか |
|---|---|---|
| 入口 | Application Load Balancer | 有効にした AZ のターゲットにだけリクエストを振り分ける。ALB は 2 つ以上の AZ を有効にする必要がある |
| Web 層 | EC2 Auto Scaling グループ | 有効な AZ ごとにインスタンス数をそろえようとする。AZ が止まると、残った AZ でインスタンスを起動し直す |
| データベース層 | RDS マルチ AZ 配置 | 別の AZ に同期レプリケーションのスタンバイを置き、障害時に自動で切り替える |
| ネットワーク | 各 AZ のパブリック・プライベートサブネット | 層ごとに、使う AZ のぶんだけサブネットを用意する |
Web 層の EC2 にデータベースを自分で入れて別の AZ に移す、といった方法もありますが、レプリケーションや切り替えを自前で作ることになります。データベースはプライベートサブネットに置いたまま、RDS のマルチ AZ 配置に任せるのが手堅い選択です。
ALB と Auto Scaling グループを AZ にまたがらせる
Auto Scaling グループに AZ を足すときは、グループに別の AZ のサブネットを追加します。追加すると、Auto Scaling は AZ ごとのインスタンス数がそろうように再調整します。
- 再調整では、新しいインスタンスを起動してから古いインスタンスを終了するため、再調整中に容量が減らない
- 最大キャパシティに近いときは、再調整のあいだだけ最大キャパシティを一時的に超えることがある(既定では 10% または 1 インスタンスのどちらか大きいほう)
- 以降は、インスタンス数が最も少ない AZ から順に新しいインスタンスを起動する
ALB 側の AZ にも注意が必要です。ALB で有効になっていない AZ にターゲットを登録しても、ALB はそのターゲットにトラフィックを送りません。Auto Scaling グループに足した AZ が、ALB でも有効になっていることを確かめます。
RDS マルチ AZ 配置
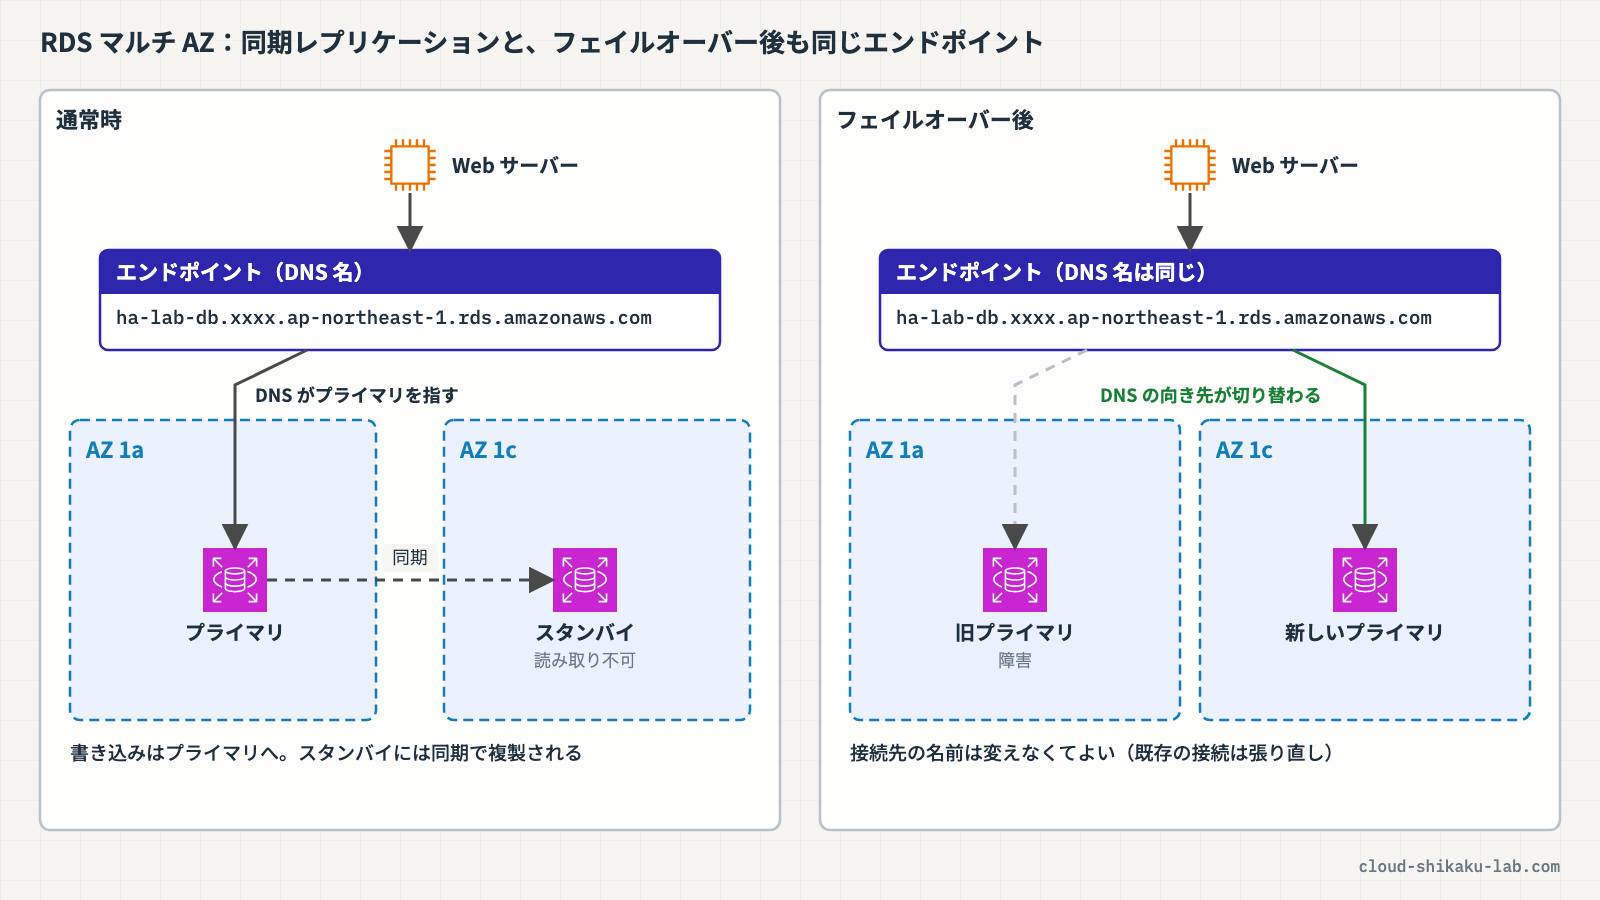
RDS のマルチ AZ 配置(マルチ AZ DB インスタンス)は、プライマリとは別の AZ にスタンバイを置き、同期的にデータを複製します。
| 項目 | 内容 |
|---|---|
| レプリケーション | 同期。そのぶん、シングル AZ より書き込みとコミットの待ち時間が長くなることがある |
| スタンバイの読み取り | できない。読み取りの負荷分散には、リードレプリカかマルチ AZ DB クラスターを使う |
| フェイルオーバー | プライマリの障害時に自動でスタンバイへ切り替わる。所要時間は通常 60〜120 秒 |
| エンドポイント | 切り替え時に DNS レコードがスタンバイを指すように自動で変わる。エンドポイント名は同じだが、既存の接続は張り直しが必要 |
| 手動での切り替え | 再起動するときに「フェイルオーバーで再起動」を選ぶ |
 クラウドおさる
マルチ AZ のスタンバイは「控えの当番」で、普段は門に立たないでござる。読み取りを任せられると思って選ぶと外すのでござるぞ。読み取りを逃がしたいならリードレプリカ、倒れにくくしたいならマルチ AZ でござる。
シングル AZ からマルチ AZ への変換
既存の DB インスタンスは、設定を「変更」するだけでマルチ AZ に変換できます。変換中は次のように進みます。
- プライマリの EBS ボリュームのスナップショットを作る
- スナップショットからスタンバイ用のボリュームを作る(バックグラウンドで初期化される)
- プライマリとスタンバイの間で同期レプリケーションを始める
変換中、DB インスタンスのステータスは「変更中」になりますが、ダウンタイムは最小限に抑えられます。ただし、スタンバイ用ボリュームの初期化中や同期レプリケーションの開始によって、書き込みの多いワークロードではパフォーマンスに影響する可能性があります。変更は「すぐに適用」か、次のメンテナンスウィンドウでの適用を選べます。
実践

1 つの AZ(ap-northeast-1a)だけで動いている Web サーバーと RDS を、ap-northeast-1c にも広げます。Web 層は Auto Scaling グループにサブネットを足し、データベース層は RDS をマルチ AZ に変更してフェイルオーバーを起こします。
前提条件
- リージョン:
ap-northeast-1(東京) - EC2・Auto Scaling・ELB・RDS の操作権限を持つ IAM ユーザーまたはロールでコンソールにログイン済みであること
以下のリソースが作成済みであることを前提とします。Web サーバーは ap-northeast-1a のパブリックサブネットだけで 2 台動いており、RDS はシングル AZ で ap-northeast-1a にあります。
まだ用意していない場合は、「作り方の参考」の記事の手順で作れます。リソース名は、この記事の名前に読み替えてください。
| リソース種別 | リソース名 | 内容 | 作り方の参考 |
|---|---|---|---|
| VPC | ha-lab-vpc | CIDR 10.0.0.0/16 | Amazon VPC で仮想ネットワークを構築しサブネットを設定する ※AZ を 2 つにする |
| パブリックサブネット | ha-lab-public-1a / ha-lab-public-1c | 10.0.1.0/24(1a)/ 10.0.2.0/24(1c)。インターネットゲートウェイへのルートあり | 同上 |
| プライベートサブネット | ha-lab-private-1a / ha-lab-private-1c | 10.0.11.0/24(1a)/ 10.0.12.0/24(1c) | 同上 |
| Application Load Balancer | ha-lab-alb | インターネット向け。ha-lab-public-1a と ha-lab-public-1c で有効。ターゲットグループ ha-lab-tg に転送 | EC2 Auto Scaling で落ちても自動で戻る Web サーバーを作る |
| Auto Scaling グループ | ha-lab-asg | サブネットは ha-lab-public-1a だけ。最小 2・希望 2・最大 4。応答した AZ を表示する Web ページを返す | 同上 ※サブネットを 1a だけにする |
| RDS DB インスタンス | ha-lab-db | MySQL・db.t4g.micro・シングル AZ(ap-northeast-1a)。DB サブネットグループは 2 つのプライベートサブネット | Amazon RDS でデータベースを作成し EC2 から接続する |
ALB・EC2・RDS は起動している間ずっと課金されます。マルチ AZ にした RDS は、スタンバイのぶん料金がおよそ 2 倍になります。検証が終わったら必ず削除してください。
手順 1: いまの構成が 1 つの AZ に寄っていることを確かめる
AWS マネジメントコンソールにログインし、リージョンが ap-northeast-1(東京)であることを確認します。
上部の検索バーに EC2 と入力し、「EC2」を選択します。左側ナビゲーションの「Auto Scaling」→「Auto Scaling グループ」を選択し、ha-lab-asg を開きます。「詳細」タブの「ネットワーク」で、アベイラビリティーゾーンが ap-northeast-1a の 1 つだけであることを確認します(ここにはサブネット名ではなく、AZ とサブネット ID が表示されます)。
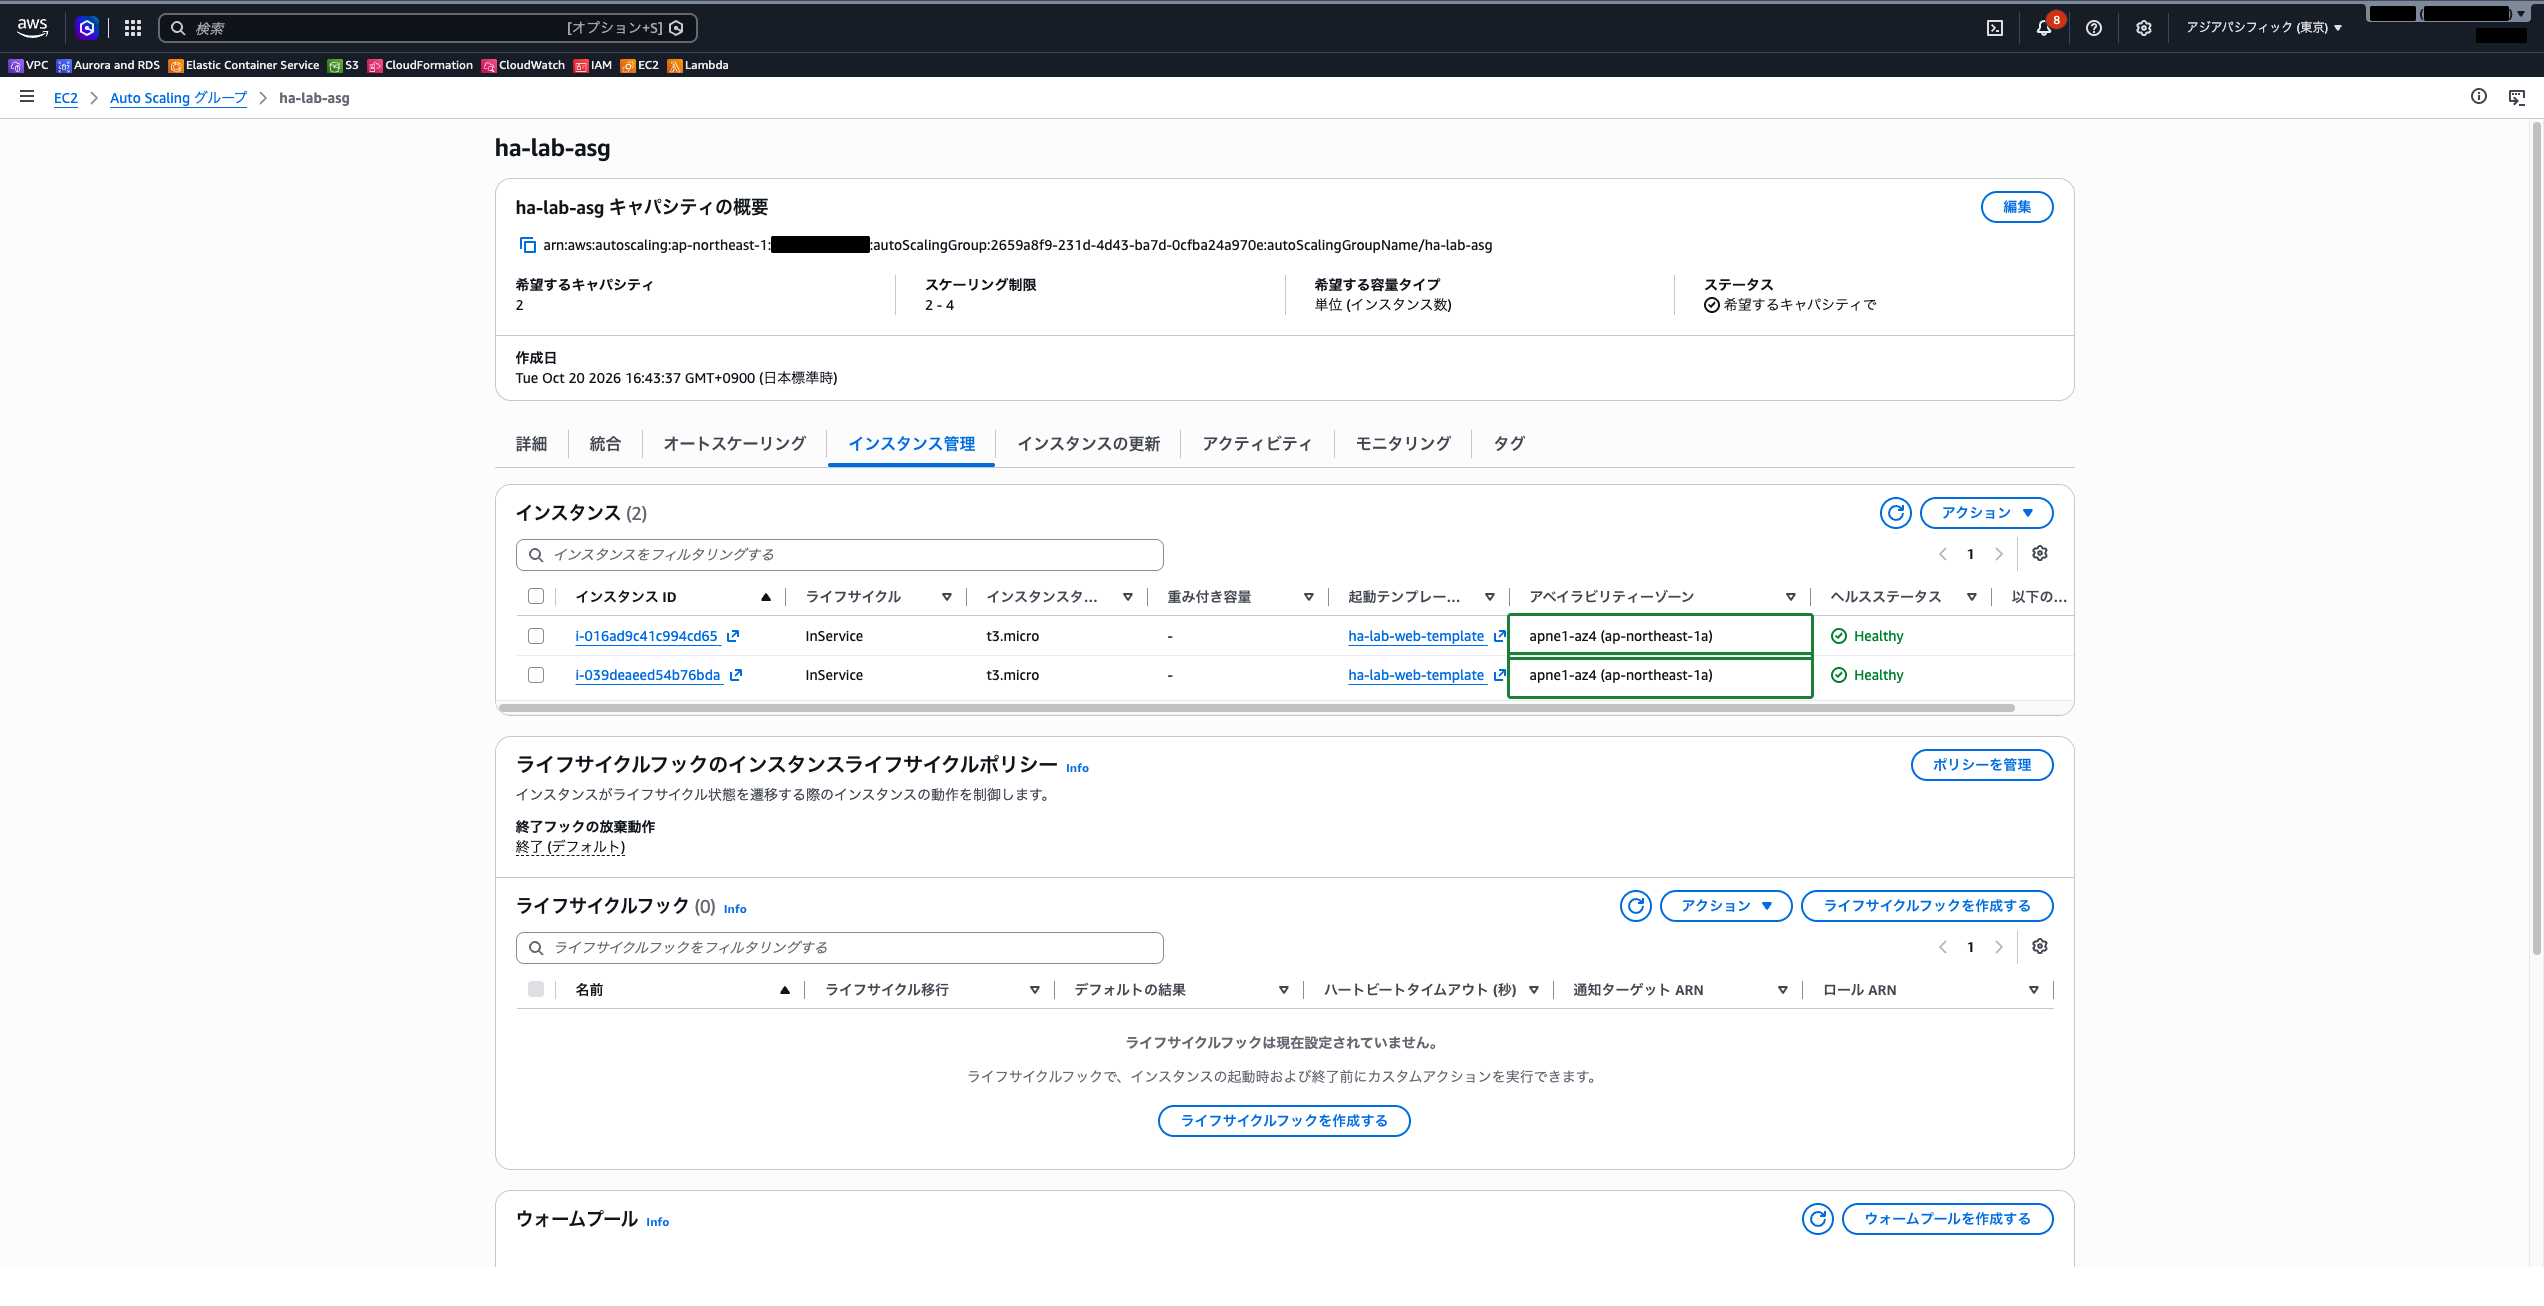
続けて「インスタンス管理」タブを開き、2 台のインスタンスのアベイラビリティーゾーンがどちらも ap-northeast-1a であることを確認します。AZ は apne1-az4 (ap-northeast-1a) のように、AZ ID と並べて表示されます。
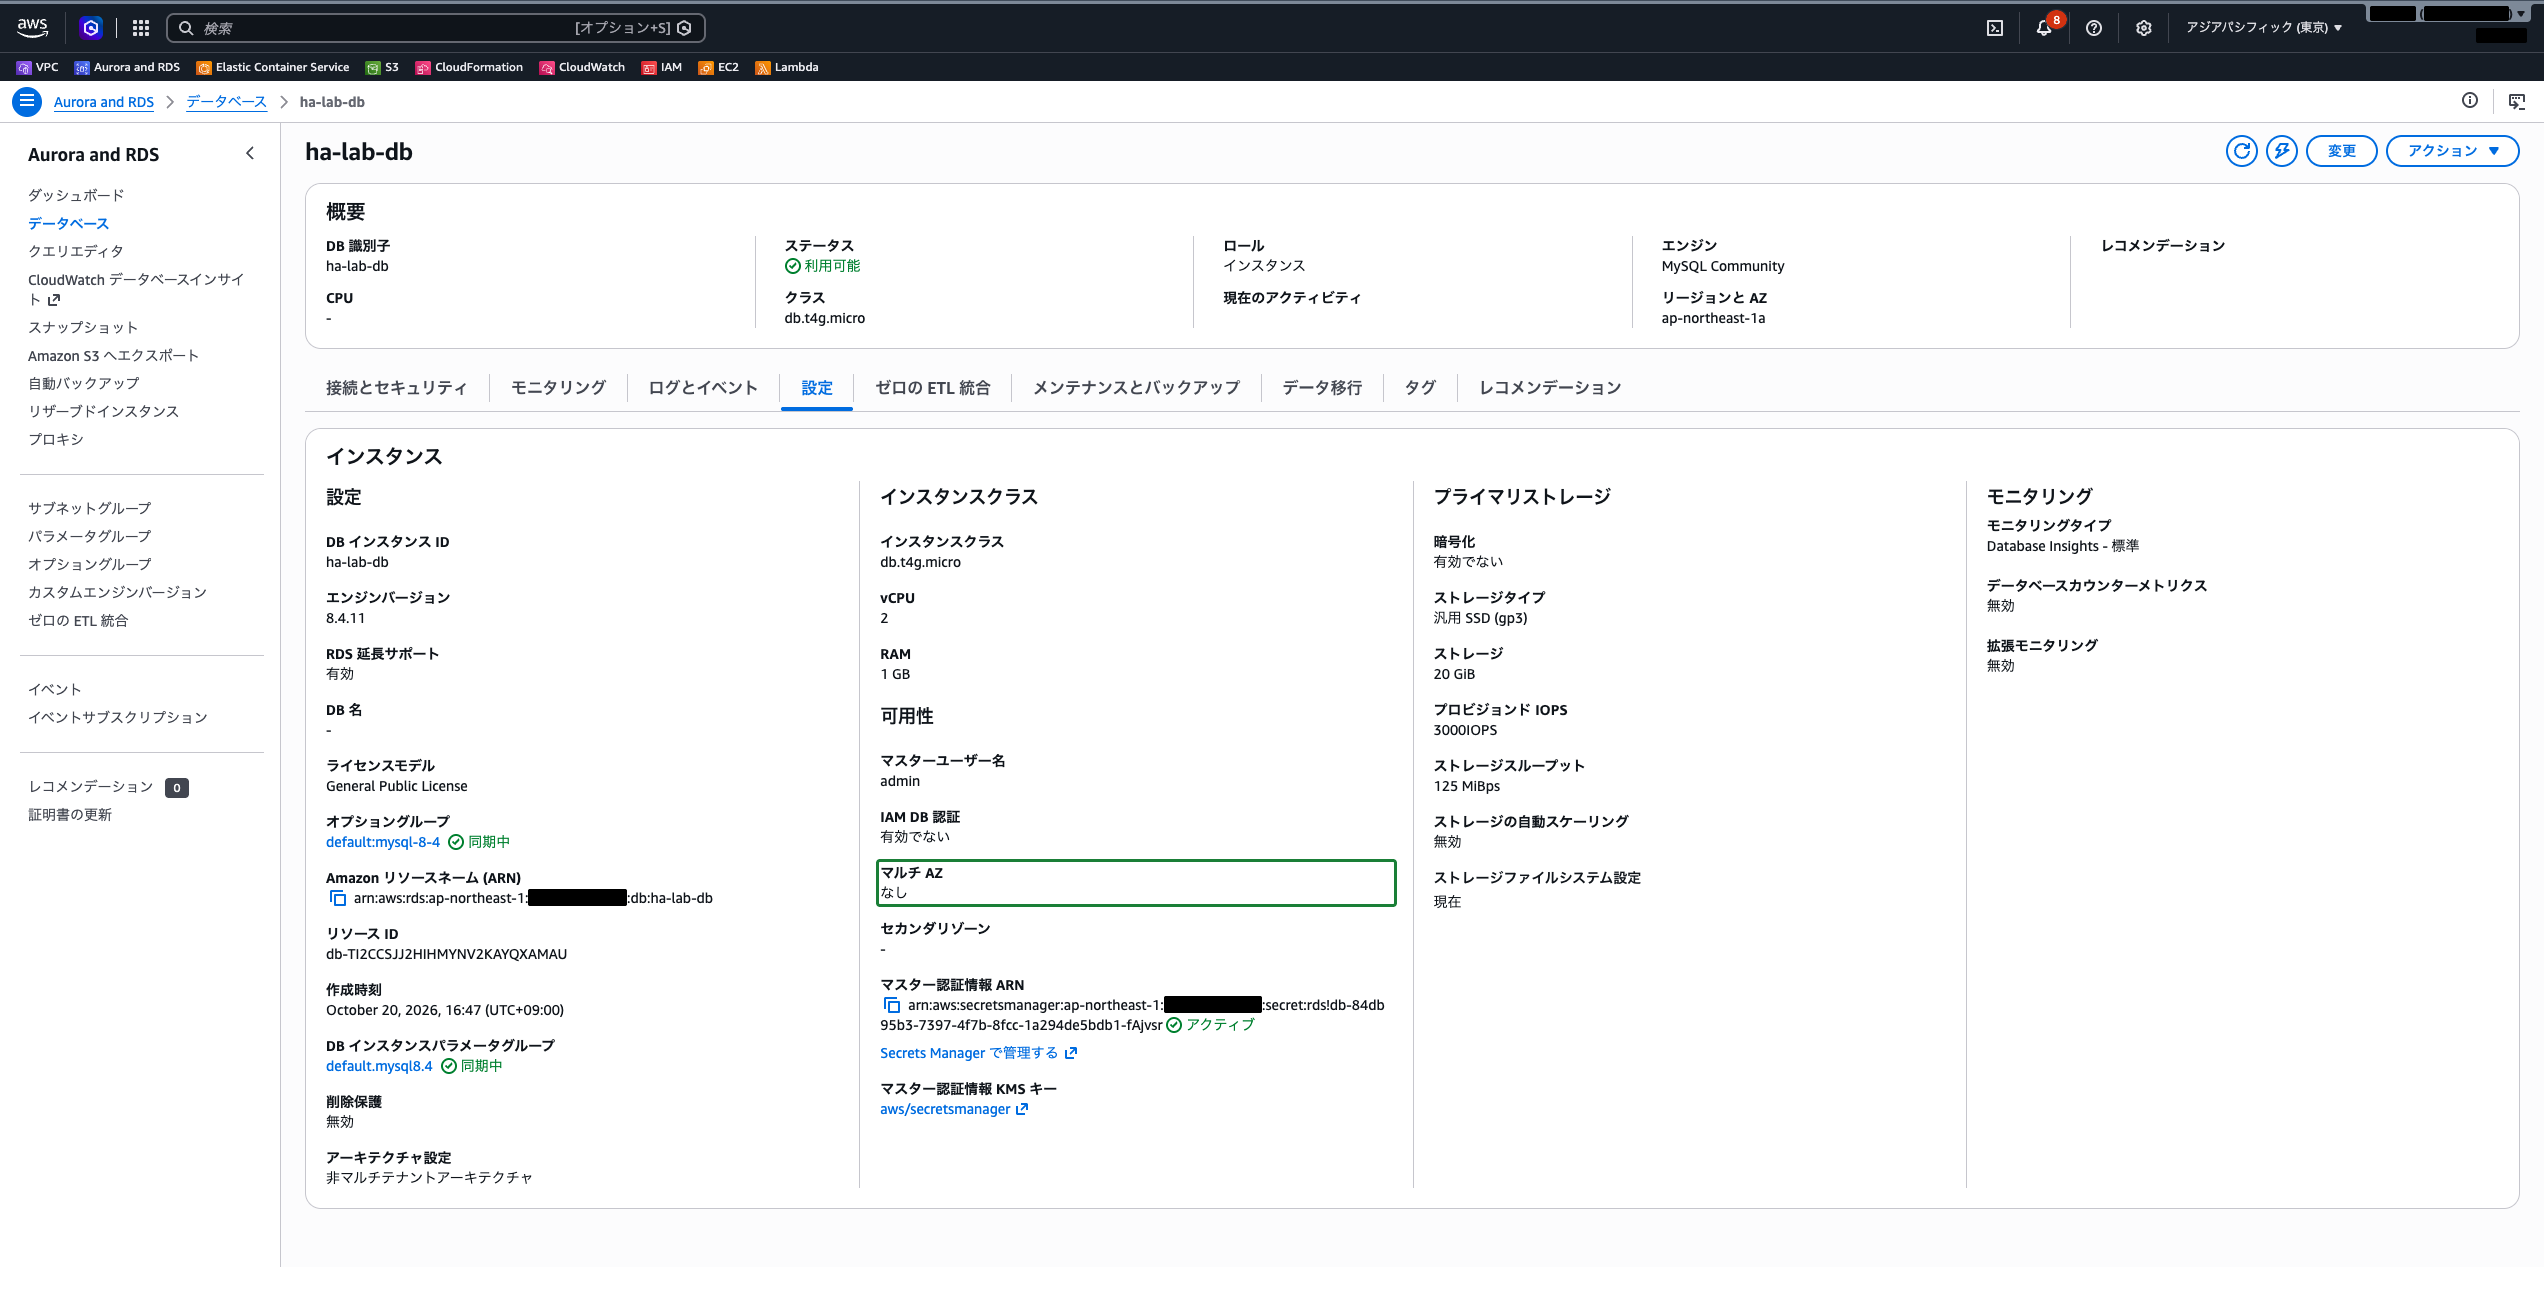
上部の検索バーに RDS と入力し、「Aurora and RDS」を選択します。左側ナビゲーションの「データベース」から ha-lab-db を開き、画面上部の概要の「リージョンと AZ」が ap-northeast-1a、「設定」タブの「可用性」にある「マルチ AZ」が なし、「セカンダリゾーン」が - であることを確認します。
あわせて「接続とセキュリティ」タブを開き、「を使用して接続」で エンドポイント を選択します。「エンドポイントとポート」に表示されるエンドポイントの値を控えておきます。
手順 2: Auto Scaling グループに 2 つ目の AZ を足す
EC2 コンソールの「Auto Scaling グループ」に戻り、ha-lab-asg の「詳細」タブで「ネットワーク」の「編集」をクリックします。
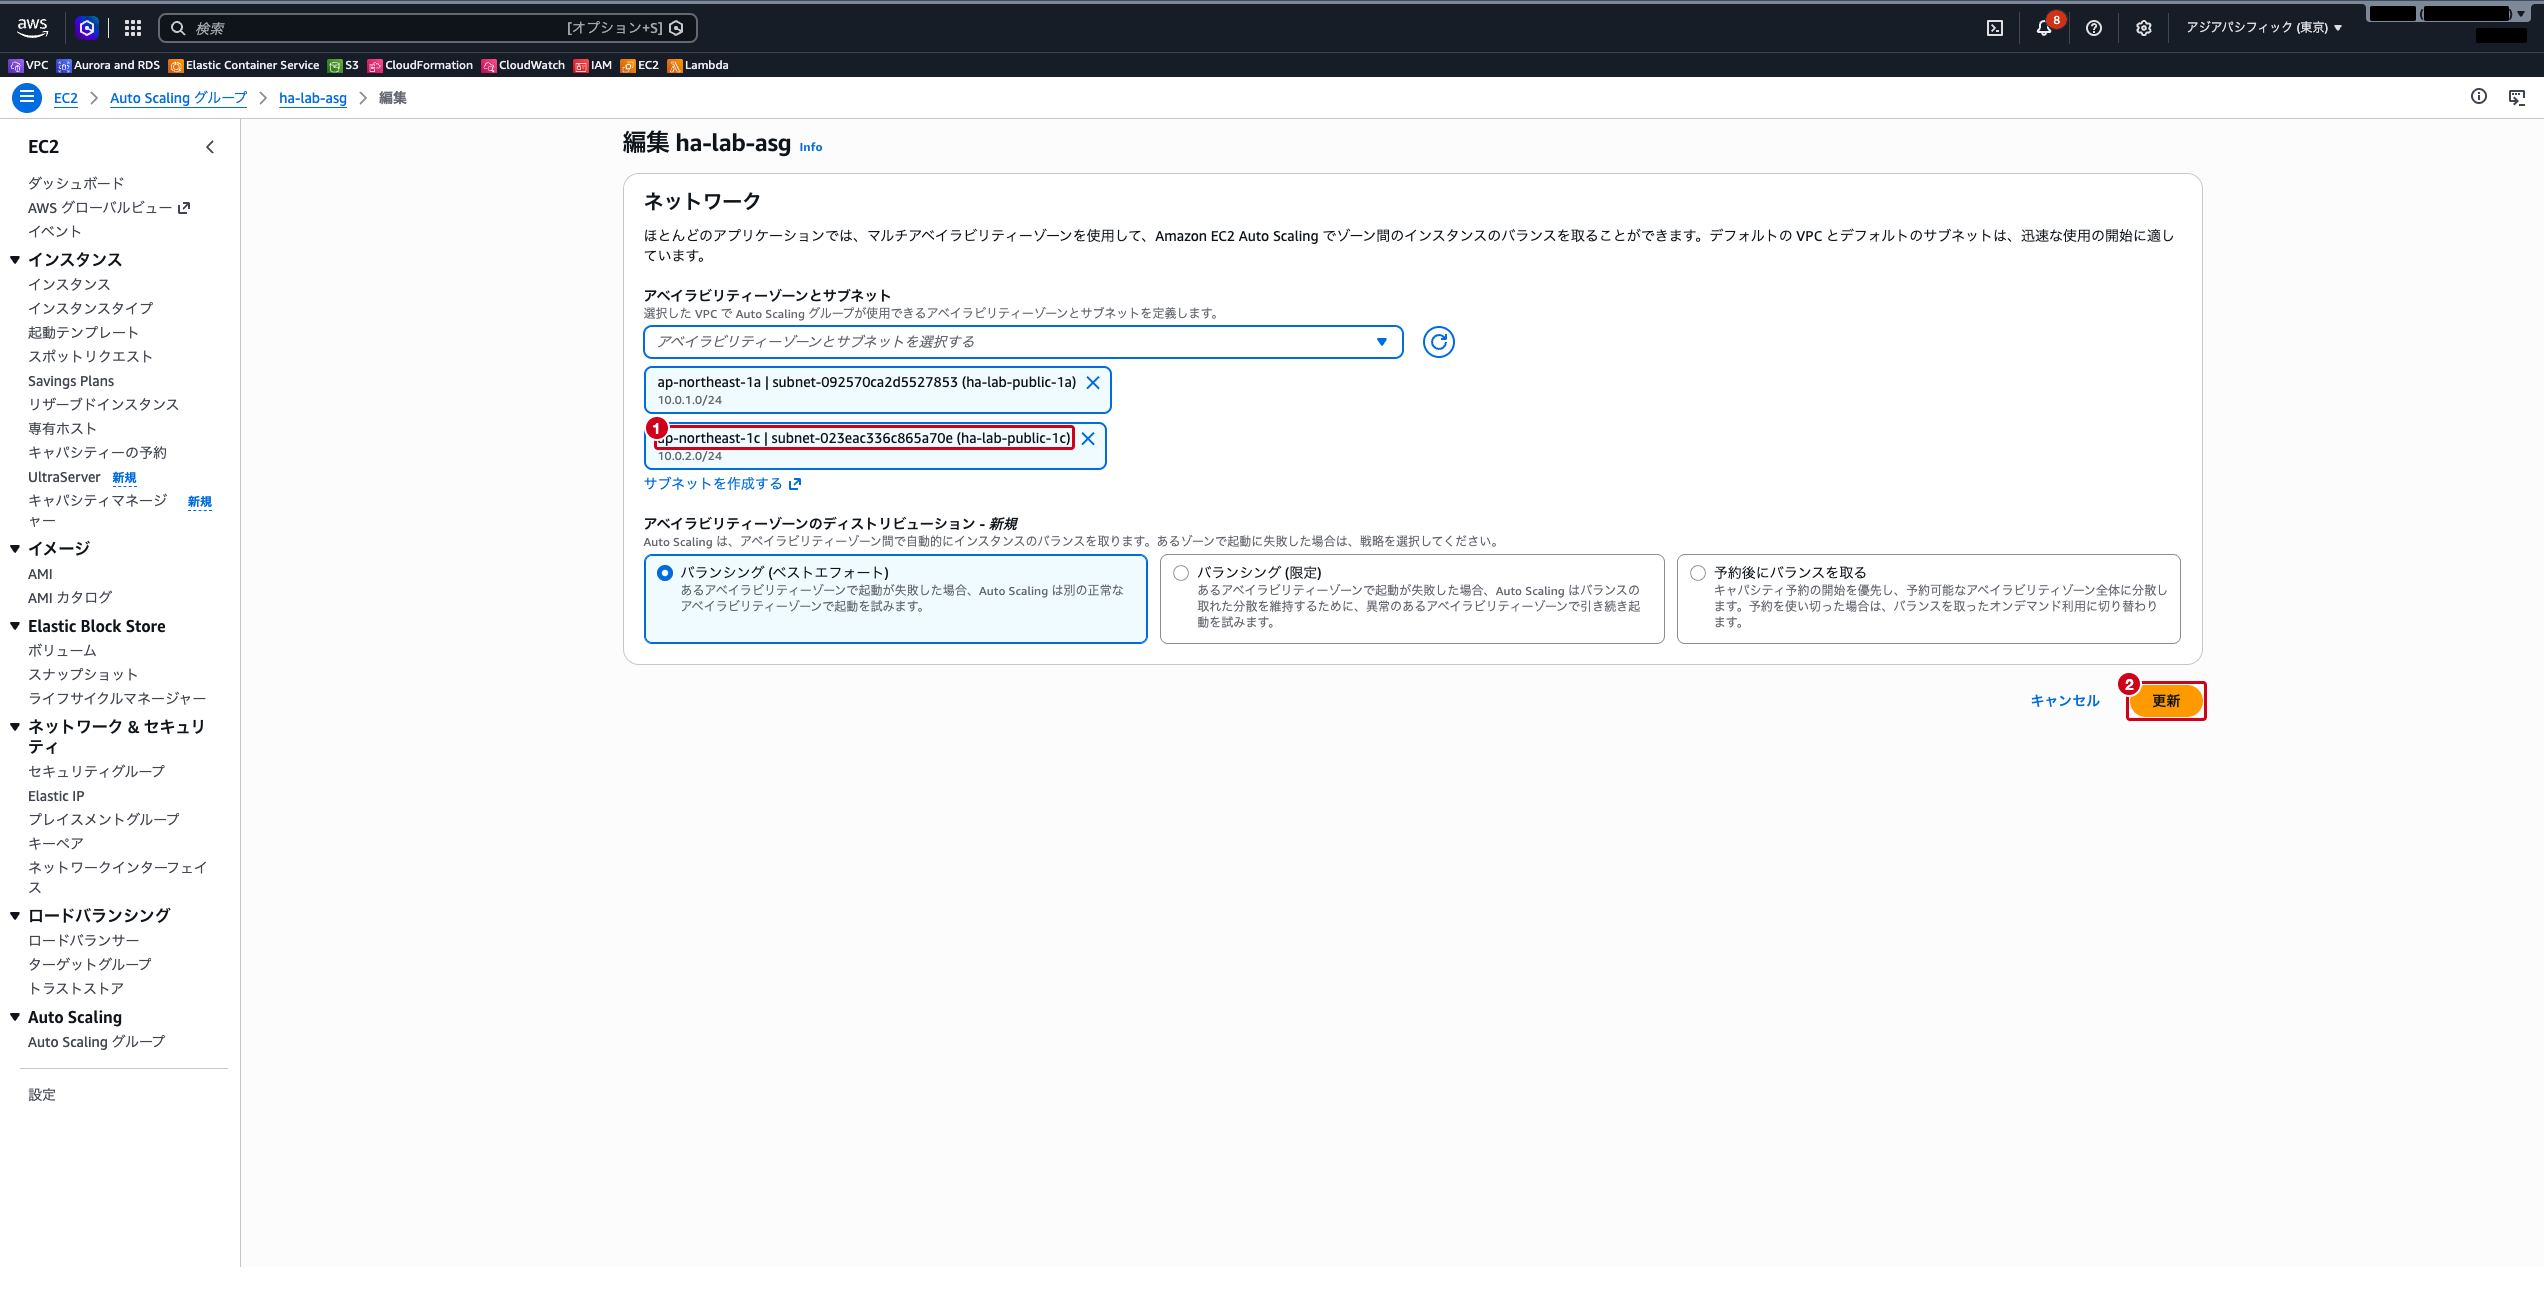
「アベイラビリティーゾーンとサブネット」で ha-lab-public-1c を追加します。一覧には他の VPC のサブネットも並ぶので、名前で選びます。その下の「アベイラビリティーゾーンのディストリビューション」はデフォルトのままにして、「更新」をクリックします。
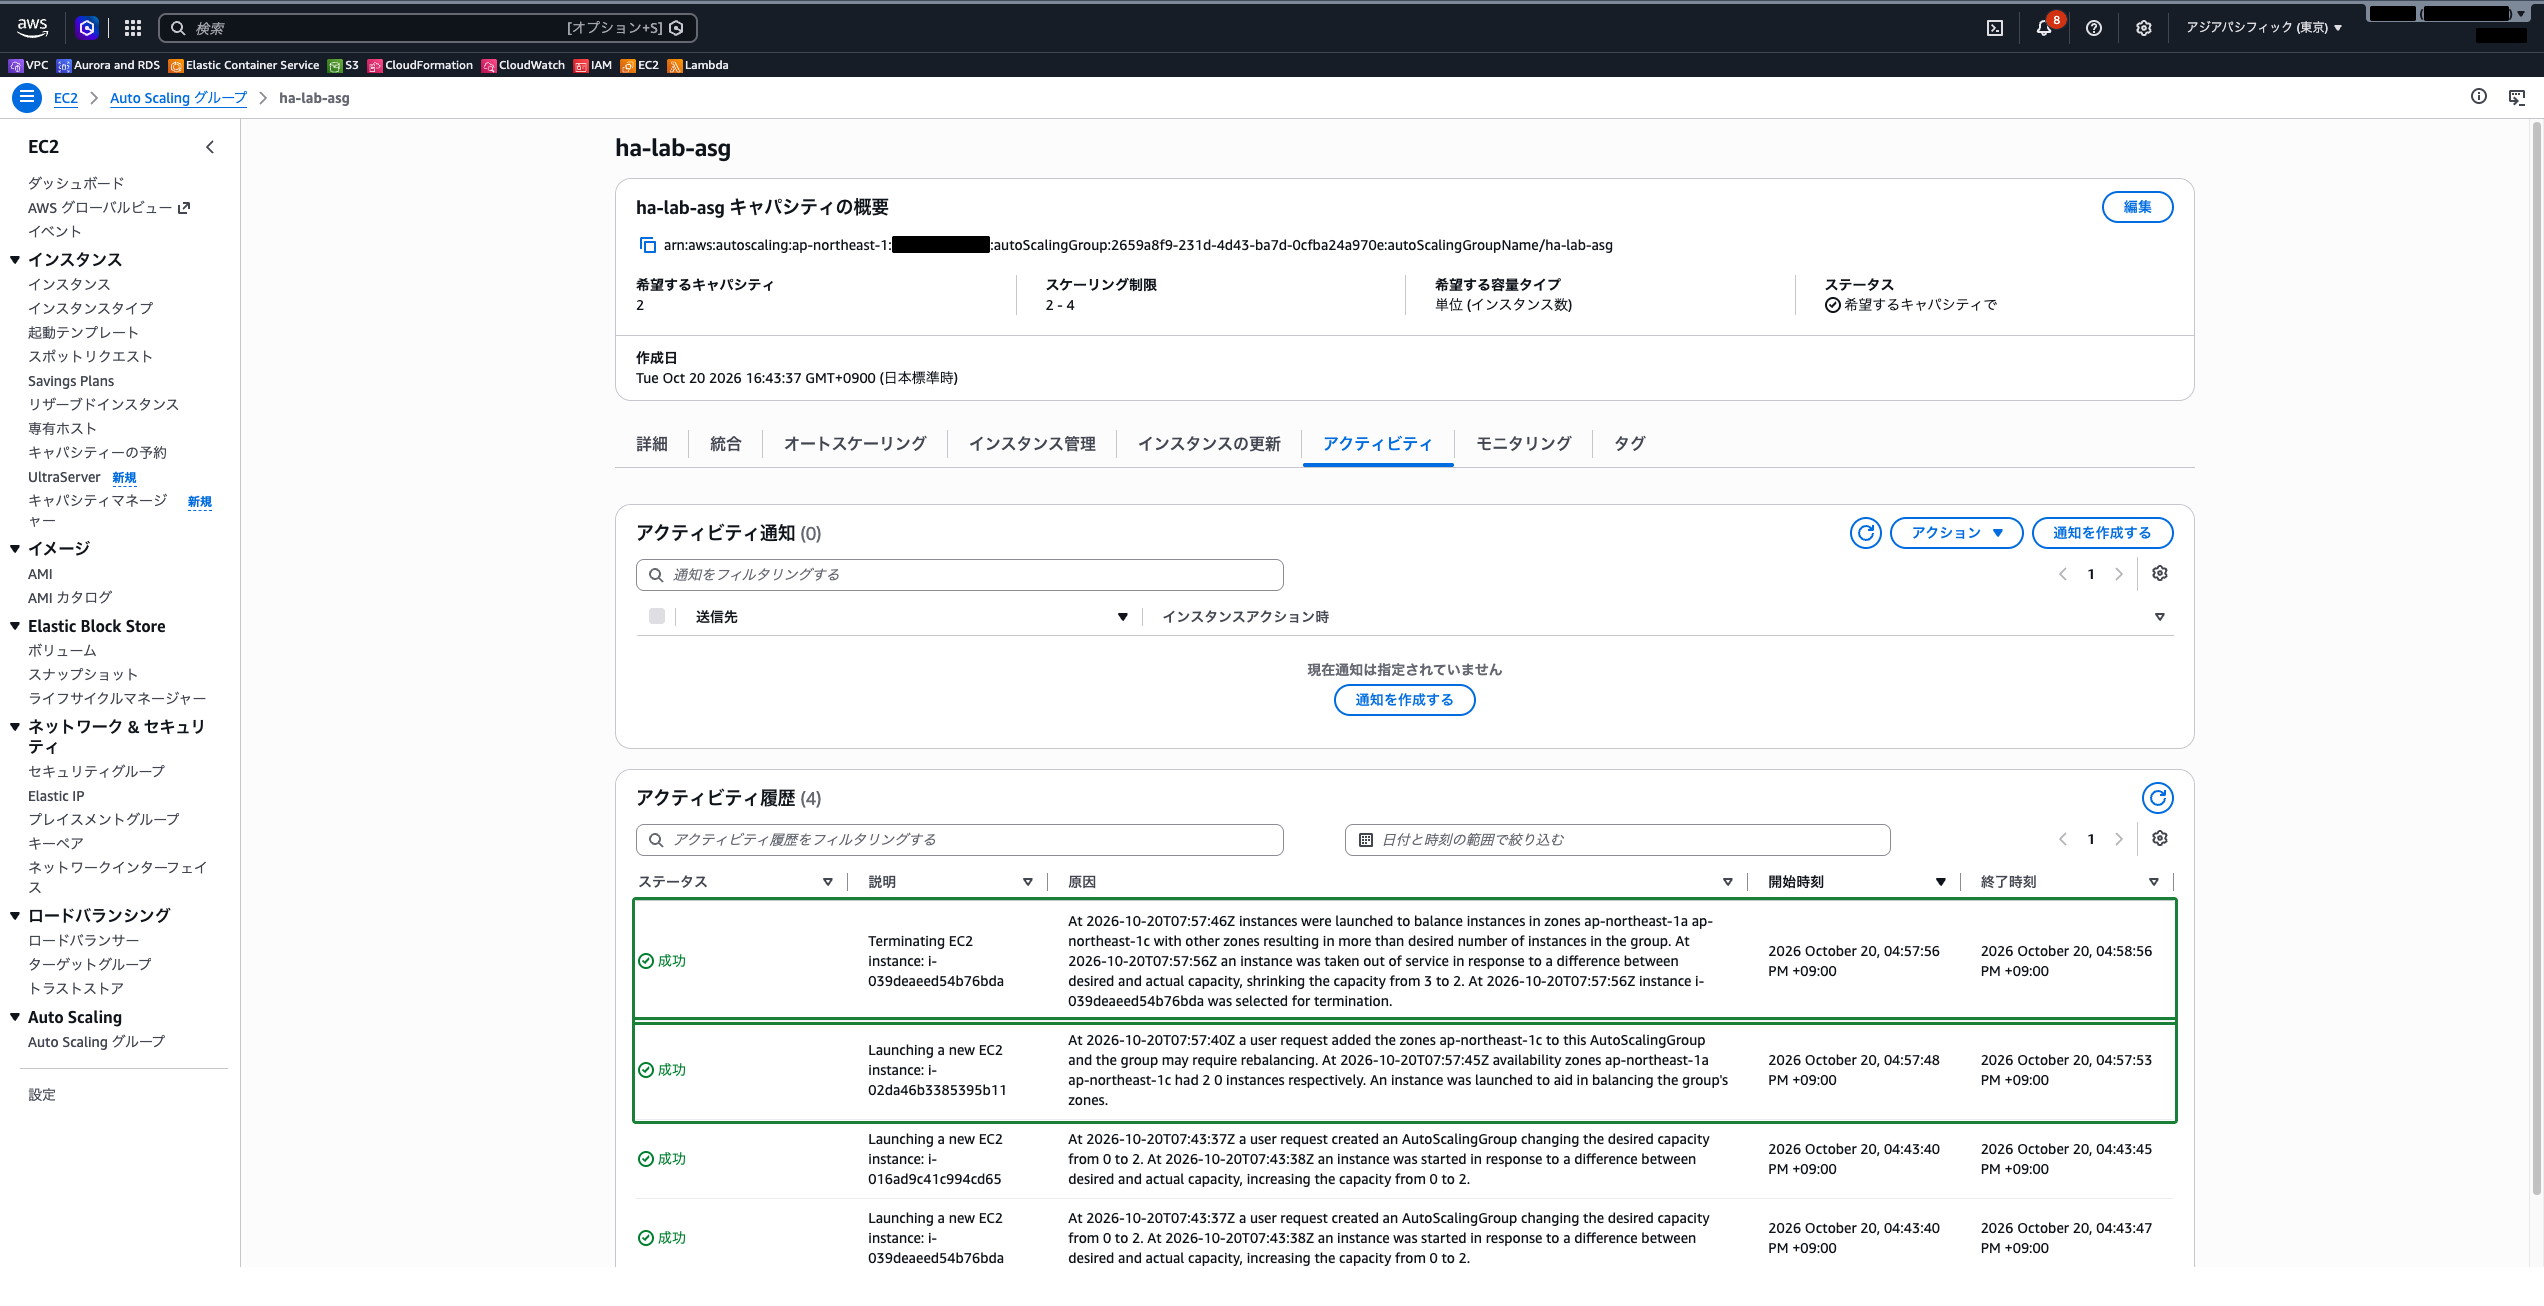
「アクティビティ」タブを開きます。10 秒ほどで、ap-northeast-1c で新しいインスタンスが起動し、そのあとで ap-northeast-1a のインスタンスが 1 台終了する履歴が並びます(説明の欄は Launching a new EC2 instance: … のように英語で表示されます)。新しいインスタンスを先に起動してから古いインスタンスを終了する、再調整の動きです。
手順 3: 2 つの AZ のサーバーが応答していることを確かめる
「インスタンス管理」タブで、インスタンスが ap-northeast-1a と ap-northeast-1c に 1 台ずつになったことを確認します。
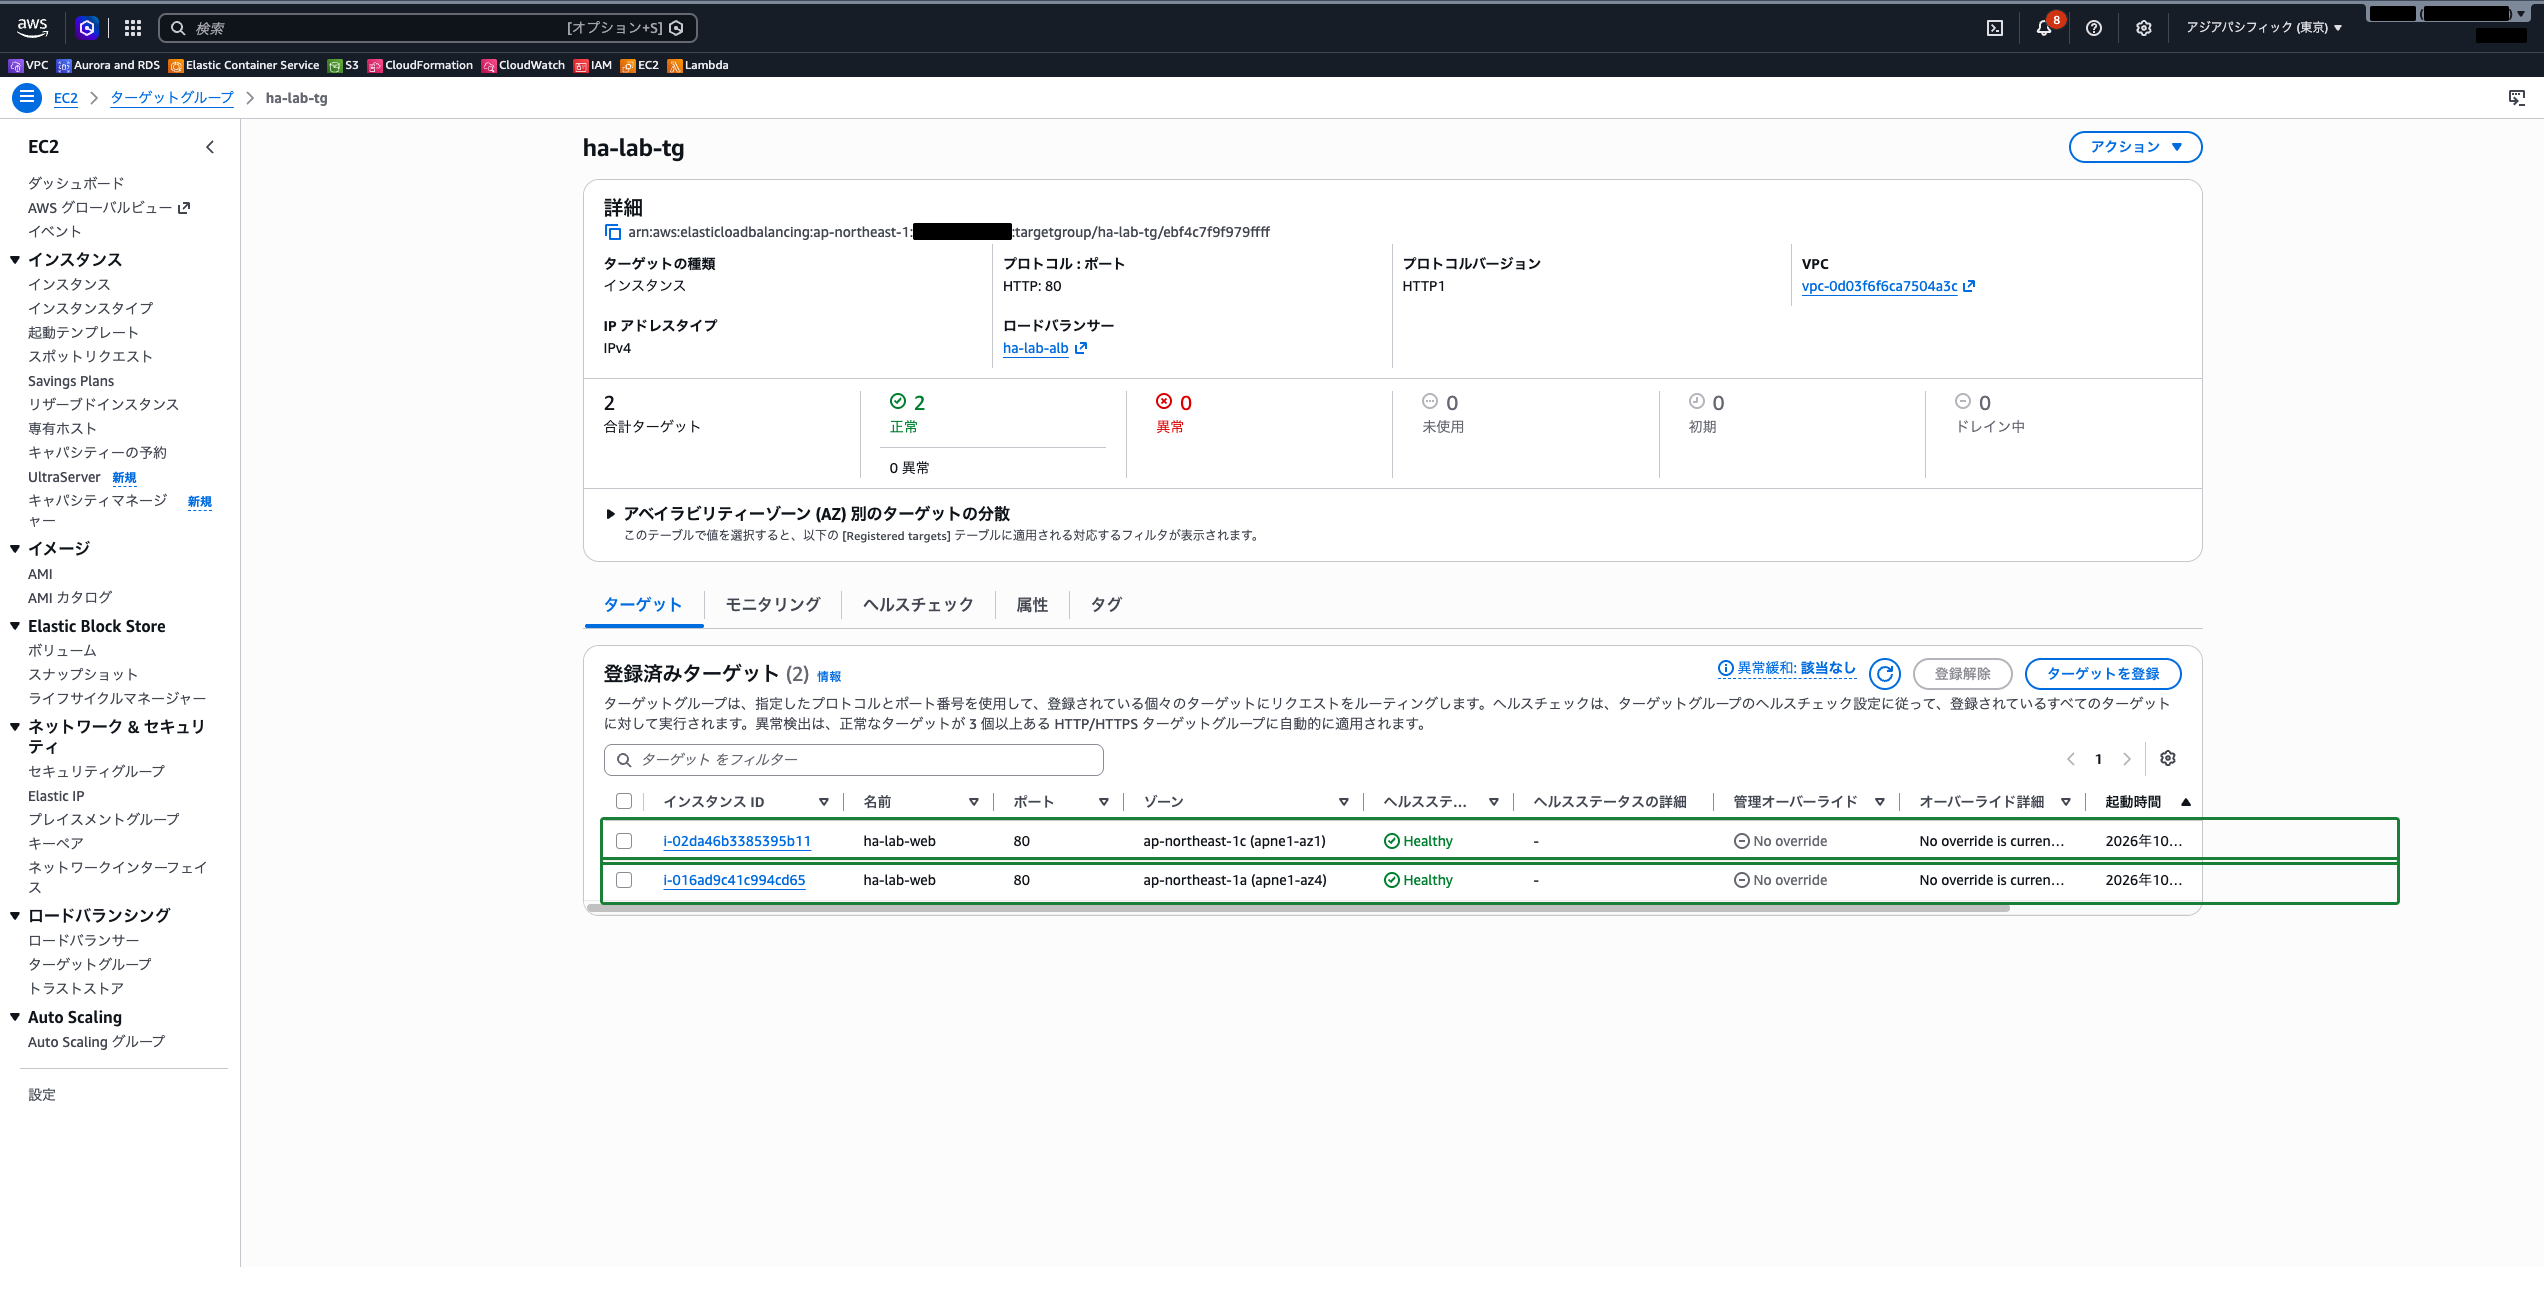
左側ナビゲーションの「ロードバランシング」→「ターゲットグループ」から ha-lab-tg を開き、「ターゲット」タブで 2 台とも Healthy で、アベイラビリティーゾーンが分かれていることを確認します。
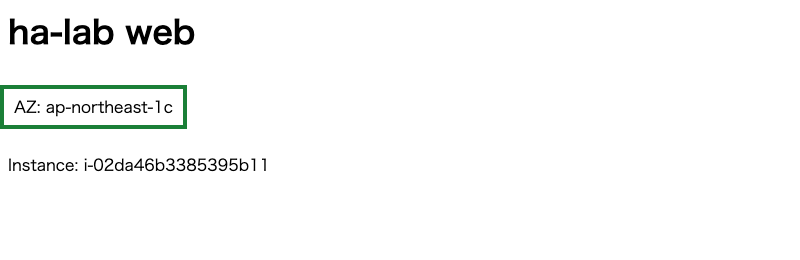
左側ナビゲーションの「ロードバランサー」から ha-lab-alb を開き、「DNS 名」をコピーしてブラウザの新しいタブで開きます。何度か再読み込みすると、表示される AZ が ap-northeast-1a と ap-northeast-1c で入れ替わります。ブラウザが同じ接続を使い回すと同じ AZ が続くことがあるので、そのときは少し時間をおくか、別のタブで開き直します。
手順 4: RDS をマルチ AZ に変更する
RDS コンソールの「データベース」で ha-lab-db を選択し、「変更」をクリックします。
「可用性と耐久性」の「マルチ AZ 配置」で スタンバイインスタンスを作成する (本稼働環境向けに推奨) を選択します。その他の項目はデフォルトのままにして、ページ下部の「続行」をクリックします。
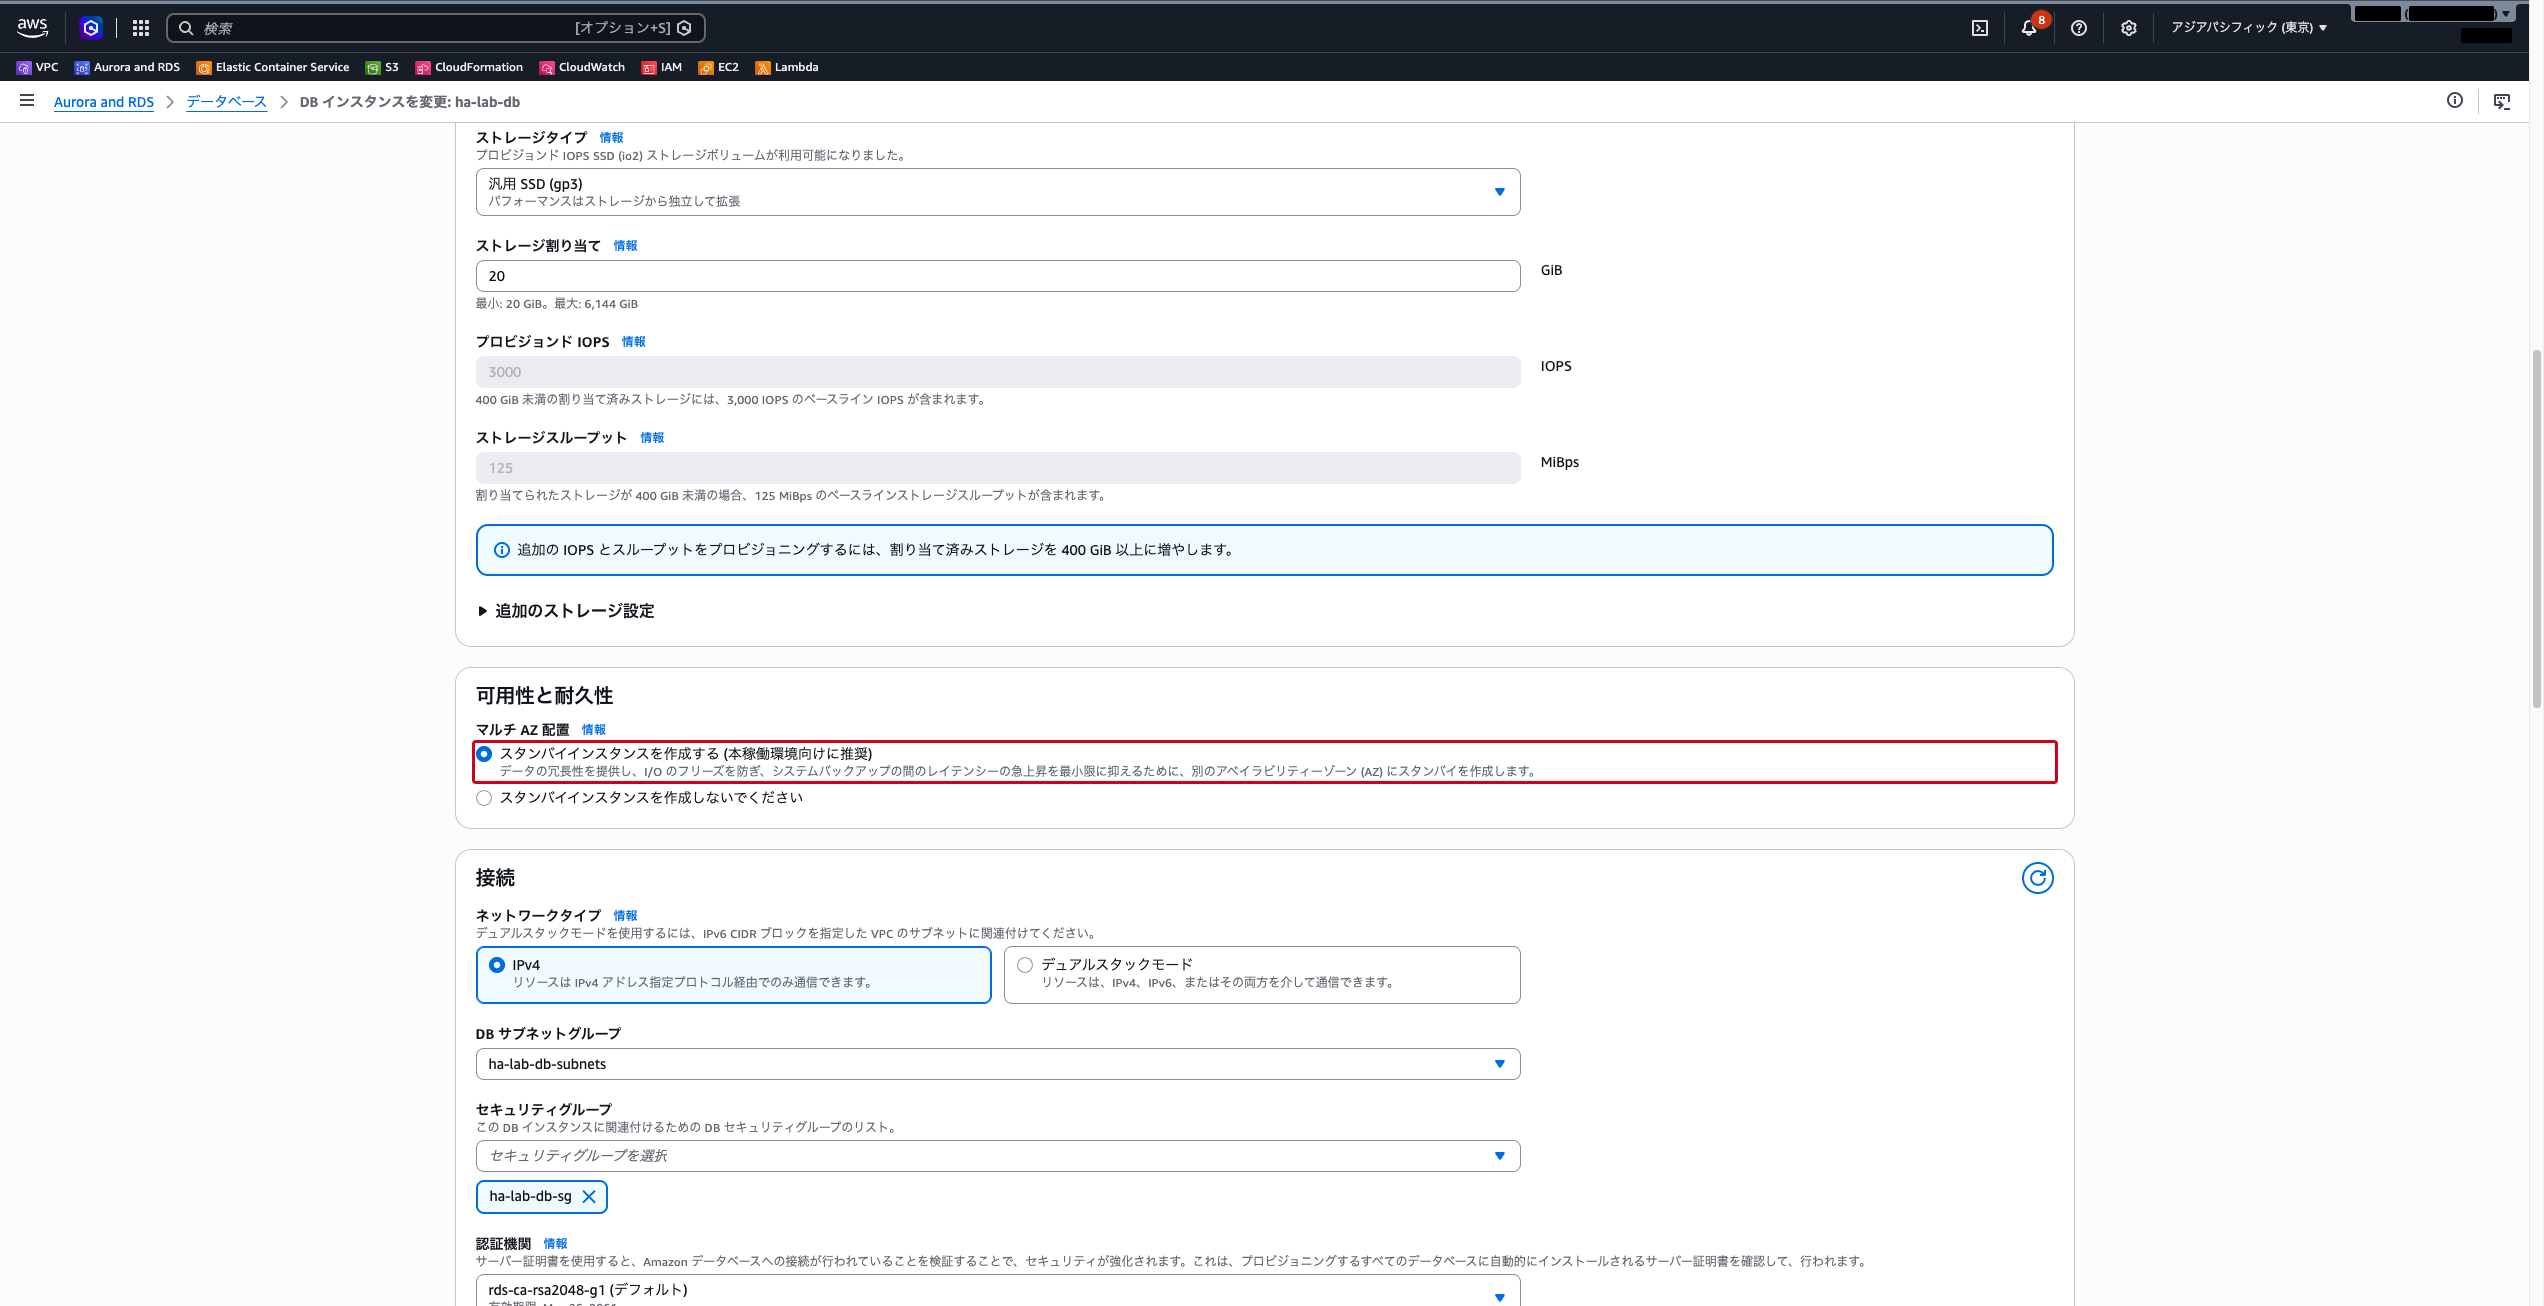
「変更のサマリー」画面に、マルチ AZ 配置の現在の値 なし と新しい値 あり が表示されます。変換中は性能に影響が出ることがある、という注意もここに表示されます。「変更のスケジュール」の既定は 次回の定期メンテナンス期間中に適用 なので、すぐに適用 を選び直してから「DB インスタンスを変更」をクリックします。ステータスが「変更中」になり、10 分前後で「利用可能」に戻ります(DB のサイズによって変わります)。
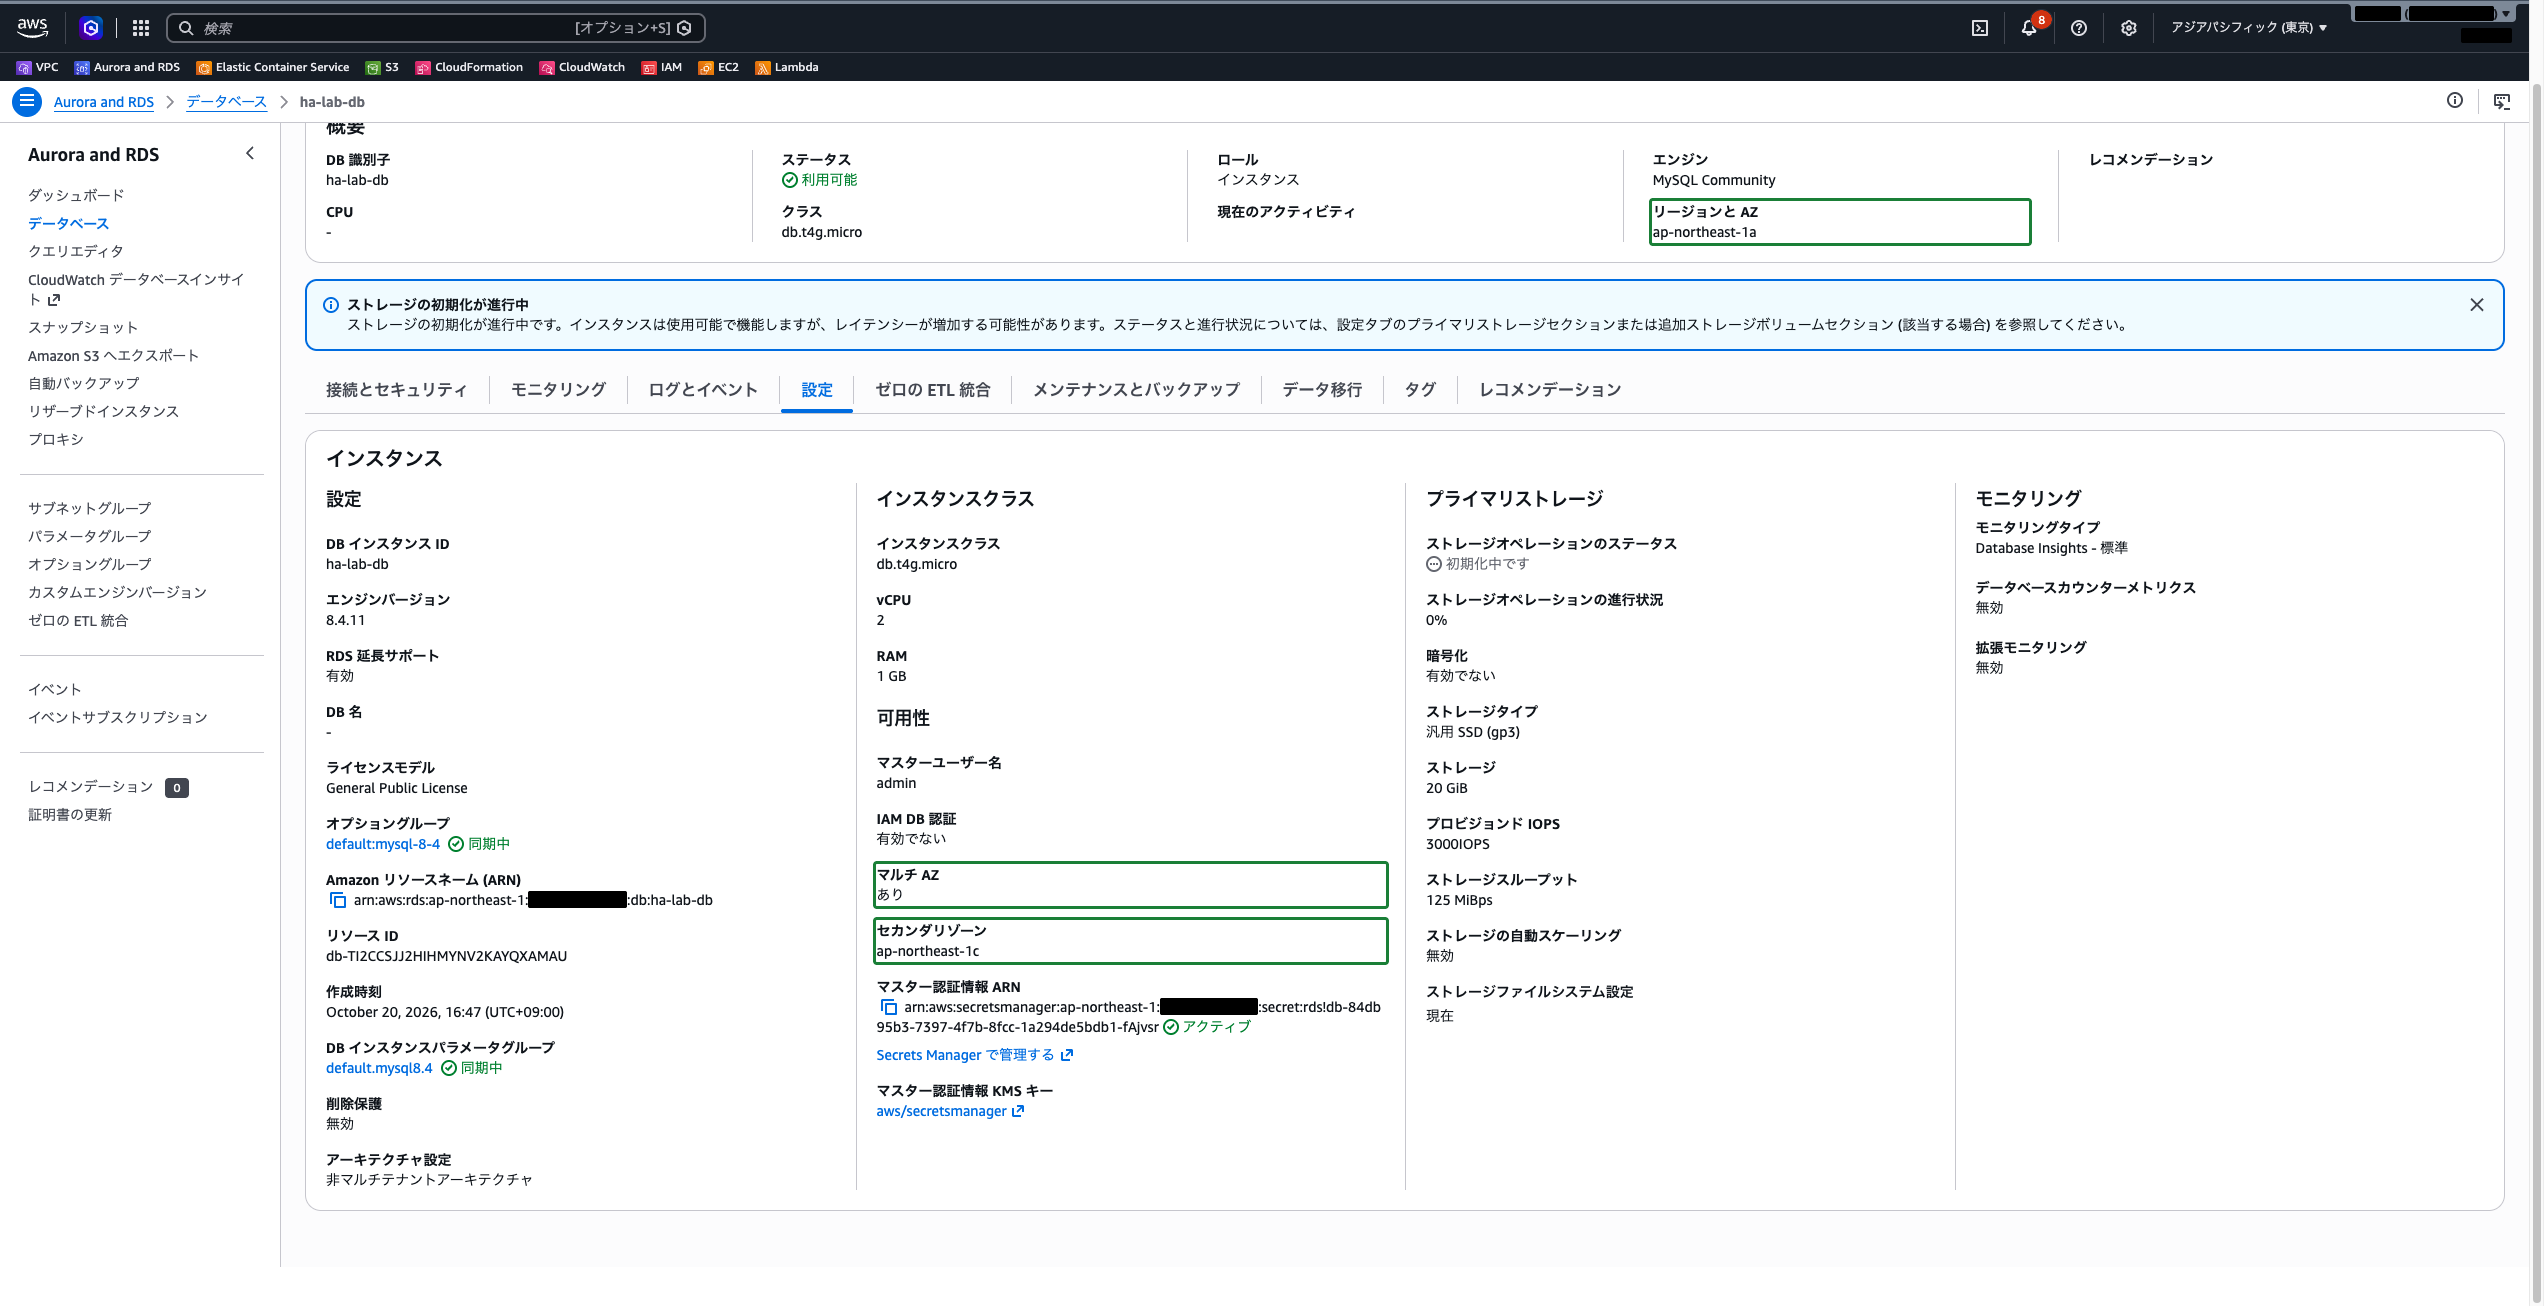
ステータスが「利用可能」に戻ったら、「設定」タブの「可用性」で「マルチ AZ」が あり、「セカンダリゾーン」が ap-northeast-1c になっていることを確認します。プライマリは概要の「リージョンと AZ」のとおり ap-northeast-1a のままです。変換の直後は「ストレージの初期化が進行中」と表示され、セカンダリゾーンが表示されるまで少し時間がかかることがあります。
 クラウドおさる
Web 層は「新しい当番を先に呼んでから交代」、データベース層は「控えの当番を隣の山に置いて同期」でござる。層ごとに分身の置き方が違うのでござるな。
手順 5: フェイルオーバーを起こしてエンドポイントが変わらないことを確かめる
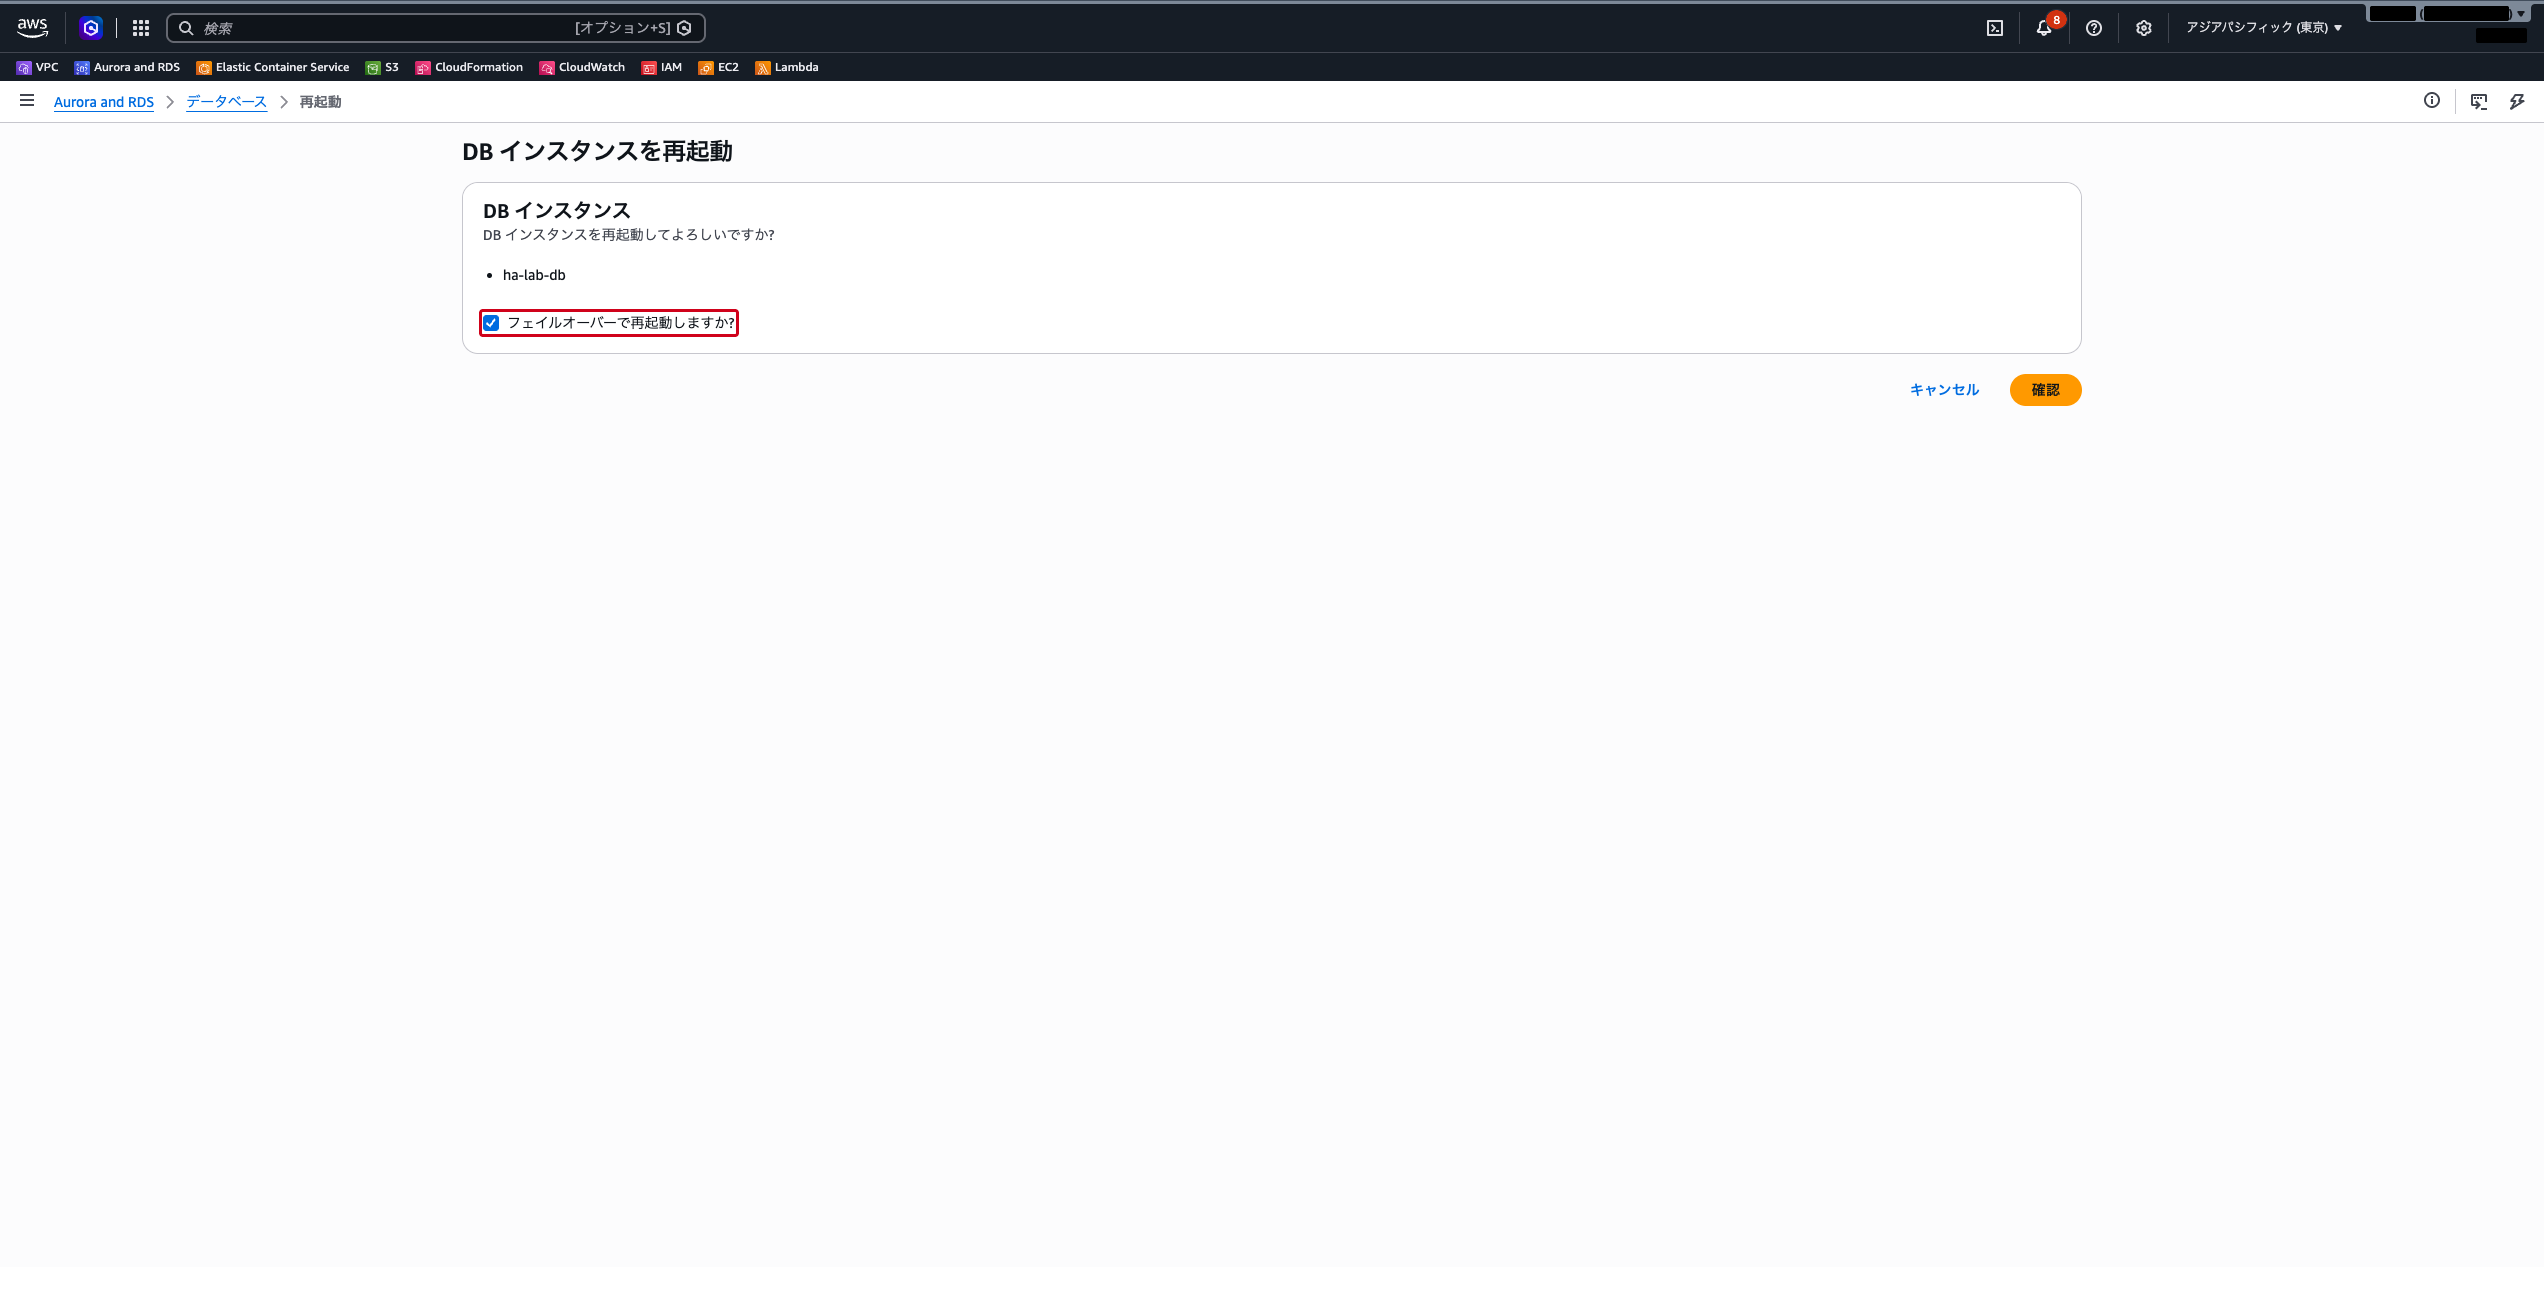
ha-lab-db を選択し、「アクション」→「再起動」をクリックします。「DB インスタンスを再起動」の画面で「フェイルオーバーで再起動しますか?」にチェックを入れ、「確認」をクリックします。データベースの一覧に戻り、ステータスが「再起動中」になります。
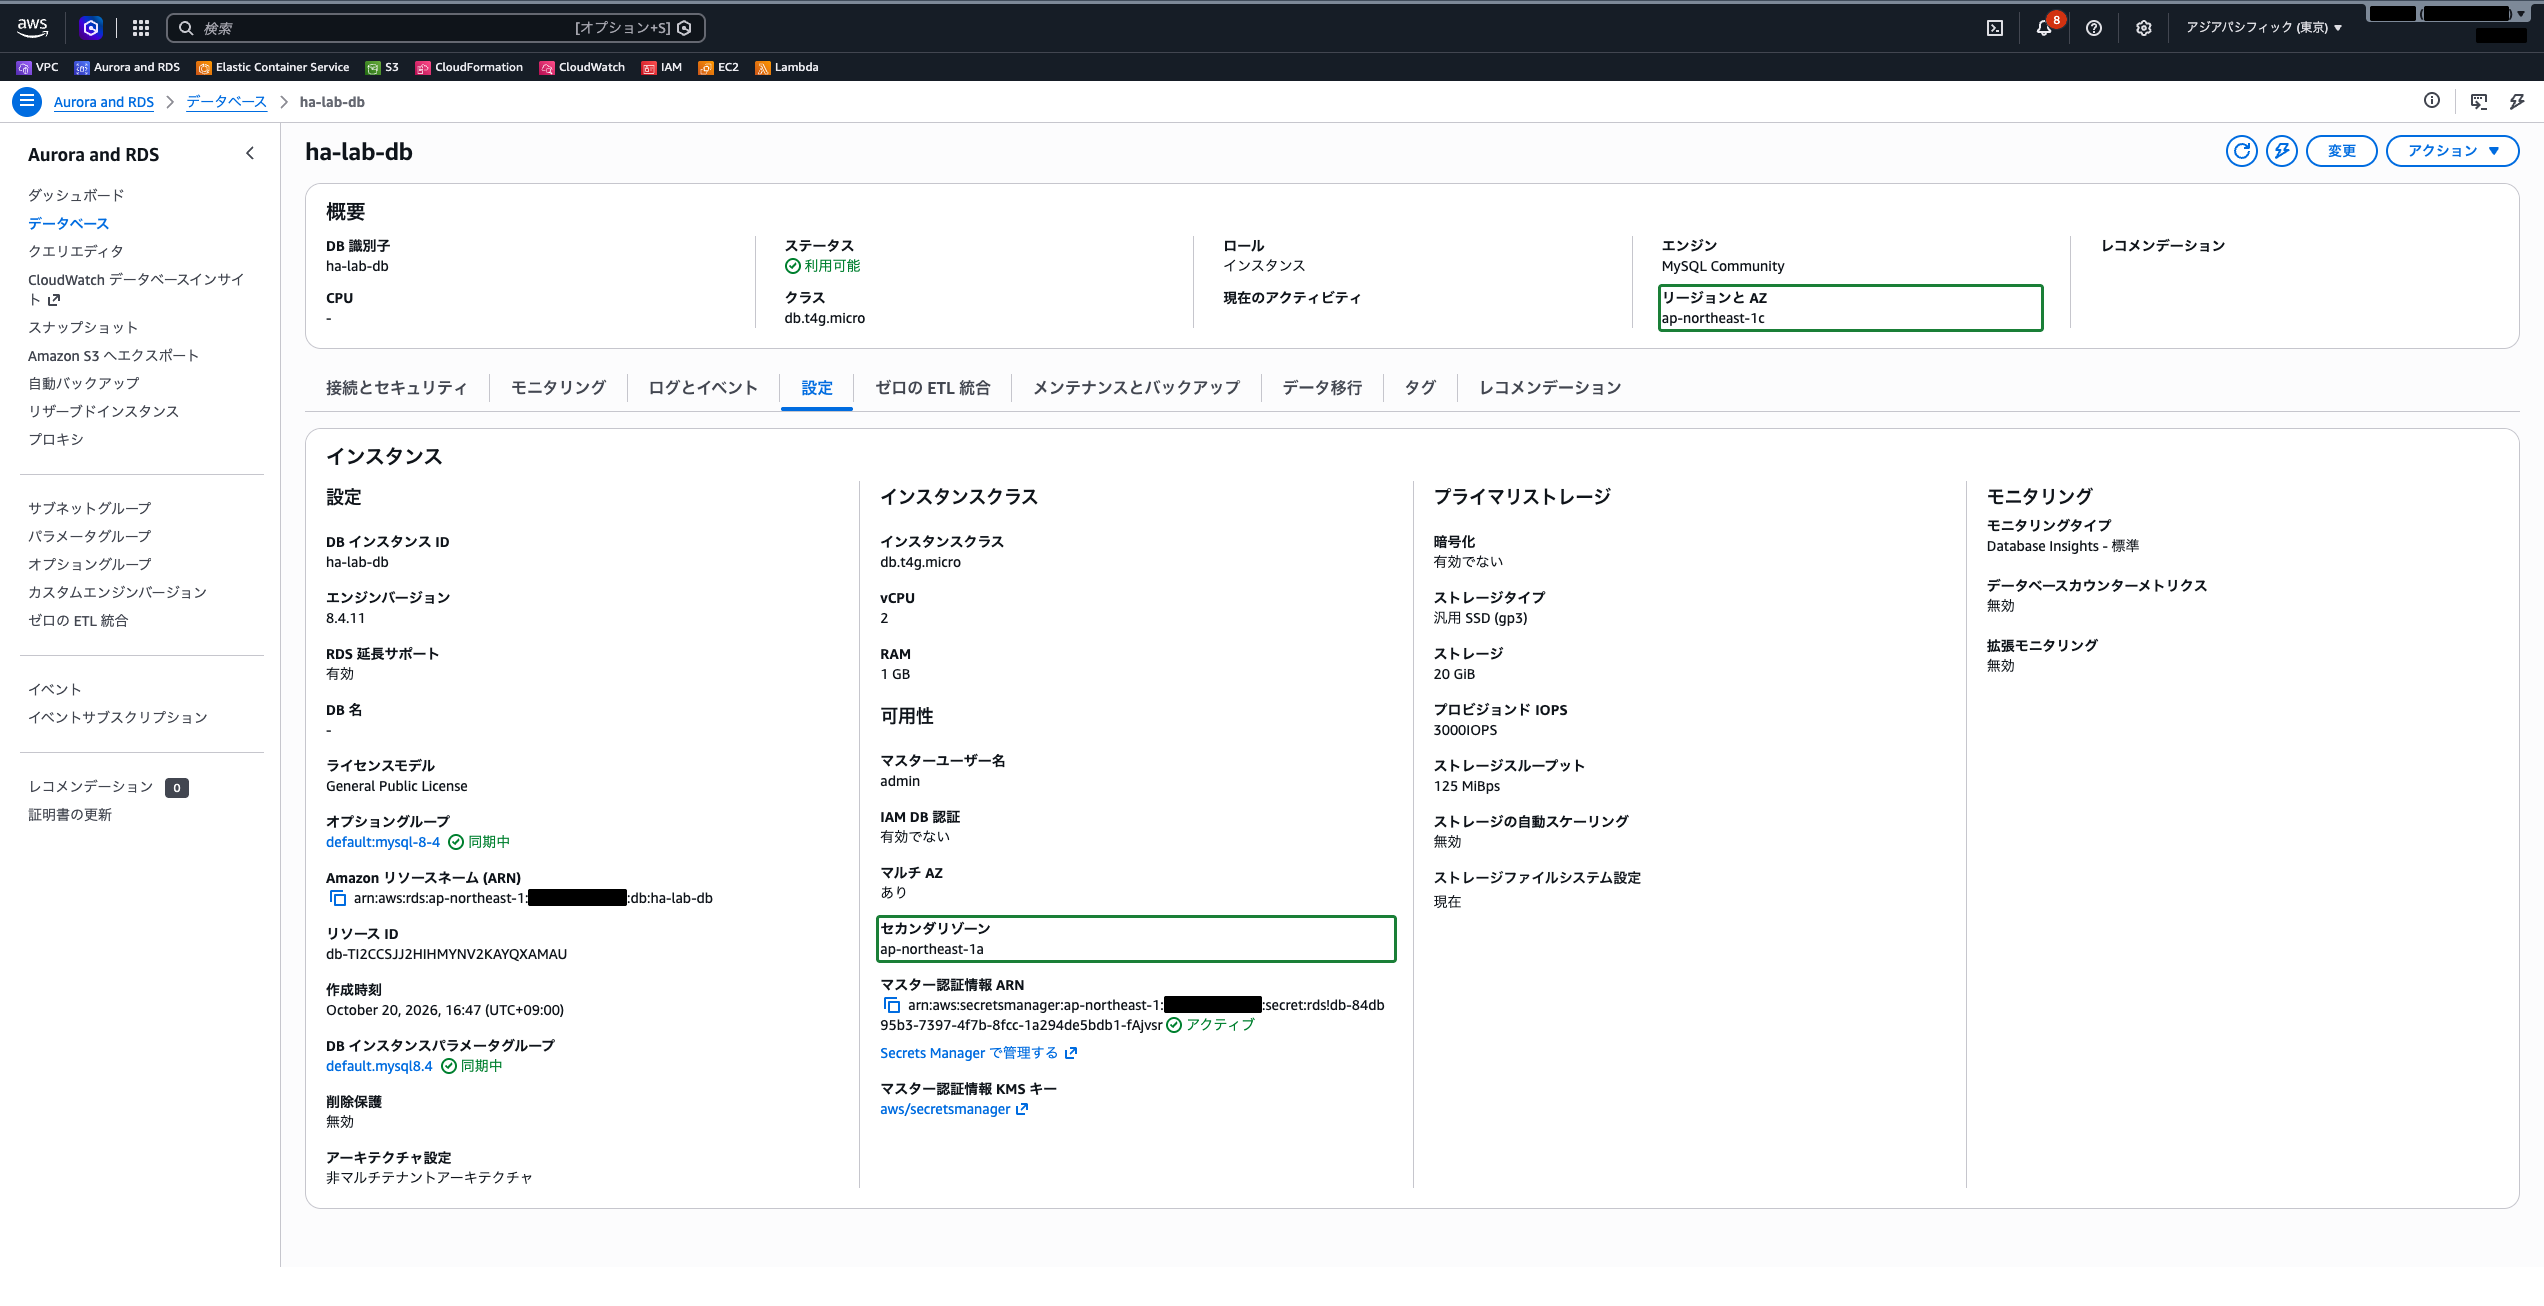
ステータスが「利用可能」に戻ったら、ha-lab-db を開きます。概要の「リージョンと AZ」が ap-northeast-1c に、「設定」タブの「セカンダリゾーン」が ap-northeast-1a に入れ替わっています。一方で、「接続とセキュリティ」タブの「エンドポイントとポート」に表示されるエンドポイントは、手順 1 で控えた値から変わっていません。
「ログとイベント」タブの「最近のイベント」で、マルチ AZ のフェイルオーバーが開始・完了したイベント(Multi-AZ instance failover started. と Multi-AZ instance failover completed)を確認します。今回は開始から完了まで 1 分ほどでした。
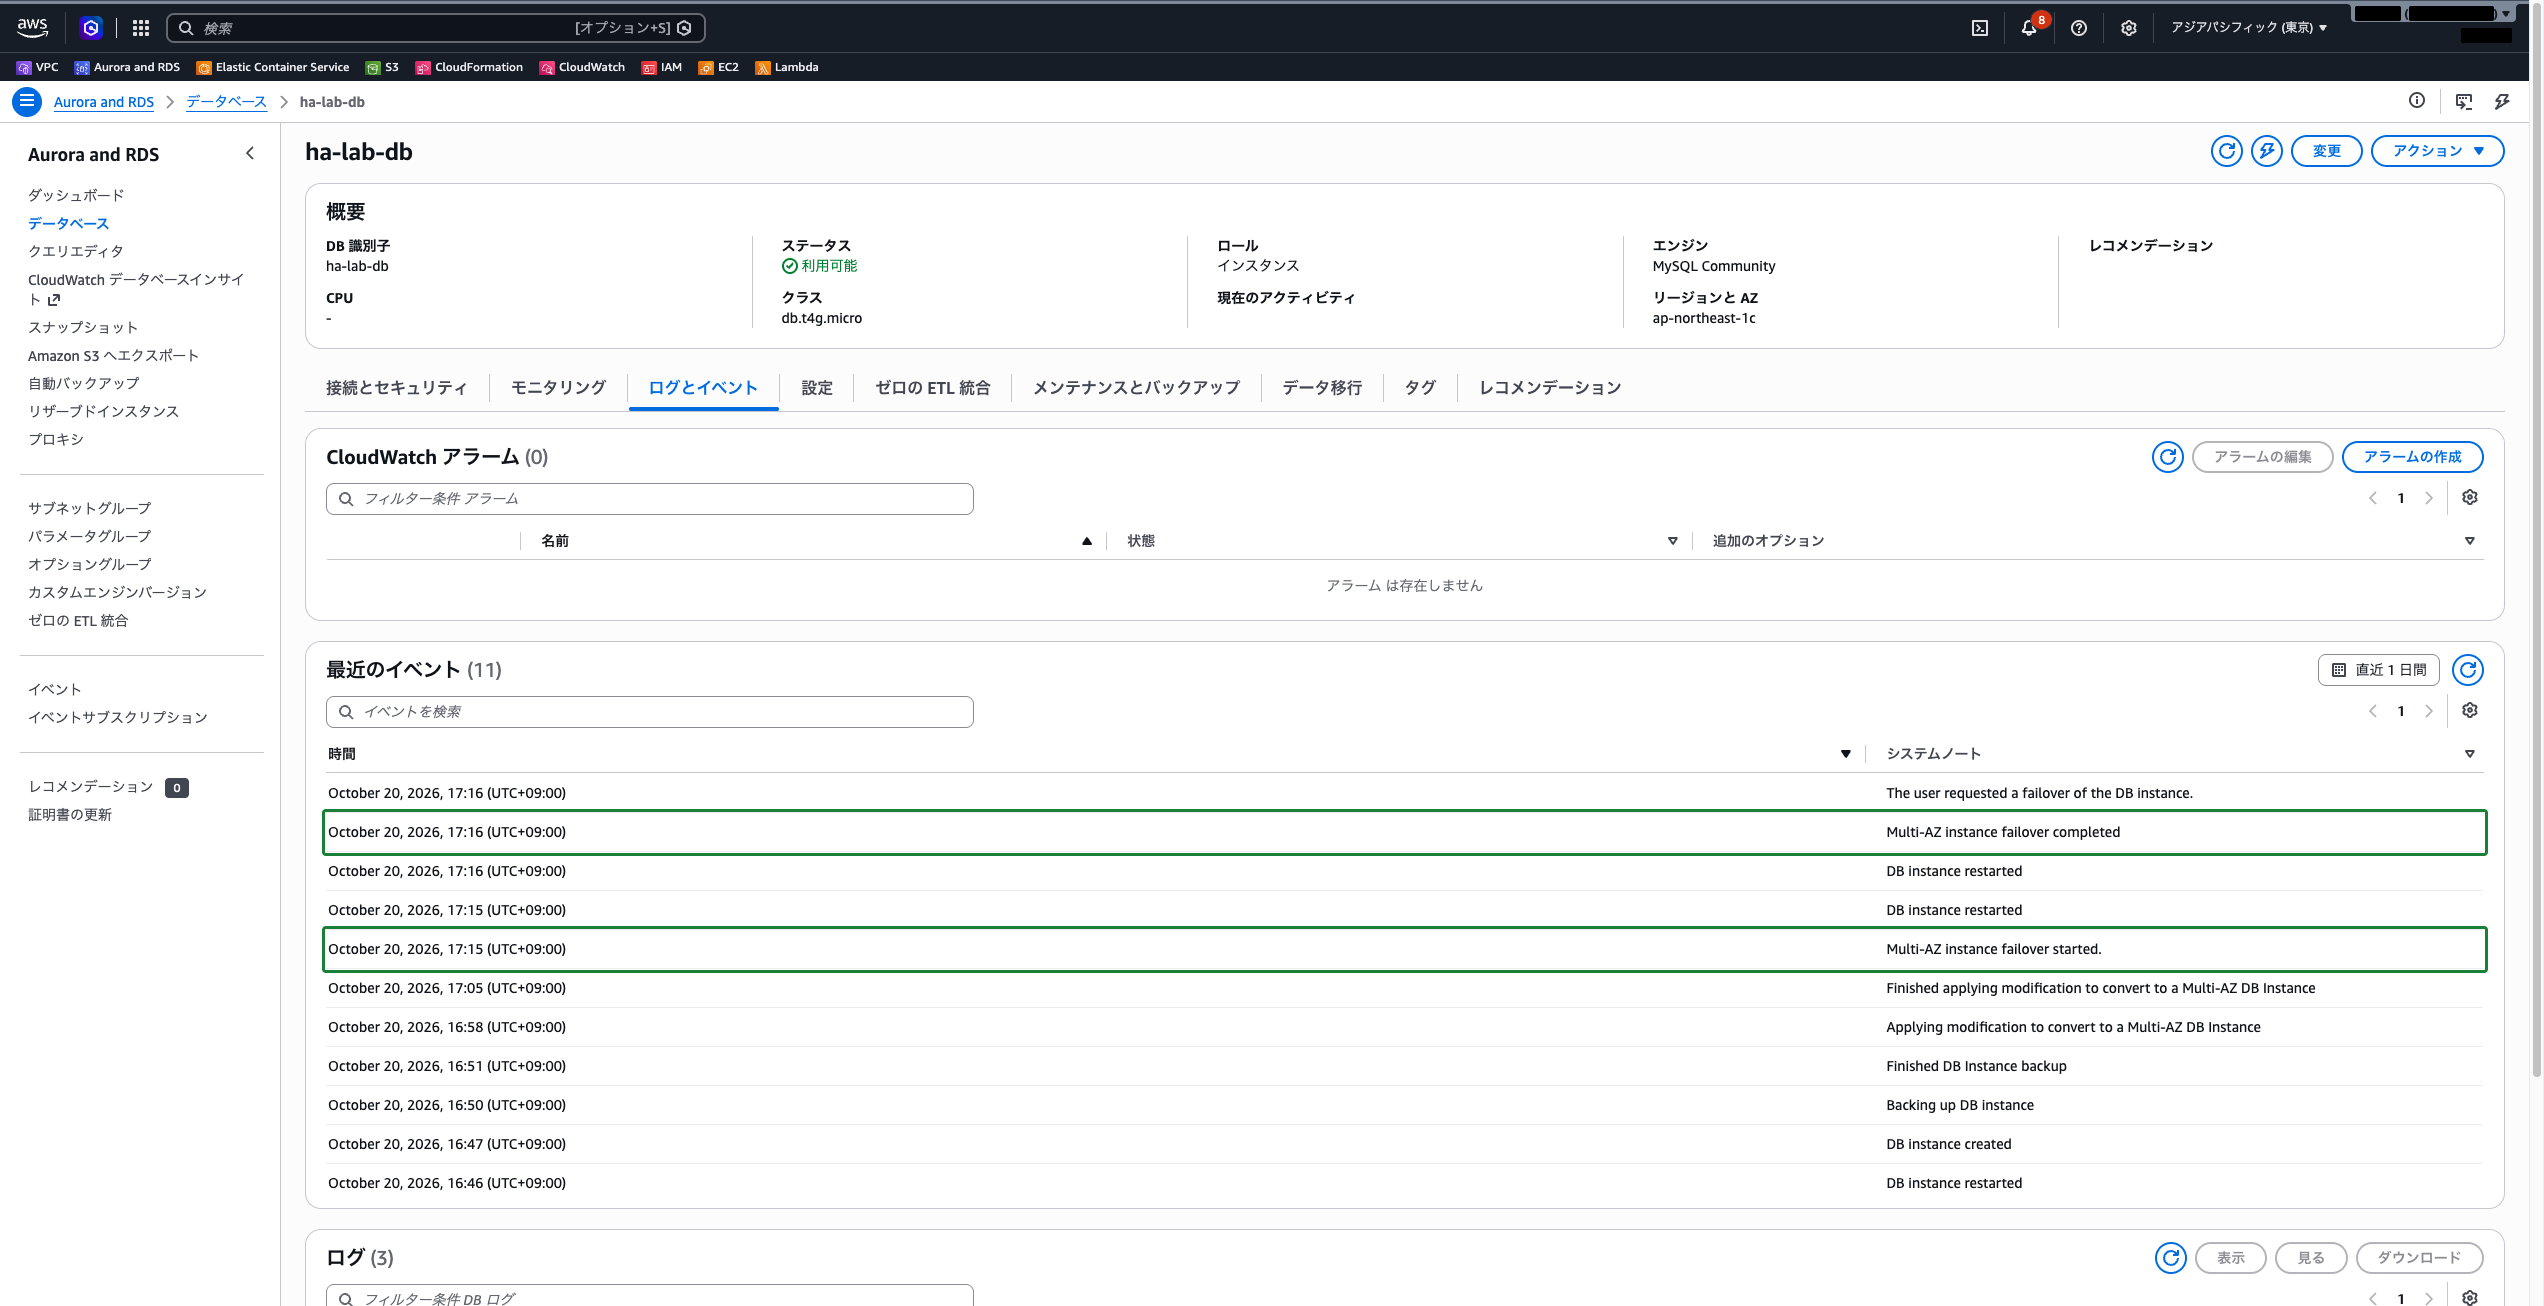
アプリケーションは同じエンドポイントに接続し直すだけで、新しいプライマリにつながります。
 クラウドおさる
「同じ AZ にサブネットを足す」「既存のサーバーを Auto Scaling グループに入れるだけ」は、どちらも AZ を増やしていないでござる。高可用性を問われたら、まず「AZ が増えているか」を確かめるのが近道でござるな。
まとめ
| 層 | 複数 AZ に広げる方法 | 押さえどころ |
|---|---|---|
| ネットワーク | 別の AZ にパブリック・プライベートサブネットを作る | 同じ AZ にサブネットを足しても AZ 障害には耐えられない |
| 入口 | ALB で 2 つ以上の AZ を有効にする | ALB で有効でない AZ のターゲットには振り分けない |
| Web 層 | Auto Scaling グループに別の AZ のサブネットを足す | 再調整は新しいインスタンスを先に起動してから古いものを終了する |
| データベース層 | RDS をマルチ AZ 配置にする | 同期レプリケーション。スタンバイは読めない。フェイルオーバーは通常 60〜120 秒で、エンドポイント名は変わらない |
- 高可用性で増やすべきは、サブネットやインスタンスの数ではなく「使う AZ の数」
- データベースはプライベートサブネットに置いたまま、RDS のマルチ AZ 配置に切り替えを任せる
- シングル AZ からマルチ AZ への変換はダウンタイムを最小限に抑えて行えるが、書き込みの多いワークロードでは性能に影響することがある
- 手動のフェイルオーバーは「フェイルオーバーで再起動」で起こせる。既存の接続は張り直しが必要
参照先
- Amazon RDS のマルチ AZ DB インスタンスデプロイ – Amazon Relational Database Service
- Amazon RDS 用のマルチ AZ DB インスタンスのフェイルオーバー – Amazon Relational Database Service
- Amazon RDS の DB インスタンスをマルチ AZ 配置に変換する – Amazon Relational Database Service
- アベイラビリティーゾーンを追加する – Amazon EC2 Auto Scaling
- アプリケーションアーキテクチャに対する Auto Scaling の利点 – Amazon EC2 Auto Scaling