概要
Amazon DynamoDB は、AWS が提供するサーバーレスでフルマネージドの NoSQL データベースです。キーバリューモデルとドキュメントデータモデルに対応しており、サーバーのプロビジョニングやパッチ適用、メンテナンスウィンドウを意識せずに使い始められます。データはデフォルトで 3 つのアベイラビリティーゾーンに自動でレプリケートされ、規模にかかわらず 1 桁ミリ秒のパフォーマンスを提供するように設計されています。
一方で、DynamoDB はリレーショナルデータベース(RDB)とは考え方が大きく異なります。JOIN は使えず、「どのキーでデータを取り出すか」を先に決めてテーブルを設計する必要があります。パーティションキーとソートキー、Query と Scan の違いを押さえておかないと、思ったようにデータを取り出せなかったり、読み込みコストがふくらんだりします。
本記事では、DynamoDB の基本概念(パーティションキーとソートキー、キャパシティモード、Query と Scan、グローバルセカンダリインデックス、TTL、DynamoDB Streams、ポイントインタイムリカバリ)を整理したうえで、オンデマンドモードのテーブルを作成し、コンソールと Lambda 関数(Python)から項目の書き込みと Query を体験します。
 クラウドおさる
今回は猿山の注文台帳を DynamoDB に作って、Lambda から書き込んだり探したりするのでござる。表の形をしているのに RDB とは別物らしいので、その違いを確かめたいでござるな。
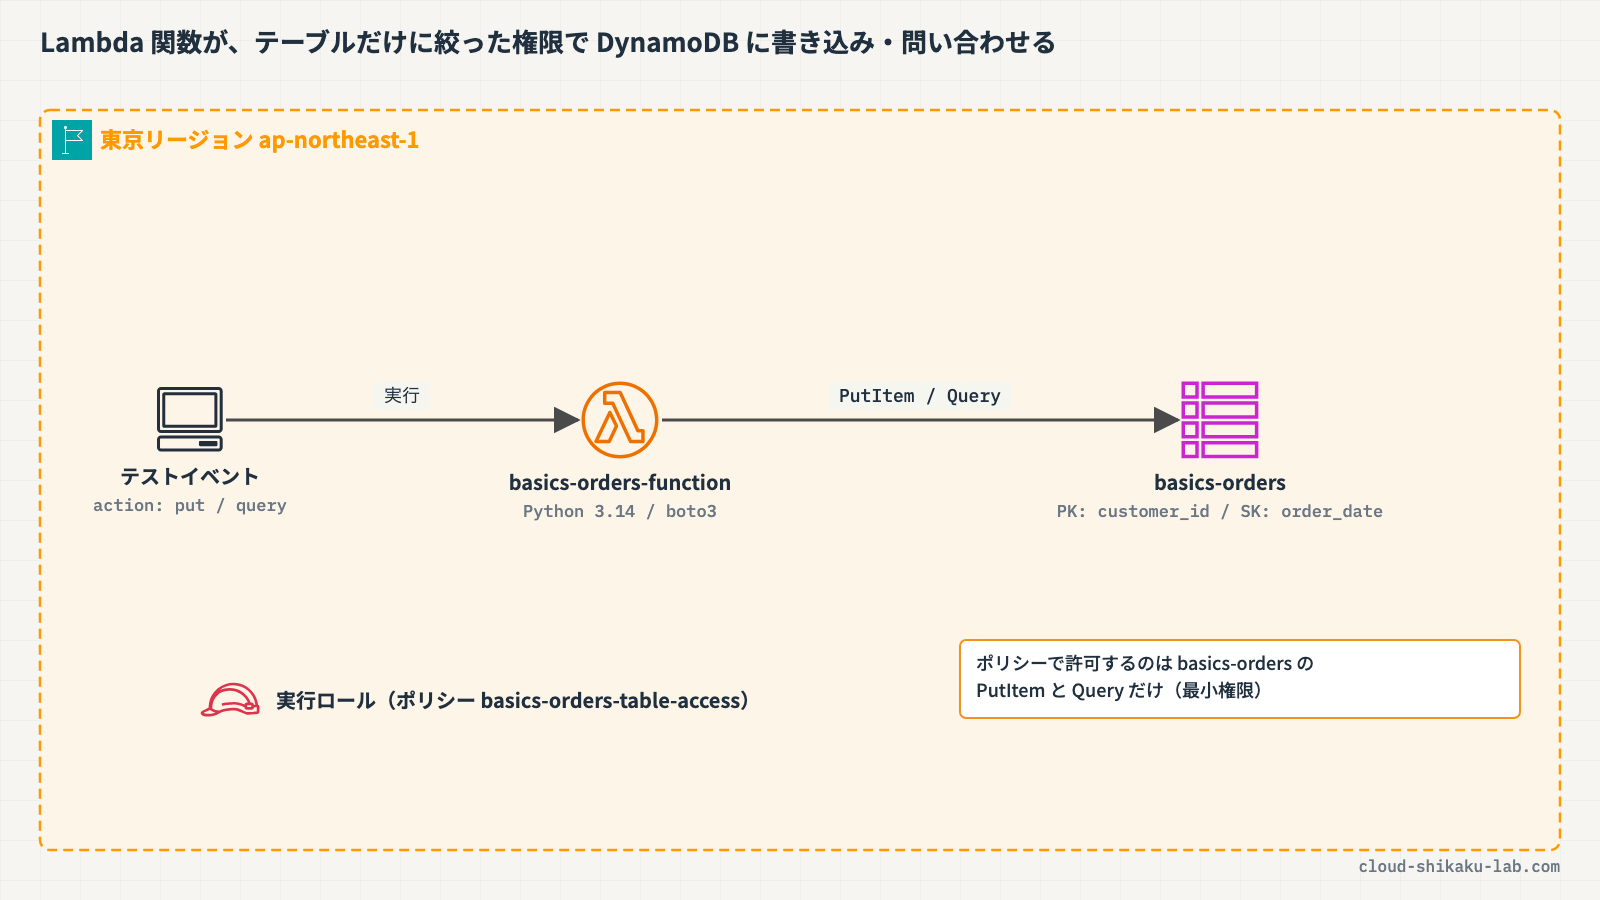
この記事のメリット
- NoSQL(キーバリュー)型データベースとしての DynamoDB の特徴と、RDB との違いを理解できる
- パーティションキーとソートキーによるプライマリキーの設計の考え方を把握できる
- オンデマンドとプロビジョンドの 2 つのキャパシティモードの違いを理解できる
- Query と Scan の違いと、Scan の読み込みコストに関する注意点を把握できる
- グローバルセカンダリインデックス、TTL、DynamoDB Streams、ポイントインタイムリカバリの役割を一通り把握できる
- Lambda 関数から boto3 で DynamoDB に PutItem / Query する手順と、対象テーブルだけに絞った実行ロールの権限設定を体験できる
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
 クラウドおさる
はじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
クラウドおさる基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
DynamoDB とは
クラウドおさるとひさん、DynamoDB は「NoSQL データベース」と聞いたでござるが、そもそも NoSQL とは何でござるか?
 土肥
ざっくり言うと、RDB みたいに「テーブル・行・列に正規化して SQL で自在に結合する」モデル以外のデータベースの総称だよ。DynamoDB はその中でも、キーバリューモデルとドキュメントデータモデルに対応しているんだ。キーを指定すると、そのキーに対応するデータのかたまりがすぐに返ってくるイメージかな。
クラウドおさるキーを渡すと中身が返ってくる……。RDB とはどう違うのでござる?
土肥いい質問だね!AWS のドキュメントの比較をまとめるとこんな感じだよ。
| 特性 | RDB(RDBMS) | Amazon DynamoDB |
|---|---|---|
| 得意なワークロード | アドホッククエリ、データウェアハウス、OLAP | ソーシャル、ゲーム、IoT などのウェブスケールアプリケーション |
| データモデル | 明確に定義されたスキーマに正規化する | スキーマレス。プライマリキー以外の属性は項目ごとに自由 |
| データアクセス | SQL | コンソール、AWS CLI、AWS SDK、SQL 互換の PartiQL |
| JOIN | 使える | 使えない |
| スケーリング | 高速なハードウェアへのスケールアップが基本 | 分散クラスターでスケールアウト。テーブルの項目数・合計サイズに上限なし |
土肥運用面では、サーバーレスでフルマネージドなのも大きいよ。パッチ当てやバージョン管理、メンテナンスウィンドウがなくて、データはデフォルトで 3 つの AZ に自動でレプリケートされるんだ。
クラウドおさるなるほど、猿山のバナナ倉庫で言えば、棚番号を言えばすぐにそのバナナ箱が出てくる仕組みでござるな!その代わり「黄色くて重い箱を全部」のような探し方は苦手そうでござる。
土肥そうそう、その感覚が大事なんだ。DynamoDB は「どのキーで取り出すか」を先に決めてテーブルを設計するデータベースなんだよ。次はそのキーの話をしよう。
テーブル・項目・属性とプライマリキー
クラウドおさるDynamoDB のデータは、どんな単位で保存されるのでござるか?
土肥3 つの用語を押さえておこう。
| 用語 | 説明 | RDB でのイメージ |
|---|---|---|
| テーブル | データのコレクション | テーブル |
| 項目(Item) | 他の項目と一意に区別できる属性のグループ。テーブルに入れられる項目数に上限はない | 行 |
| 属性(Attribute) | データの基本要素(名前と値の組) | 列 |
土肥テーブルを作るときに必ず決めるのが「プライマリキー」だよ。プライマリキーには 2 種類あるんだ。
| 種類 | 構成 | 一意性 |
|---|---|---|
| パーティションキー(シンプルなプライマリキー) | 属性 1 つ | パーティションキーの値が同じ項目は 2 つ作れない |
| パーティションキー + ソートキー(複合プライマリキー) | 属性 2 つ | パーティションキーが同じでも、ソートキーが違えば別の項目になる |
 クラウドおさる
パーティションキーとソートキーは、それぞれ何をしているのでござる?
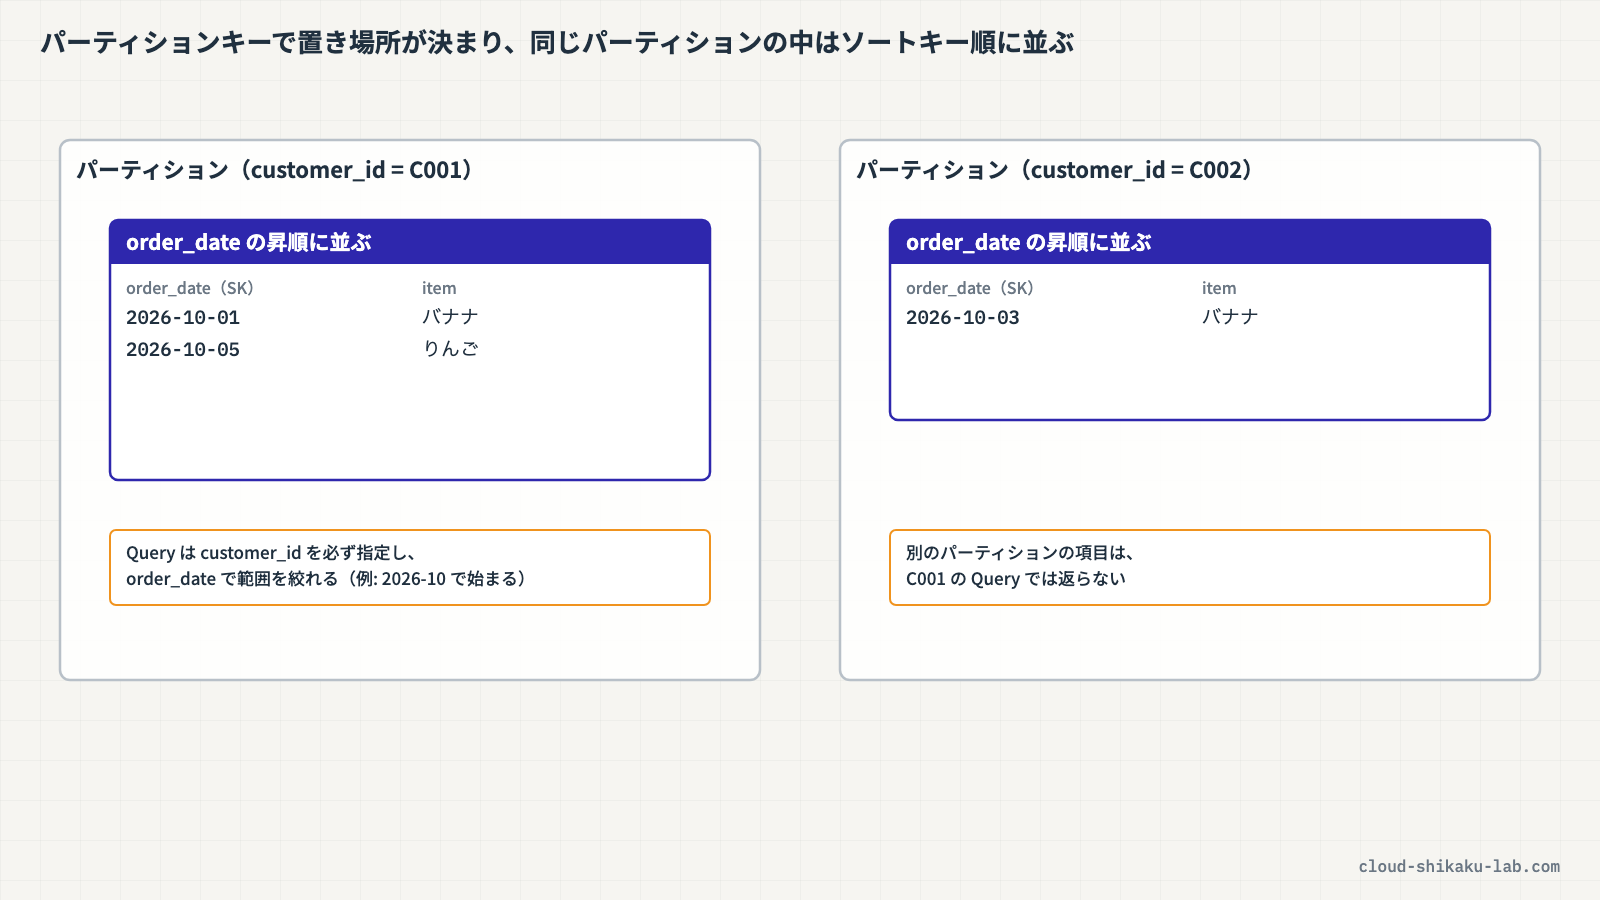
土肥DynamoDB はパーティションキーの値を内部のハッシュ関数に通して、項目を保存するパーティション(物理的な保存場所)を決めているんだ。複合プライマリキーの場合、同じパーティションキーの項目はソートキーの順に並べてまとめて保存されるよ。だから「顧客 ID をパーティションキー、注文日をソートキー」にすると、「ある顧客の 10 月の注文」のような取り出し方が得意になるんだ。
クラウドおさる猿ごとに棚が分かれていて、棚の中は日付順に箱が並んでいるのでござるな!
土肥その例えでばっちりだね。ちなみにプライマリキーの属性に使えるデータ型は、文字列・数値・バイナリのスカラー値だけだよ。それ以外の属性は自由に追加できるんだ。
キャパシティモード(オンデマンド / プロビジョンド)
クラウドおさるDynamoDB の料金は、どのように決まるのでござるか?
土肥読み書きのスループットの払い方として、キャパシティモードを 2 つから選ぶんだ。
| 項目 | オンデマンドモード | プロビジョンドモード |
|---|---|---|
| 課金 | 読み込み・書き込みのリクエストごとの従量課金 | あらかじめ指定したキャパシティに対して時間単位で課金 |
| キャパシティの指定 | 不要(トラフィックに合わせて自動でスケール) | 1 秒あたりの読み込み・書き込みの量を指定する(Auto Scaling も設定可能) |
| 向いているワークロード | ほとんどのワークロード(AWS が推奨するデフォルト) | 予測しやすく安定したワークロード |
土肥新しく作るテーブルはオンデマンドがデフォルトで、AWS もほとんどのワークロードに推奨しているよ。トラフィックがゼロのときはスループットの料金がかからないのも特徴だね。
クラウドおさる「1 回の読み込み」は、どうやって数えるのでござる?
土肥単位の考え方はこうだよ。オンデマンドなら「リクエスト単位」、プロビジョンドなら「キャパシティユニット」と呼び名が変わるけど、数え方は同じなんだ。
| 単位 | 数え方 |
|---|---|
| 読み込み | 最大 4 KB の項目を、強力な整合性で 1 回読む = 1 単位(結果整合性なら 2 回で 1 単位) |
| 書き込み | 最大 1 KB の項目を 1 回書く = 1 単位 |
クラウドおさる結果整合性の読み込みなら半分で済むのでござるな。猿山の長老会にもバナナの節約術として報告するでござる。
Query と Scan
クラウドおさるデータを取り出すときは、どうするのでござるか?
土肥複数の項目を読む方法として、Query と Scan の 2 つがあるよ。ここが DynamoDB で一番大事なところかもしれない。
| 項目 | Query | Scan |
|---|---|---|
| 読む範囲 | 指定したパーティションキーの値を持つ項目だけ | テーブル(またはインデックス)のすべての項目 |
| 必須の条件 | パーティションキーの等価条件(=) | なし |
| 絞り込み | ソートキーに = < <= > >= BETWEEN begins_with が使える | フィルター式のみ |
| 1 回で返すデータ量 | 最大 1 MB | 最大 1 MB |
クラウドおさるScan でもフィルター式で絞り込めるなら、それで十分ではござらぬか?
土肥そこが落とし穴なんだ。Scan のフィルター式は、テーブルを読み終わったあと、結果を返す前に適用されるんだよ。消費する読み込みキャパシティは返したデータ量ではなく、読んだ項目の数とサイズで計算されるから、フィルター式を付けても消費量は変わらないんだ。
 クラウドおさる
Scan は倉庫の箱を全部開けてから選ぶようなものなので、テーブルが大きくなるほど読み込みの料金がふくらむのでござるな。よく使う取り出し方は、Query で済むようにキーを設計しておくのが肝心でござる。
グローバルセカンダリインデックス(GSI)
クラウドおさるでも、顧客 ID 以外、たとえば「商品名」で探したくなったらどうするのでござる?
土肥そういうときはセカンダリインデックスを作るんだ。中でもよく使うのがグローバルセカンダリインデックス(GSI)だよ。テーブルのプライマリキーとは別のパーティションキー・ソートキーを持つインデックスで、そのキーで Query できるようになるんだ。
| 項目 | 内容 |
|---|---|
| キー | テーブルと異なるパーティションキー(+ ソートキー)を指定できる |
| 作成タイミング | テーブル作成後にも追加できる |
| 整合性 | 結果整合性のみ(テーブルの変更は非同期でインデックスに反映される) |
| 射影 | インデックスに持たせる属性を KEYS_ONLY / INCLUDE / ALL から選ぶ |
| 上限 | 1 テーブルあたり 20 個(デフォルトのクォータ) |
土肥ちなみに、パーティションキーはテーブルと同じでソートキーだけ違うローカルセカンダリインデックス(LSI)もあるよ。まずは GSI を覚えておけば大丈夫。
クラウドおさる棚番号とは別に「商品名の索引帳」を作っておくイメージでござるな!索引帳の更新は少し遅れて追いつく、というのも覚えておくでござる。
TTL・DynamoDB Streams・ポイントインタイムリカバリ・DAX
クラウドおさるほかに知っておくべき機能はあるのでござるか?
土肥名前と役割だけでも押さえておきたい機能をまとめるね。
| 機能 | 役割 | ポイント |
|---|---|---|
| TTL(Time to Live) | 有効期限を過ぎた項目を自動で削除する | UNIX エポック秒の数値属性で期限を持たせる。削除は期限切れから数日以内で、書き込みスループットを消費しない |
| DynamoDB Streams | 項目の追加・更新・削除をイベントの順にほぼリアルタイムで記録する | ストリームレコードは 24 時間保持。Lambda 関数のトリガーにできる |
| ポイントインタイムリカバリ(PITR) | 復元期間内の任意の時点(秒単位)にテーブルを復元する | 復元期間は 1〜35 日(デフォルト 35 日)。復元先は新しいテーブル |
| DynamoDB Accelerator(DAX) | DynamoDB 互換のインメモリキャッシュ | 結果整合性の読み込みの応答をマイクロ秒単位まで短縮する |
クラウドおさるTTL は古い注文の自動お片付け、Streams は変更の見張り番、PITR は時間を巻き戻す保険でござるな。
土肥その通り!Streams と Lambda を組み合わせると「注文が入ったら通知する」みたいな仕組みも作れるよ。今回はまず、Lambda から DynamoDB を直接読み書きするところまでやってみよう。
実践

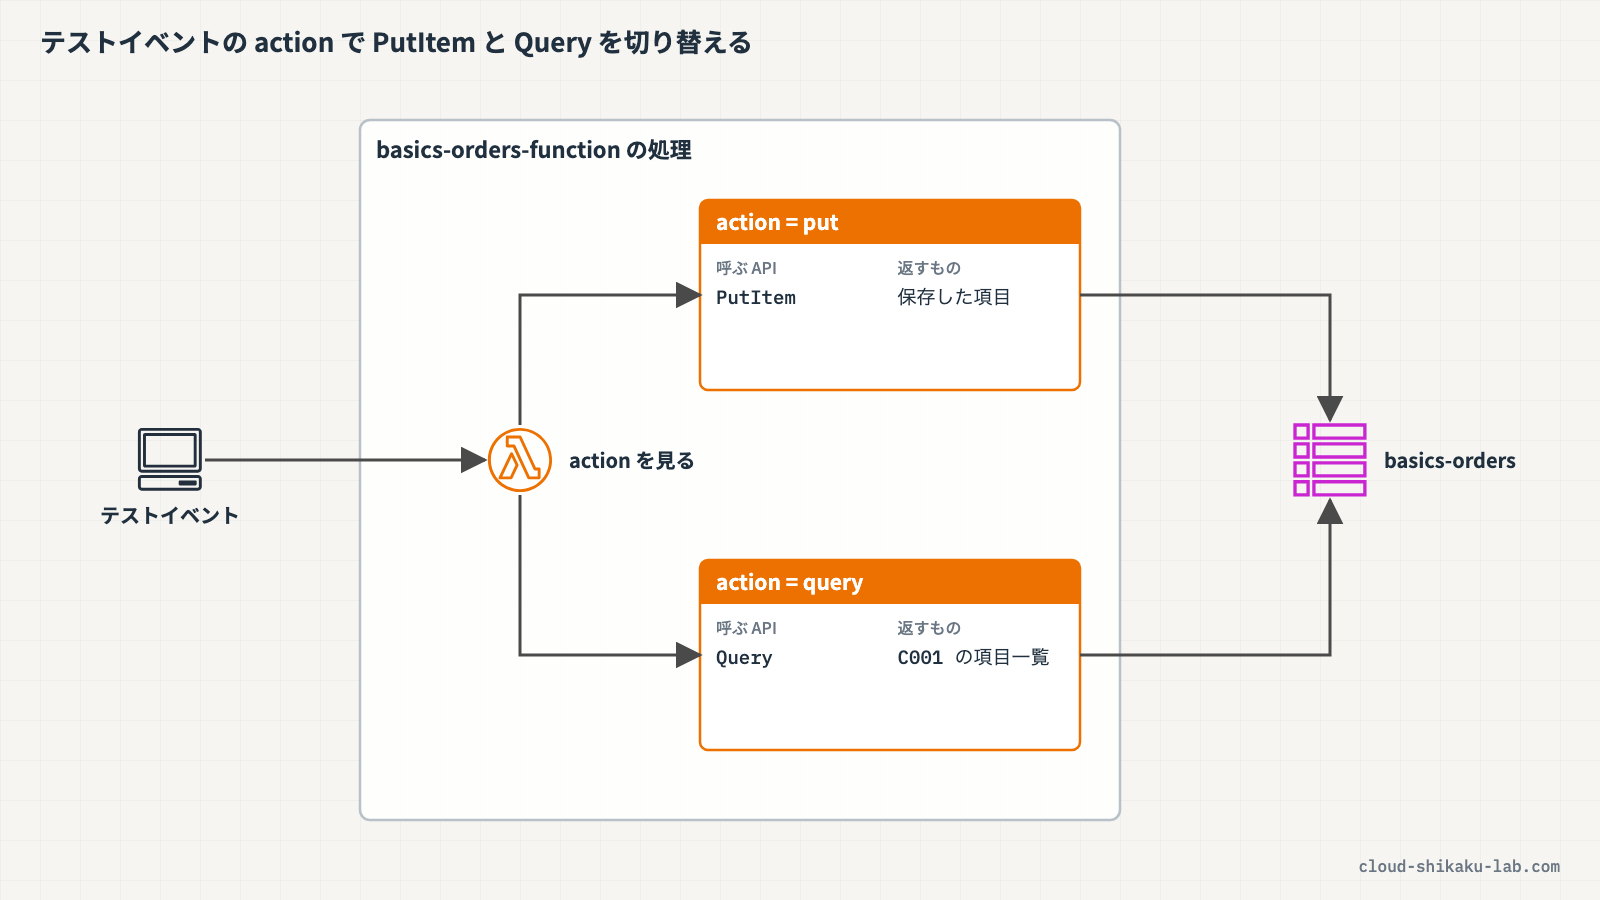
ここでは、オンデマンドモードの DynamoDB テーブルを作成してコンソールから項目を追加・Query し、続いて Lambda 関数(Python)から PutItem と Query を実行します。
前提条件
- リージョン:
ap-northeast-1(東京) - AWS マネジメントコンソールにログイン済みで、DynamoDB・Lambda・IAM を操作できる権限があること
- 事前に作成しておくリソースはありません
| リソース種別 | リソース名 | 用途 |
|---|---|---|
| DynamoDB テーブル | basics-orders | 注文データを保存するテーブル(オンデマンド) |
| Lambda 関数 | basics-orders-function | テーブルに PutItem / Query する関数(Python 3.14) |
| IAM ロール | (Lambda が自動作成) | Lambda 実行ロール |
| IAM インラインポリシー | basics-orders-table-access | 実行ロールに付ける、basics-orders テーブルだけを対象にした読み書き権限 |
DynamoDB テーブルを作成する
- AWS マネジメントコンソールにログインし、リージョンが
ap-northeast-1(東京)であることを確認します - 上部の検索バーに
DynamoDBと入力し、表示された「DynamoDB」を選択します - 左側ナビゲーションの「テーブル」を選択し、「テーブルの作成」をクリックします
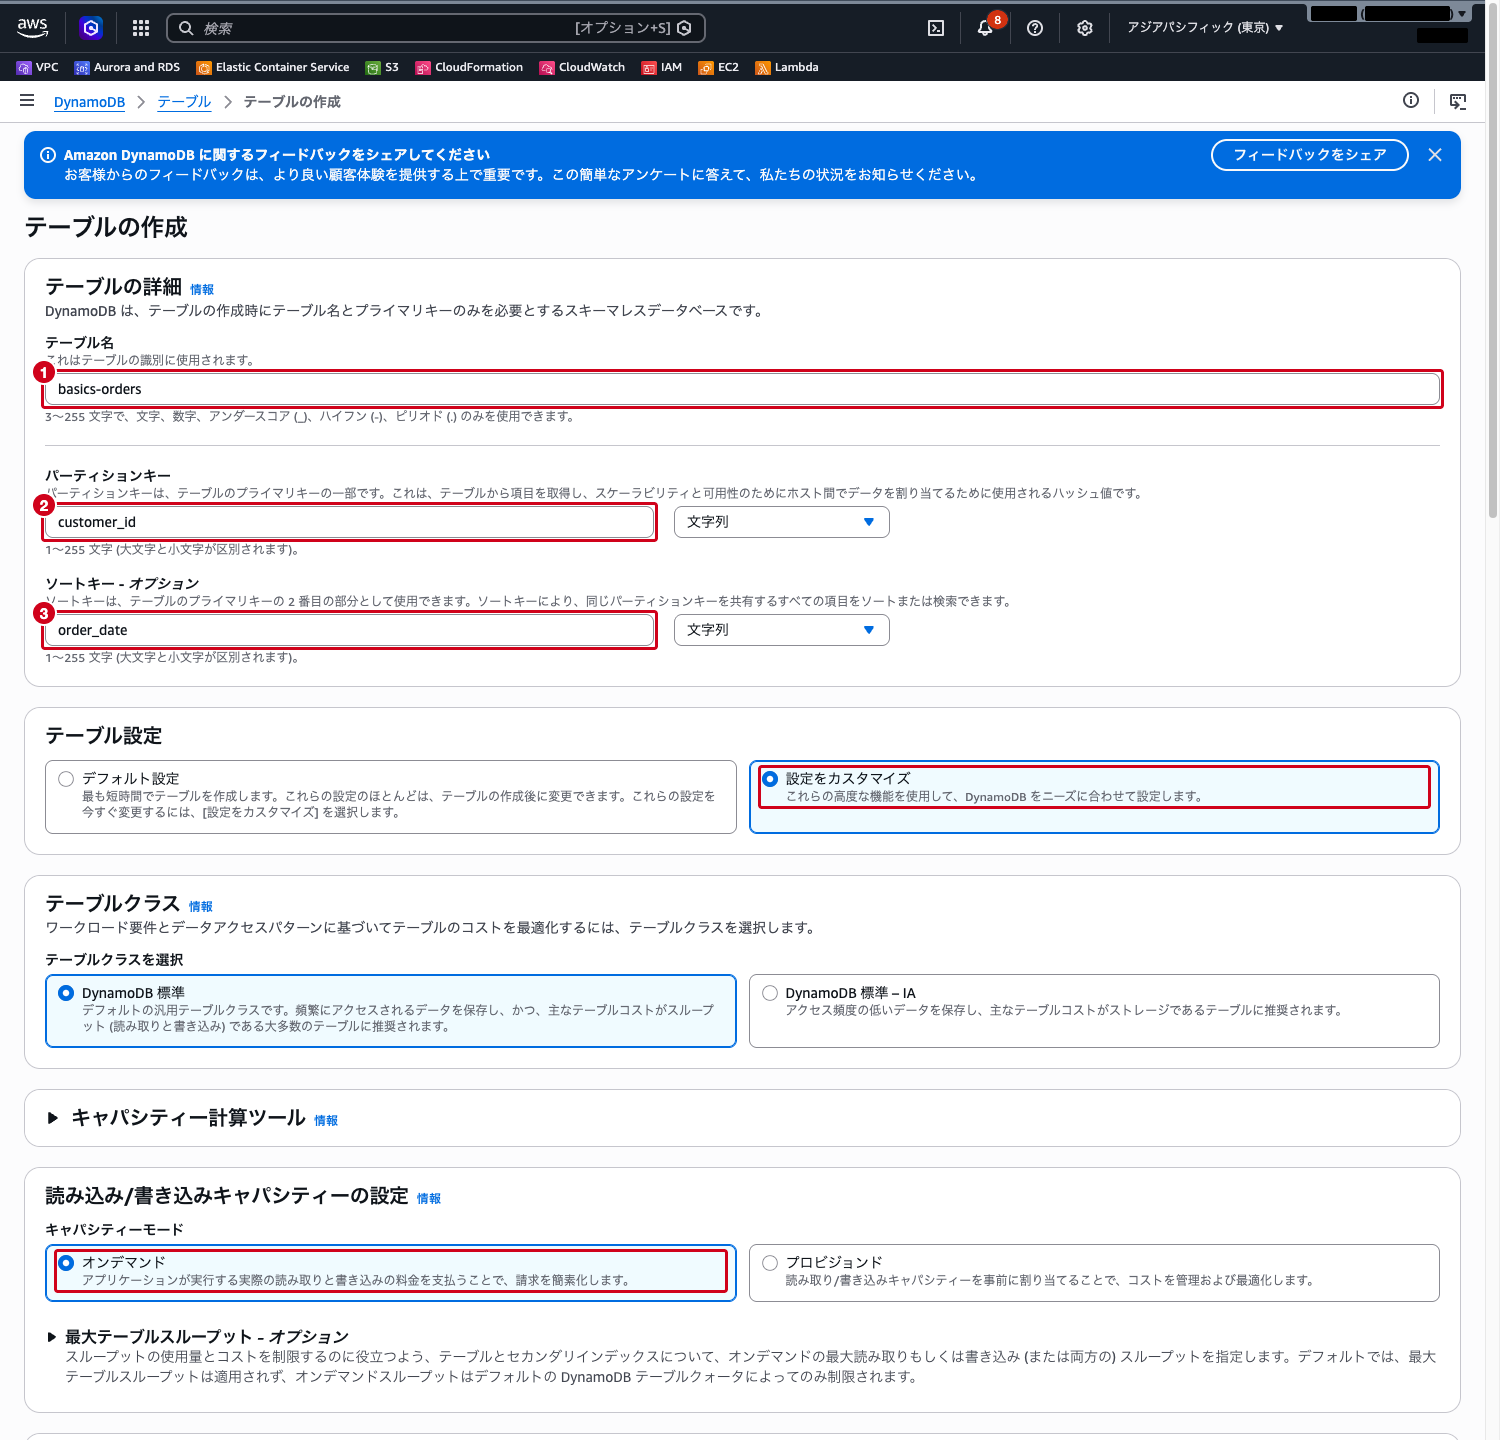
- 「テーブルの詳細」で以下を入力します
- テーブル名:
basics-orders - パーティションキー:
customer_id(型:文字列) - ソートキー:
order_date(型:文字列) - 「テーブル設定」で「設定をカスタマイズ」を選択します
- 「読み込み/書き込みキャパシティーの設定」で、キャパシティーモードが「オンデマンド」になっていることを確認します(既定でオンデマンドが選択されています)
- その他の項目はデフォルトのままにします
- ページ下部の「テーブルの作成」をクリックします
- テーブル一覧で
basics-ordersのステータスが「作成中」から「アクティブ」に変わるまで待ちます
コンソールで項目を追加する
- テーブル一覧で
basics-ordersを選択し、右上の「テーブルアイテムの探索」をクリックします - 「返された項目」セクションで「項目を作成」をクリックします
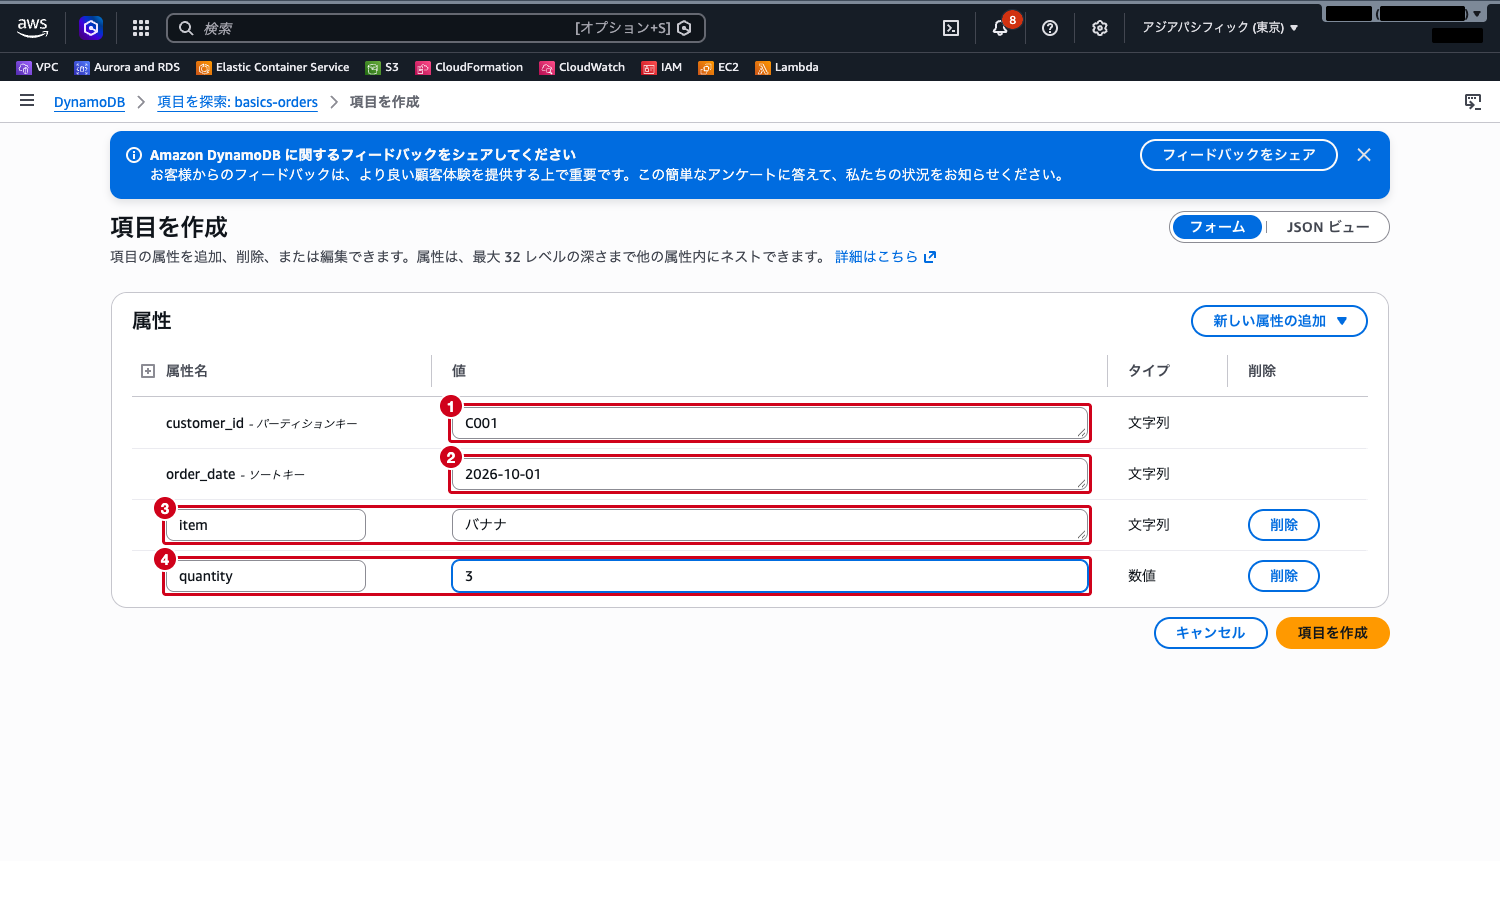
- 「項目を作成」画面で、
customer_idにC001、order_dateに2026-10-01を入力します - 「新しい属性の追加」から「文字列」を選択し、属性名
item、値バナナを入力します - もう一度「新しい属性の追加」から「数値」を選択し、属性名
quantity、値3を入力します
- 「項目を作成」をクリックします
- 同じ手順で、以下の 2 件も作成します
| customer_id | order_date | item | quantity |
|---|---|---|---|
C001 | 2026-10-05 | りんご | 2 |
C002 | 2026-10-03 | バナナ | 10 |
C001 の 2 件は、パーティションキーが同じでもソートキーが異なるため、別の項目として保存されます。
コンソールで Query を実行する
- 「テーブルアイテムの探索」画面の「項目のスキャンまたはクエリ」で「クエリ」を選択します
- 「customer_id(パーティションキー)」に
C001を入力します - 「order_date(ソートキー)」の条件で「次で始まる」を選択し、値に
2026-10を入力します - 「実行」をクリックします
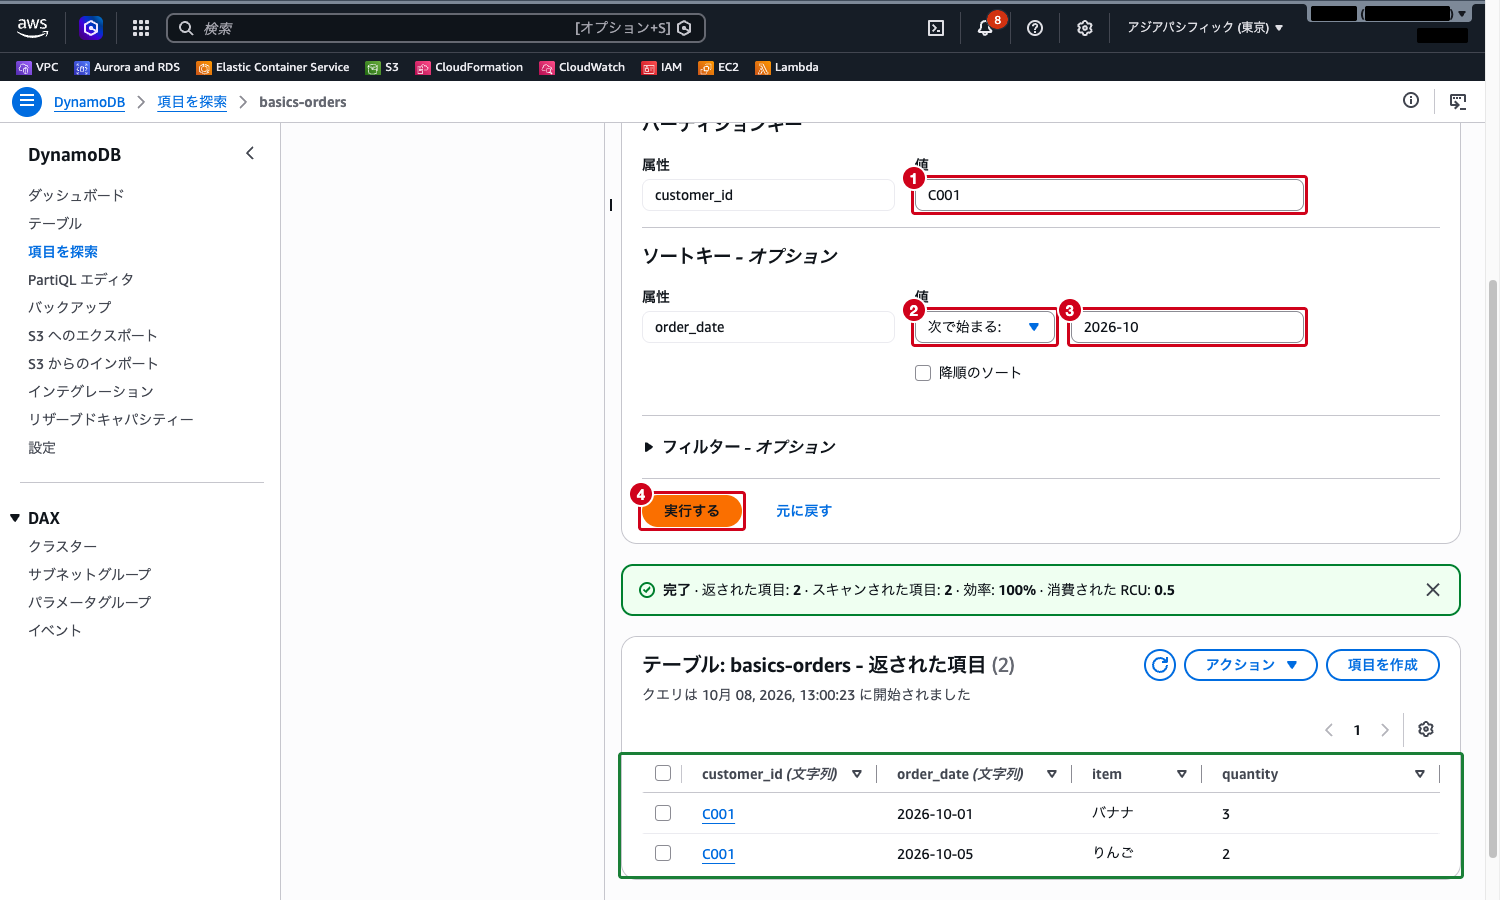
C002 の項目は返されず、C001 の項目だけが order_date の昇順で表示されることが確認できます。
クラウドおさる同じ画面で「スキャン」を選ぶと条件なしで全件が出てくるでござるが、それは倉庫の箱を全部開けている状態でござる。項目が少ない今はよいが、大きなテーブルで気軽に Scan すると読み込みの料金がかさむので注意でござるぞ。
Lambda 関数を作成する
- 上部の検索バーに
Lambdaと入力し、表示された「Lambda」を選択します - 左側ナビゲーションの「関数」を選択し、「関数を作成」をクリックします
- 「一から作成」が選択されていることを確認し、以下を入力します
- 関数名:
basics-orders-function - ランタイム:
Python 3.14 - 「その他の設定」を展開し、アーキテクチャが
x86_64(既定)のままで、「カスタム実行ロール」がオフ(既定の動作として、基本的な Lambda アクセス許可を持つ新しいロールが自動作成される)になっていることを確認します - その他の項目はデフォルトのままにし、「関数を作成」をクリックします
実行ロールに対象テーブルだけの権限を付ける
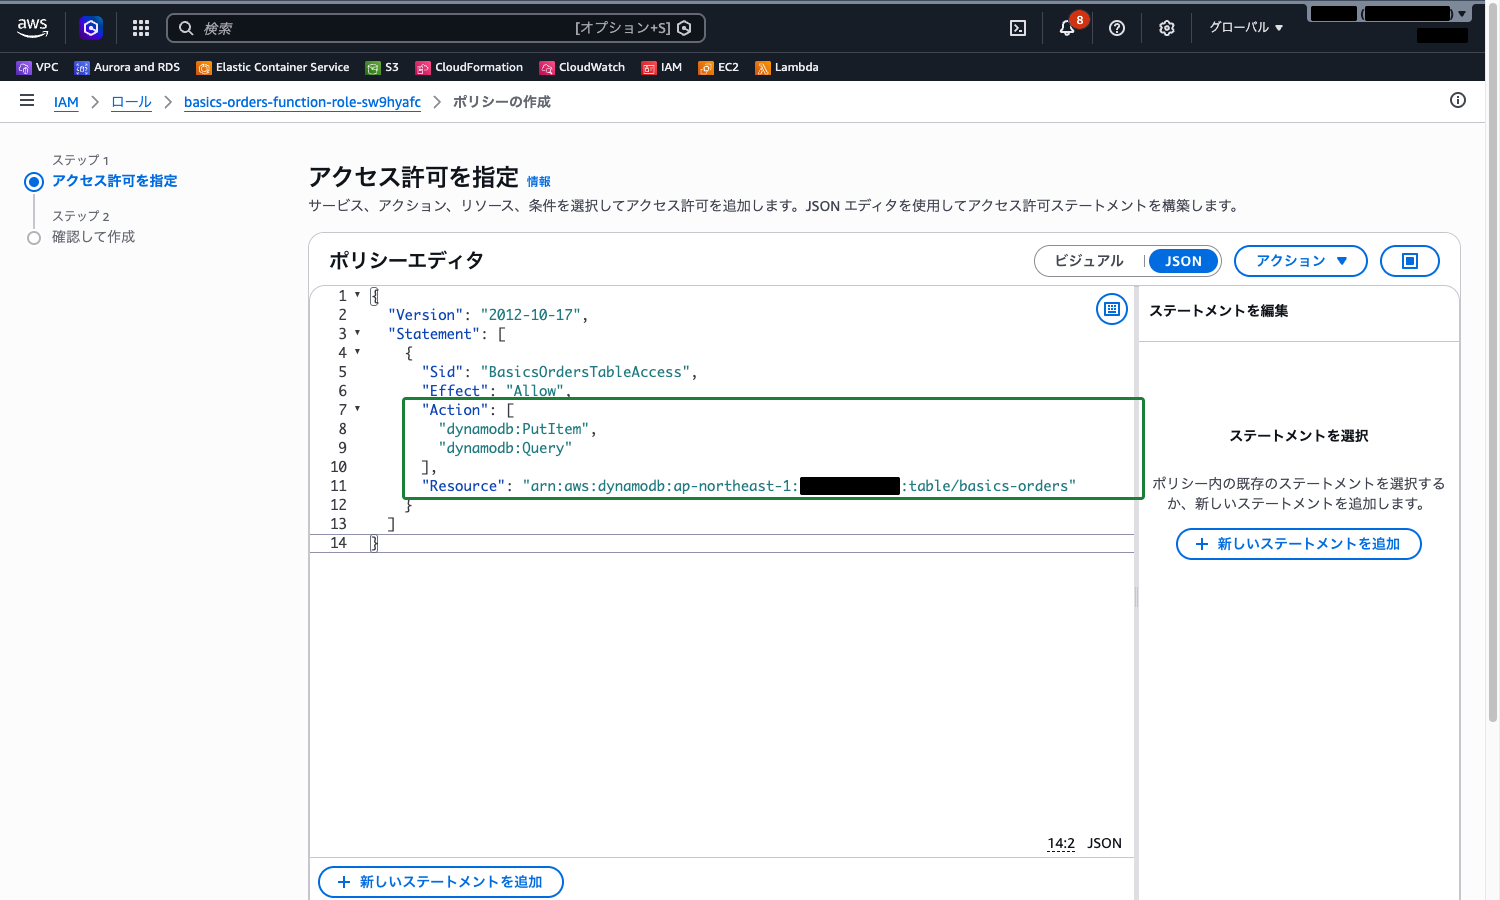
自動作成された実行ロールには CloudWatch Logs へのログ出力権限しかないため、DynamoDB への権限を追加します。権限は basics-orders テーブルに対する PutItem と Query だけに絞ります。
- まず、テーブルの ARN を確認します。DynamoDB コンソールの「テーブル」で
basics-ordersを選択し、画面上部の「一般的な情報」に表示される Amazon リソースネーム(ARN)をコピーします(arn:aws:dynamodb:ap-northeast-1:<アカウントID>:table/basics-ordersの形式です) - Lambda コンソールに戻り、
basics-orders-functionの「設定」タブ →「アクセス権限」を選択します - 「実行ロール」のロール名のリンクをクリックし、IAM コンソールでロールを開きます
- 「許可」タブで「許可を追加」→「インラインポリシーを作成」をクリックします
- ポリシーエディタで「JSON」を選択し、以下の内容に書き換えます(
<アカウントID>は自分のアカウント ID に置き換えます)
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "BasicsOrdersTableAccess",
      "Effect": "Allow",
      "Action": [
        "dynamodb:PutItem",
        "dynamodb:Query"
      ],
      "Resource": "arn:aws:dynamodb:ap-northeast-1:<アカウントID>:table/basics-orders"
    }
  ]
}
- 「次へ」をクリックし、ポリシー名に
basics-orders-table-accessを入力します - 「ポリシーの作成」をクリックします
- 「許可ポリシー」の一覧に、
AWSLambdaBasicExecutionRole-…とbasics-orders-table-accessの 2 つが表示されていることを確認します
関数コードを書いてデプロイする
- Lambda コンソールの
basics-orders-functionに戻り、「コード」タブを選択します lambda_function.pyの内容を以下に書き換えます
import json

import boto3
from boto3.dynamodb.conditions import Key

dynamodb = boto3.resource('dynamodb')
table = dynamodb.Table('basics-orders')


def lambda_handler(event, context):
    action = event.get('action')

    if action == 'put':
        item = {
            'customer_id': event['customer_id'],
            'order_date': event['order_date'],
            'item': event['item'],
            'quantity': int(event['quantity']),
        }
        table.put_item(Item=item)
        print(f'PutItem: {item}')
        return {'statusCode': 200, 'body': json.dumps({'put': item}, ensure_ascii=False)}

    if action == 'query':
        key_condition = Key('customer_id').eq(event['customer_id'])
        if event.get('date_prefix'):
            key_condition = key_condition & Key('order_date').begins_with(event['date_prefix'])
        response = table.query(KeyConditionExpression=key_condition)
        items = response['Items']
        print(f'Query: {len(items)} items')
        # 数値属性は Decimal 型で返るため、JSON にするときは文字列に変換する
        return {'statusCode': 200, 'body': json.dumps({'items': items}, ensure_ascii=False, default=str)}

return {'statusCode': 400, 'body': json.dumps({'error': 'action は put か query を指定してください'}, ensure_ascii=False)}- 「Deploy」をクリックし、関数が正常に更新されたことを示すメッセージが表示されることを確認します
SDK のクライアント(boto3.resource と Table)はハンドラーの外で初期化しています。関数の同じ実行環境で処理される後続の呼び出しではこれらが再利用されるため、実行時間の短縮につながります。
テストイベントで PutItem を実行する
- 「テスト」タブを選択し、「新しいイベントを作成」が選択されていることを確認します
- イベント名に
putOrderを入力し、イベント JSON を以下に書き換えます
{
  "action": "put",
  "customer_id": "C001",
  "order_date": "2026-10-07",
  "item": "みかん",
  "quantity": 5
}- 「保存」をクリックしてから「テスト」をクリックします
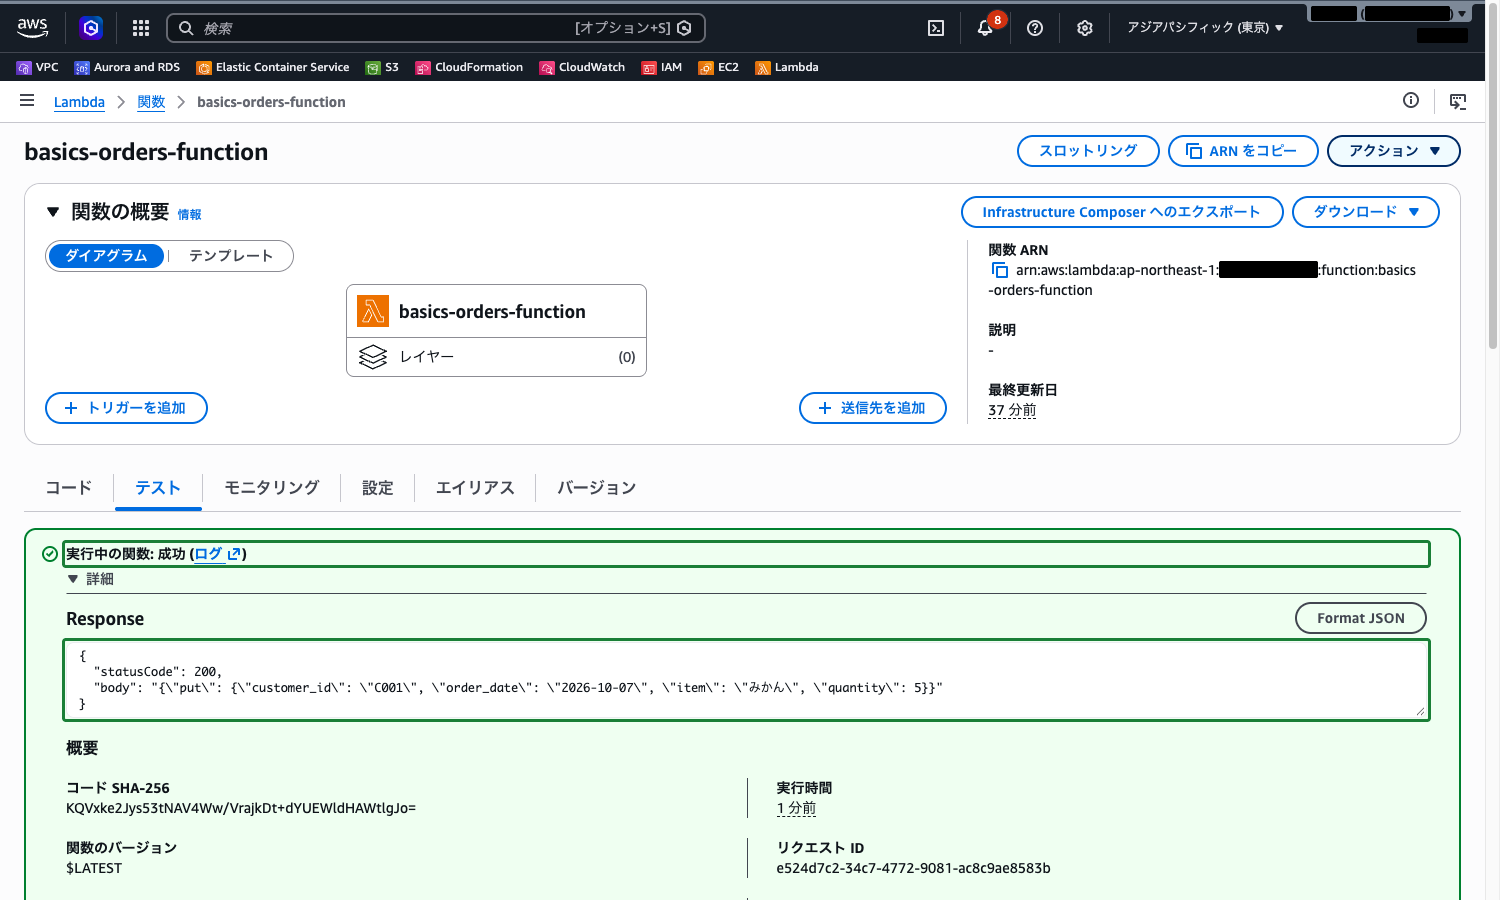
- 「実行中の関数: 成功」と表示されることを確認し、「詳細」を展開して、Response に
"put"と書き込んだ項目が含まれていることを確認します
テストイベントで Query を実行する
- 「テスト」タブで再び「新しいイベントを作成」を選択します
- イベント名に
queryOrdersを入力し、イベント JSON を以下に書き換えます
{
  "action": "query",
  "customer_id": "C001",
  "date_prefix": "2026-10"
}- 「保存」をクリックしてから「テスト」をクリックします
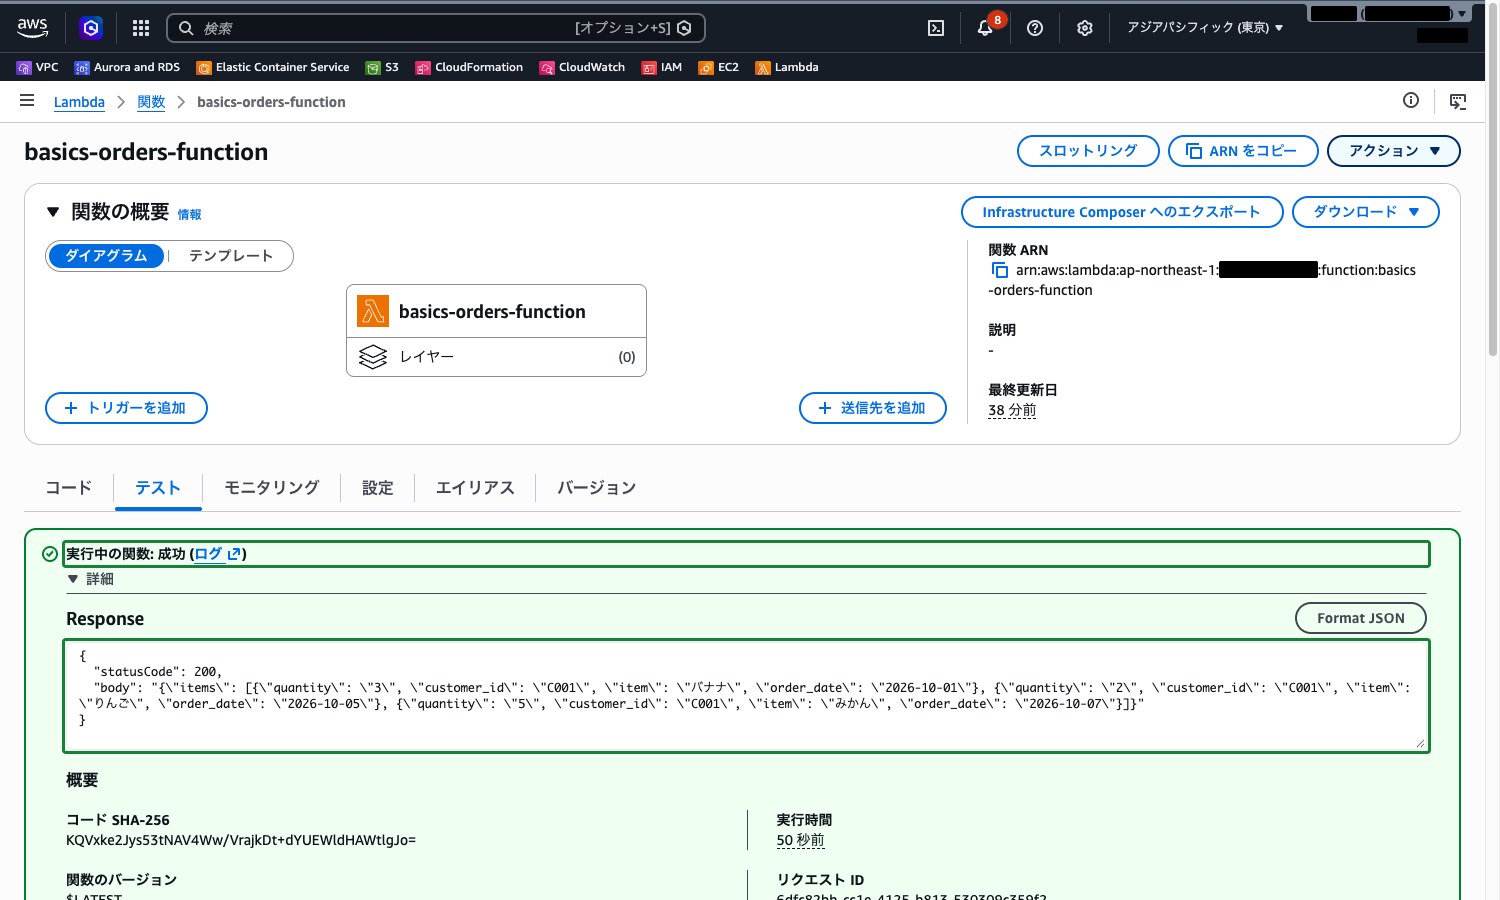
- 「実行中の関数: 成功」と表示されることを確認し、「詳細」を展開して、Response の
itemsにC001の 3 件(コンソールで作成した 2 件と、Lambda から書き込んだ 1 件)がorder_dateの順に含まれていることを確認します
- DynamoDB コンソールの「テーブルアイテムの探索」でも、Lambda から書き込んだ
2026-10-07の項目が追加されていることが確認できます
クラウドおさる実行ロールに付けたのは basics-orders への PutItem と Query だけでござる。猿山の当番に渡す鍵も、使う倉庫の扉の分だけにしておくと安心でござるな。
まとめ
- Amazon DynamoDB はサーバーレス・フルマネージドの NoSQL データベースで、キーバリューモデルとドキュメントデータモデルに対応する
- RDB と違って JOIN はなく、「どのキーで取り出すか」を先に決めてテーブルを設計する
- プライマリキーはパーティションキーのみ、またはパーティションキー + ソートキー(複合プライマリキー)の 2 種類がある
- キャパシティモードはオンデマンド(従量課金・デフォルトで推奨)とプロビジョンド(キャパシティを指定)の 2 つ
- Query はパーティションキーで範囲を絞って読み、Scan はテーブル全体を読む。Scan のフィルター式は読み込み後に適用されるため、消費する読み込みキャパシティは減らない
- GSI でテーブルとは別のキーによる Query ができる。TTL・DynamoDB Streams・ポイントインタイムリカバリ・DAX は役割を押さえておく
- Lambda からは boto3 の
put_item/queryで読み書きでき、実行ロールの権限は対象テーブルと必要なアクションに絞る
関連記事として、Lambda の基本は AWS Lambda で関数を作成しイベント駆動で実行する、IAM ロールとポリシーは AWS IAM でユーザー・ロール・ポリシーを作成しアクセス制御する、今回の関数を HTTP API として公開する仕組みは Amazon API Gateway で REST API を作成しリクエストを処理する で解説しています。
参照先
- Amazon DynamoDB とは
- Amazon DynamoDB のコアコンポーネント
- リレーショナル (SQL) または NoSQL の選択
- DynamoDB のスループットキャパシティ
- DynamoDB オンデマンドキャパシティモード
- DynamoDB プロビジョンドキャパシティモード
- DynamoDB のテーブルに対するクエリの実行
- DynamoDB でのクエリオペレーションのキー条件式
- DynamoDB でのテーブルのスキャン
- DynamoDB のグローバルセカンダリインデックスの使用
- DynamoDB での Time to Live (TTL) の使用
- DynamoDB Streams の変更データキャプチャ
- DynamoDB のポイントインタイムバックアップ
- DynamoDB Accelerator (DAX) とインメモリアクセラレーション
- ステップ 1: DynamoDB にテーブルを作成する
- ステップ 2: DynamoDB テーブルにデータを書き込む
- ステップ 5: DynamoDB テーブル内のデータにクエリを実行
- Python と Boto3 による Amazon DynamoDB のプログラミング
- SDK for Python (Boto3) を使用した DynamoDB の例
- Python による Lambda 関数の構築
- Lambda ランタイム
- AWS Lambda 関数を使用するためのベストプラクティス
- 実行ロールのアクセス許可の表示と更新
- Amazon DynamoDB: 特定のテーブルへのアクセスの許可
- IAM ID のアクセス許可の追加および削除