概要
AWS には目的別のデータベースサービスが数多く用意されています。名前を覚えるだけでは、「この用途ならどれを選ぶか」という問いには答えられません。選ぶときの手がかりになるのは、どんな形でデータを持つか(データモデル) と、運用をどこまで AWS に任せるか の 2 つです。
この記事では、リレーショナル・キーバリュー・ドキュメント・グラフ・ワイドカラム・インメモリ・データウェアハウスというデータモデルごとに代表サービスを整理し、マネージドサービスで AWS が担う範囲、EC2 に自分でデータベースを入れる場合との違い、移行の入口を比較表でまとめます。AWS Certified Cloud Practitioner(CLF)の第 3 分野「クラウドテクノロジーとサービス」のデータベースサービスに当たる内容で、AWS Certified Solutions Architect – Associate(SAA)の学習の土台にもなります。
各サービスを実際に作って動かすのは、サービス別の「基本のキ」記事で扱います。ここでは「いつ、どれを選ぶか」に絞ります。
 クラウドおさる
猿山でもバナナの在庫帳と、猿同士の付き合いの記録は別の帳面につけているでござる。データの形に合わせて入れ物を選ぶ、という話でござるな。
—
この記事のメリット
- データモデルごとに、代表的な AWS のデータベースサービスを選べるようになります
- RDS と Aurora、ElastiCache と DynamoDB など、似た立ち位置のサービスの違いを説明できます
- マネージドデータベースで AWS が担う範囲と、利用者に残る責任を整理できます
- EC2 に自分でデータベースを入れる場合と、RDS を使う場合の違いを説明できます
- データベースを AWS に移すときの入口となるサービス名を把握できます
—
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
クラウドおさるはじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
 クラウドおさる
基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
まずはデータモデルで分ける
クラウドおさるとひさん、AWS のデータベースは名前がたくさんあって、どれを使えばよいか迷うでござる。何から考えればよいのでござるか?
 土肥
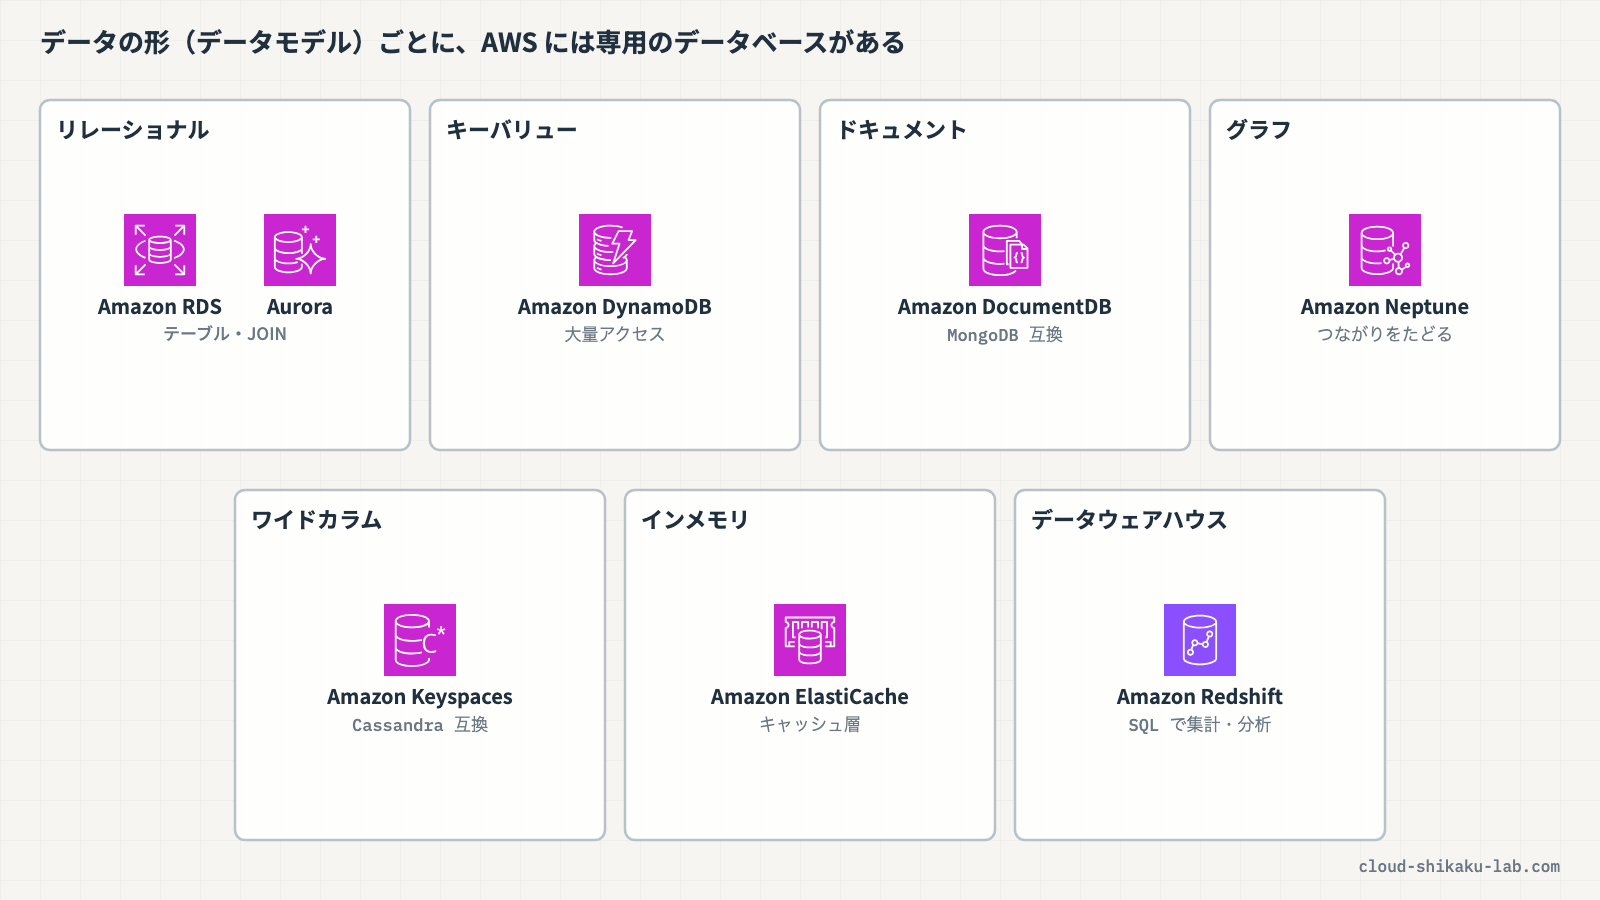
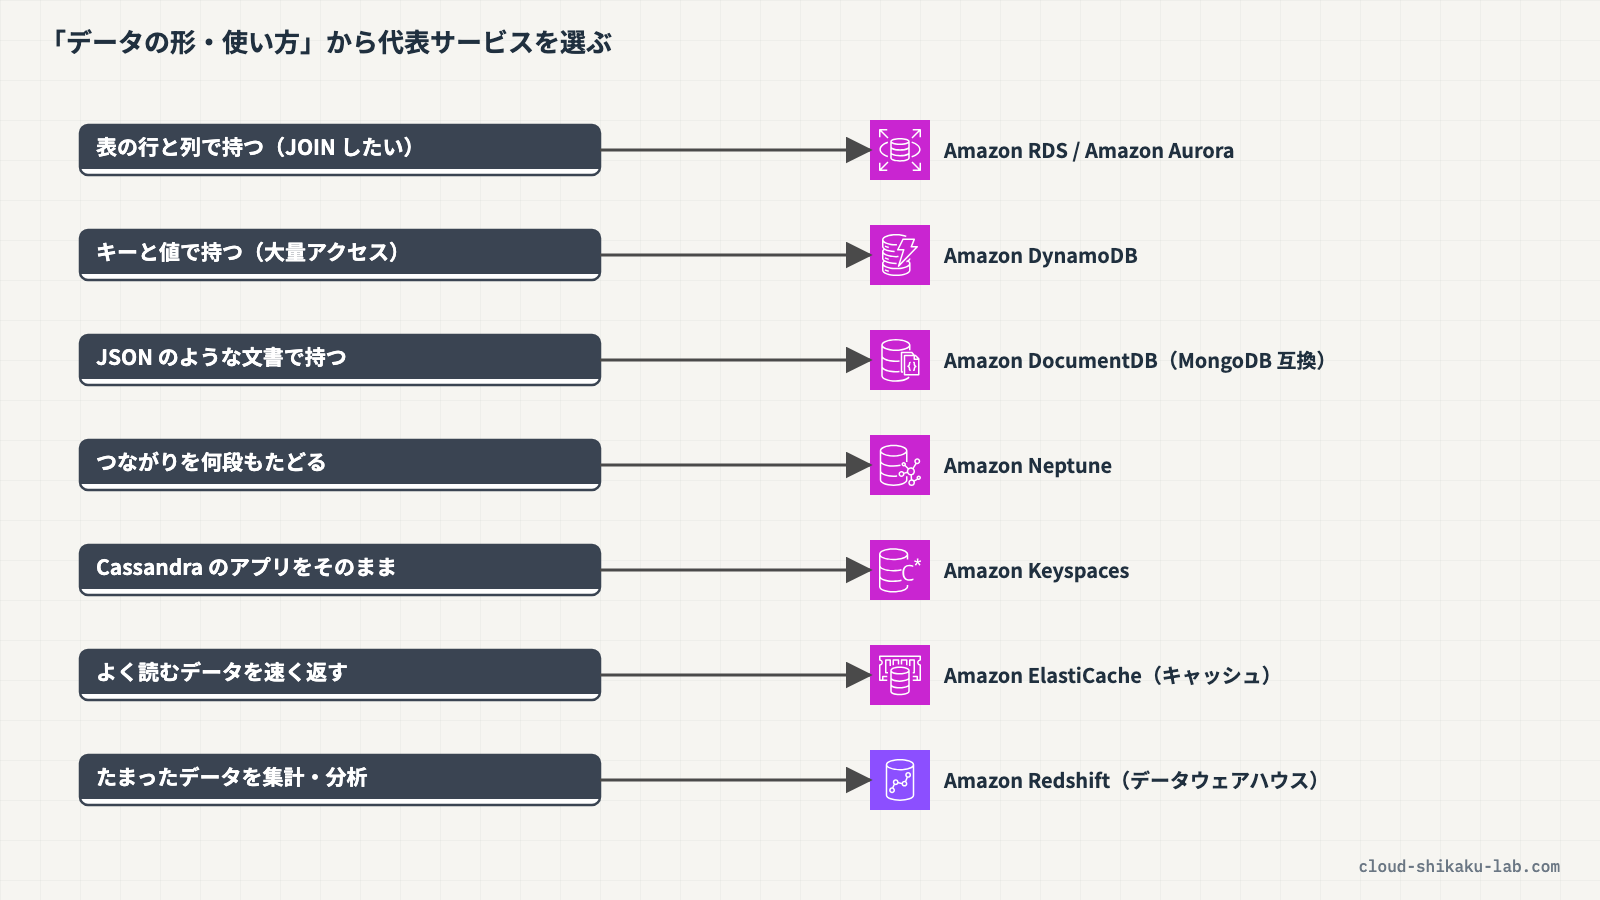
最初は「データをどんな形で持ちたいか」から考えるのがおすすめだよ。表の行と列で持つのか、キーと値のペアで持つのか、JSON のような文書で持つのか、つながりの網で持つのか。AWS はこの形ごとに専用のデータベースを用意しているんだ。
 クラウドおさる
形ごとに専用、でござるか。全部ひとつのデータベースで済ませてはいけないのでござるか?
土肥済ませられる場面もあるけど、データの形と使い方に合ったものを選ぶと、性能も運用も楽になるんだ。まとめるとこんな感じだよ。
| データモデル | 代表サービス | データの持ち方 | 向いている用途 |
|---|---|---|---|
| リレーショナル | Amazon RDS / Amazon Aurora | テーブルの行と列。結合(JOIN)で複雑なクエリができる | 業務システム、EC サイトの受注管理など構造が決まったデータ |
| キーバリュー | Amazon DynamoDB | キーと値のペア(ドキュメント形式も扱える) | セッションストア、ショッピングカートなど大量アクセスをさばく用途 |
| ドキュメント | Amazon DocumentDB(MongoDB 互換) | JSON のような階層を持つドキュメント | 項目が入れ子になった半構造化データ |
| グラフ | Amazon Neptune | ノードと関係(エッジ) | ソーシャルネットワーク、不正検出、レコメンデーション |
| ワイドカラム | Amazon Keyspaces(Apache Cassandra 向け) | Cassandra と同じ列ファミリー型 | オンプレミスの Cassandra の移行、高スループットの読み書き |
| インメモリ | Amazon ElastiCache | メモリ上のキャッシュ | よく読むデータのキャッシュ層で読み取りを速くする |
| データウェアハウス | Amazon Redshift | 分析向けに大量データを集約 | ペタバイト規模のデータを SQL で集計・分析する |
クラウドおさるバナナの在庫帳は表の形だからリレーショナル、猿同士の「誰と誰が仲良し」はつながりの網だからグラフ、ということでござるな!
土肥そうそう、その通り! ちなみに Keyspaces は CLF の試験範囲外のサービスだけど、SAA では選択肢に出てくるから名前と用途だけ押さえておこう。
リレーショナル:RDS と Aurora の違い
クラウドおさるリレーショナルのところに RDS と Aurora が 2 つ並んでいるでござる。どう違うのでござるか?
土肥RDS は、よく使われるリレーショナルデータベースのエンジンを AWS が管理してくれるサービスなんだ。選べるエンジンは MySQL、PostgreSQL、MariaDB、Oracle、Microsoft SQL Server、IBM Db2 の 6 つだよ。
クラウドおさるでは Aurora は、7 つ目のエンジンでござるか?
土肥いい質問だね! Aurora は AWS がクラウド向けに作ったリレーショナルデータベースで、MySQL 互換と PostgreSQL 互換の 2 種類があるんだ。管理は RDS と同じコンソールから行うけど、ストレージの仕組みが違って、必要に応じて自動で拡張されるのが特徴だよ。
| 観点 | Amazon RDS | Amazon Aurora |
|---|---|---|
| エンジン | MySQL / PostgreSQL / MariaDB / Oracle / SQL Server / Db2 | MySQL 互換 / PostgreSQL 互換 |
| 選ぶ場面 | 既存システムと同じエンジンをそのまま使いたい | MySQL・PostgreSQL 系で、より高いスループットや自動拡張するストレージがほしい |
| ストレージ | 割り当てたサイズを使う | 必要に応じて自動で拡張(クラスターボリュームは最大 256 TiB) |
クラウドおさるOracle や SQL Server をそのまま持っていきたいなら RDS、MySQL か PostgreSQL の仲間で性能を求めるなら Aurora、と覚えるでござる。
NoSQL とインメモリ:DynamoDB と ElastiCache
クラウドおさるDynamoDB はよく名前を聞くでござる。リレーショナルと何が違うのでござるか?
土肥DynamoDB はサーバーレスの NoSQL データベースなんだ。サーバーの用意もパッチ当ても要らなくて、あらゆる規模で 1 桁ミリ秒の応答を出せるのが売りだよ。そのかわり、リレーショナルのような JOIN はサポートしていないんだ。
クラウドおさるサーバーを用意しなくてよいのは楽でござるな。データはどこに置かれるのでござる?
土肥既定でリージョン内の 3 つのアベイラビリティーゾーンにレプリケーションされるよ。料金は、読み書きのリクエスト数で払うオンデマンドと、あらかじめキャパシティを決めるプロビジョニングの 2 つから選べるんだ。
クラウドおさるElastiCache も速いと聞いたでござる。DynamoDB と同じ使い方でござるか?
土肥そこは取り違えやすいところだね。ElastiCache は、メインのデータベースの前に置くキャッシュ層なんだ。よく読まれるデータをメモリに置いておいて、読み取りを速くする。エンジンは Valkey、Redis OSS、Memcached から選べるよ。
| 観点 | Amazon DynamoDB | Amazon ElastiCache |
|---|---|---|
| 位置づけ | データを保存するメインのデータベース | 別のデータベースの前に置くキャッシュ |
| データモデル | キーバリュー / ドキュメント | インメモリ(Valkey / Redis OSS / Memcached) |
| 運用 | サーバーレス | サーバーレスキャッシュか、ノードを選ぶクラスターか |
クラウドおさる倉庫そのものが DynamoDB、倉庫の入口に置いた「よく食べるバナナ置き場」が ElastiCache、というわけでござるな。
土肥うまい例えだね。ただ、ElastiCache の前に置く倉庫は DynamoDB に限らず、RDS や Aurora のこともよくあるよ。
ドキュメント・グラフ・ワイドカラム・データウェアハウス
クラウドおさる残りの DocumentDB、Neptune、Keyspaces、Redshift は、どう見分ければよいのでござるか?
土肥それぞれ「互換性」や「得意なこと」がはっきりしているから、キーワードで覚えると早いよ。
| サービス | キーワード | どんなときに選ぶか |
|---|---|---|
| Amazon DocumentDB | MongoDB 互換 | MongoDB で動いているアプリをマネージドで動かしたい、JSON のようなドキュメントを柔軟に検索したい |
| Amazon Neptune | グラフ | 「誰と誰がつながっているか」を何段もたどる。ソーシャル、不正検出、レコメンデーション |
| Amazon Keyspaces | Apache Cassandra 互換・サーバーレス | 既存の Cassandra のアプリやツールをそのまま使いたい |
| Amazon Redshift | データウェアハウス・ペタバイト規模 | 大量のデータを SQL で集計・分析し、BI ツールにつなぎたい |
クラウドおさるRedshift も SQL が使えるなら、RDS と何が違うのでござるか?
土肥使い方が違うんだ。RDS や Aurora は注文を 1 件ずつ登録・更新するような日々の処理向け、Redshift はたまったデータをまとめて集計・分析する向けなんだよ。CLF の試験ガイドでも Redshift は「分析」のサービスに入っているね。
クラウドおさる毎日のバナナの出し入れは RDS、1 年分の出し入れを集計して長老会に報告するのが Redshift、でござるな!
マネージドで AWS が担う範囲 ── EC2 に自分で入れる場合との違い
クラウドおさるデータベースは EC2 にインストールして使うこともできるのでござるか?
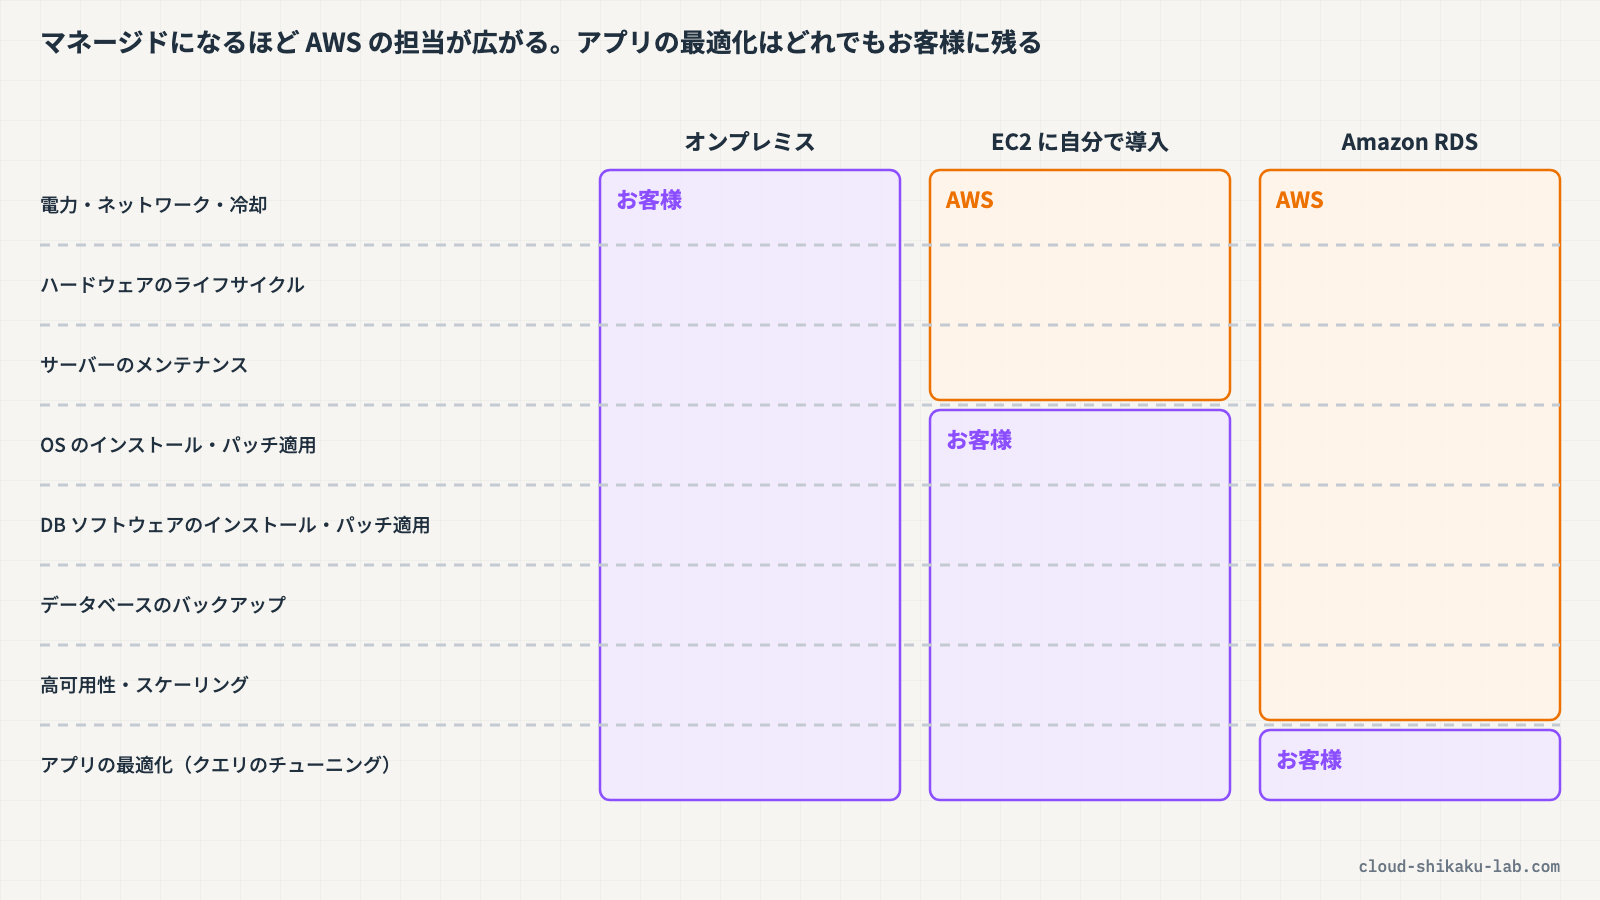
土肥できるよ。ただ、そのときは OS のパッチ当てもデータベースのバックアップも、全部自分でやることになるんだ。RDS のドキュメントに、誰が何を担うかの比較がそのまま載っているよ。
| 作業 | オンプレミス | Amazon EC2 に自分で導入 | Amazon RDS |
|---|---|---|---|
| 電力・ネットワーク・冷却 | お客様 | AWS | AWS |
| ハードウェアのライフサイクル | お客様 | AWS | AWS |
| サーバーのメンテナンス | お客様 | AWS | AWS |
| OS のインストール・パッチ適用 | お客様 | お客様 | AWS |
| データベースソフトウェアのインストール・パッチ適用 | お客様 | お客様 | AWS |
| データベースのバックアップ | お客様 | お客様 | AWS |
| 高可用性・スケーリング | お客様 | お客様 | AWS |
| アプリケーションの最適化(クエリのチューニングなど) | お客様 | お客様 | お客様 |
 クラウドおさる
RDS にしても、クエリのチューニングやデータの設計は自分の仕事として残るのでござるな。「マネージドだから全部おまかせ」ではないでござる。
土肥その通り! これは AWS の責任共有モデルの考え方そのものなんだ。マネージドサービスほど AWS の担当が広がるけど、データそのものやアクセスの管理はお客様側に残る。逆に、OS に手を入れたい、RDS が対応していないエンジンやバージョンを使いたいといった事情があれば、EC2 に自分で入れる選択肢が残るよ。
移行の入口
クラウドおさる今オンプレミスで動いているデータベースを AWS に移すときは、どうするのでござる?
土肥移行の入口として覚えておきたいのが AWS Database Migration Service(AWS DMS) だよ。同じエンジン同士の移行も、異なるエンジンへの移行もできて、1 回限りの移行のほか、変更を継続的にレプリケーションしてソースとターゲットを同期させることもできるんだ。エンジンが変わるときは、スキーマを変換する機能(DMS Schema Conversion)もあるよ。
クラウドおさるデータベースの引っ越しと聞いたら DMS、でござるな。猿山のバナナ倉庫を移すときも、まず引っ越し係を呼ぶのでござる。
AWS の決定ガイドでは、移行の進め方を次の 3 つに整理しています。
| 戦略 | 移行先の例 | 特徴 |
|---|---|---|
| リホスト | EC2 にデータベースエンジンをインストール | クラウドへの近道だが、運用タスクは残る |
| リプラットフォーム | Amazon RDS | 既存のリレーショナルデータベースをフルマネージドに移す |
| リファクタリング | Aurora、DynamoDB、Neptune、DocumentDB など | クラウド向けの専用データベースに作り替える |
—
実践

課金が発生しない範囲で、RDS と DynamoDB のコンソールの作成画面を開き、技術解説で整理した選択肢が実際にどう並んでいるかを確認します。この実践ではリソースを作成しません。 作成ボタンを押す手前で画面を閉じます。
前提条件
- AWS マネジメントコンソールにログイン済みであること(RDS と DynamoDB のコンソールを閲覧できる権限)
- リージョンは
ap-northeast-1(東京)を使用します - 作成するリソースはありません。各画面の最後にある「データベースの作成」「テーブルの作成」ボタンは押さないでください
手順 1: RDS で選べるエンジンを確認する
AWS マネジメントコンソールにログインし、リージョンが ap-northeast-1(東京)であることを確認します。
上部の検索バーに RDS と入力し、表示された「Aurora and RDS」を選択します。
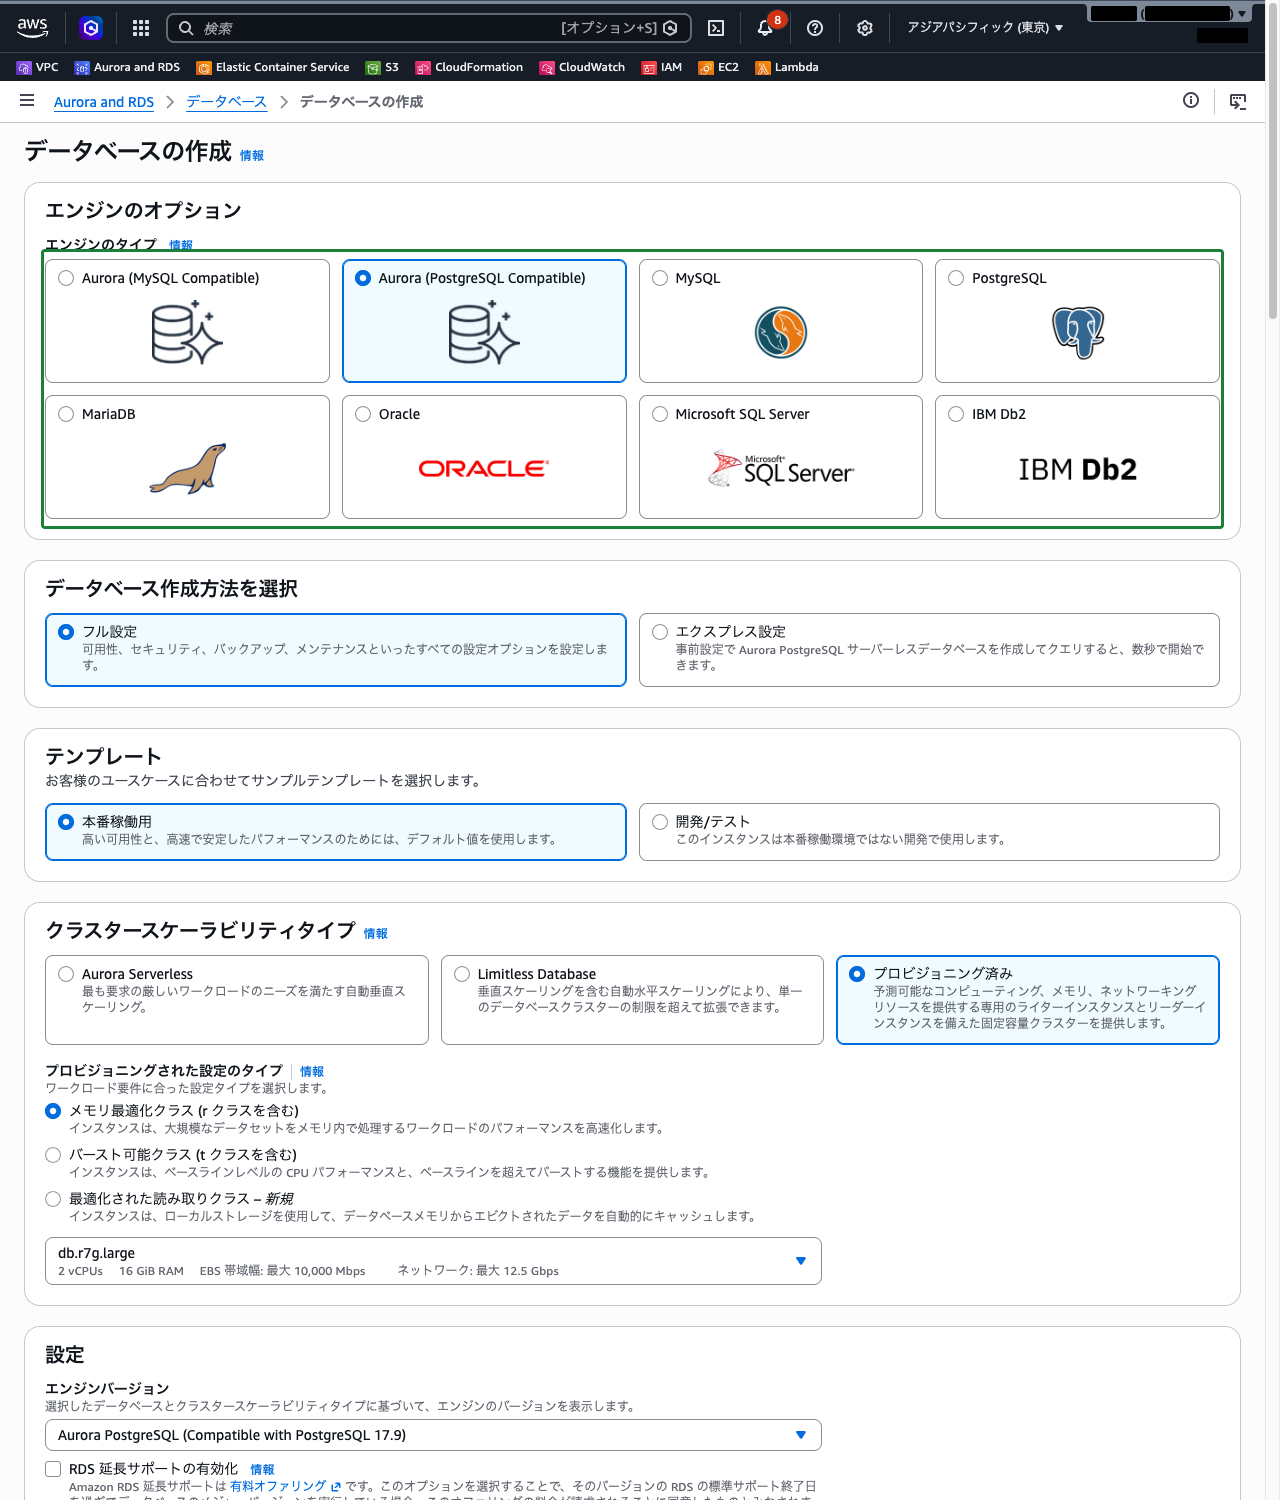
左側ナビゲーションの「データベース」を選択し、右上の「データベースの作成」をクリックして、表示されたメニューから「フル設定」を選択します。
「データベース作成方法を選択」で フル設定 が選ばれていることを確認します(もう 1 つの エクスプレス設定 は、推奨の既定値で手早く作る方法です)。
「エンジンのオプション」に、選べるデータベースエンジンが並びます(最初は Aurora PostgreSQL が選ばれています)。以下を確認します。
- Aurora(MySQL 互換)と Aurora(PostgreSQL 互換)が並んでいること
- MySQL、PostgreSQL、MariaDB、Oracle、Microsoft SQL Server、IBM Db2 の 6 つのエンジンが並んでいること
続けて MySQL を選択し、画面を下へスクロールして「テンプレート」を確認します。本番稼働用 開発/テスト などが並び、選んだテンプレートに応じて「可用性と耐久性」(シングル AZ かマルチ AZ か)の既定値が変わります。バックアップやマルチ AZ が画面上の選択肢になっていることが、「AWS がバックアップや高可用性を担う」という技術解説の表に対応しています。
確認が済んだら、画面下部の「データベースの作成」は押さずに、ブラウザでこのページを離れます。
手順 2: DynamoDB のテーブル作成画面を確認する
上部の検索バーに DynamoDB と入力し、表示された「DynamoDB」を選択します。
左側ナビゲーションの「テーブル」を選択し、右上の「テーブルの作成」をクリックします。
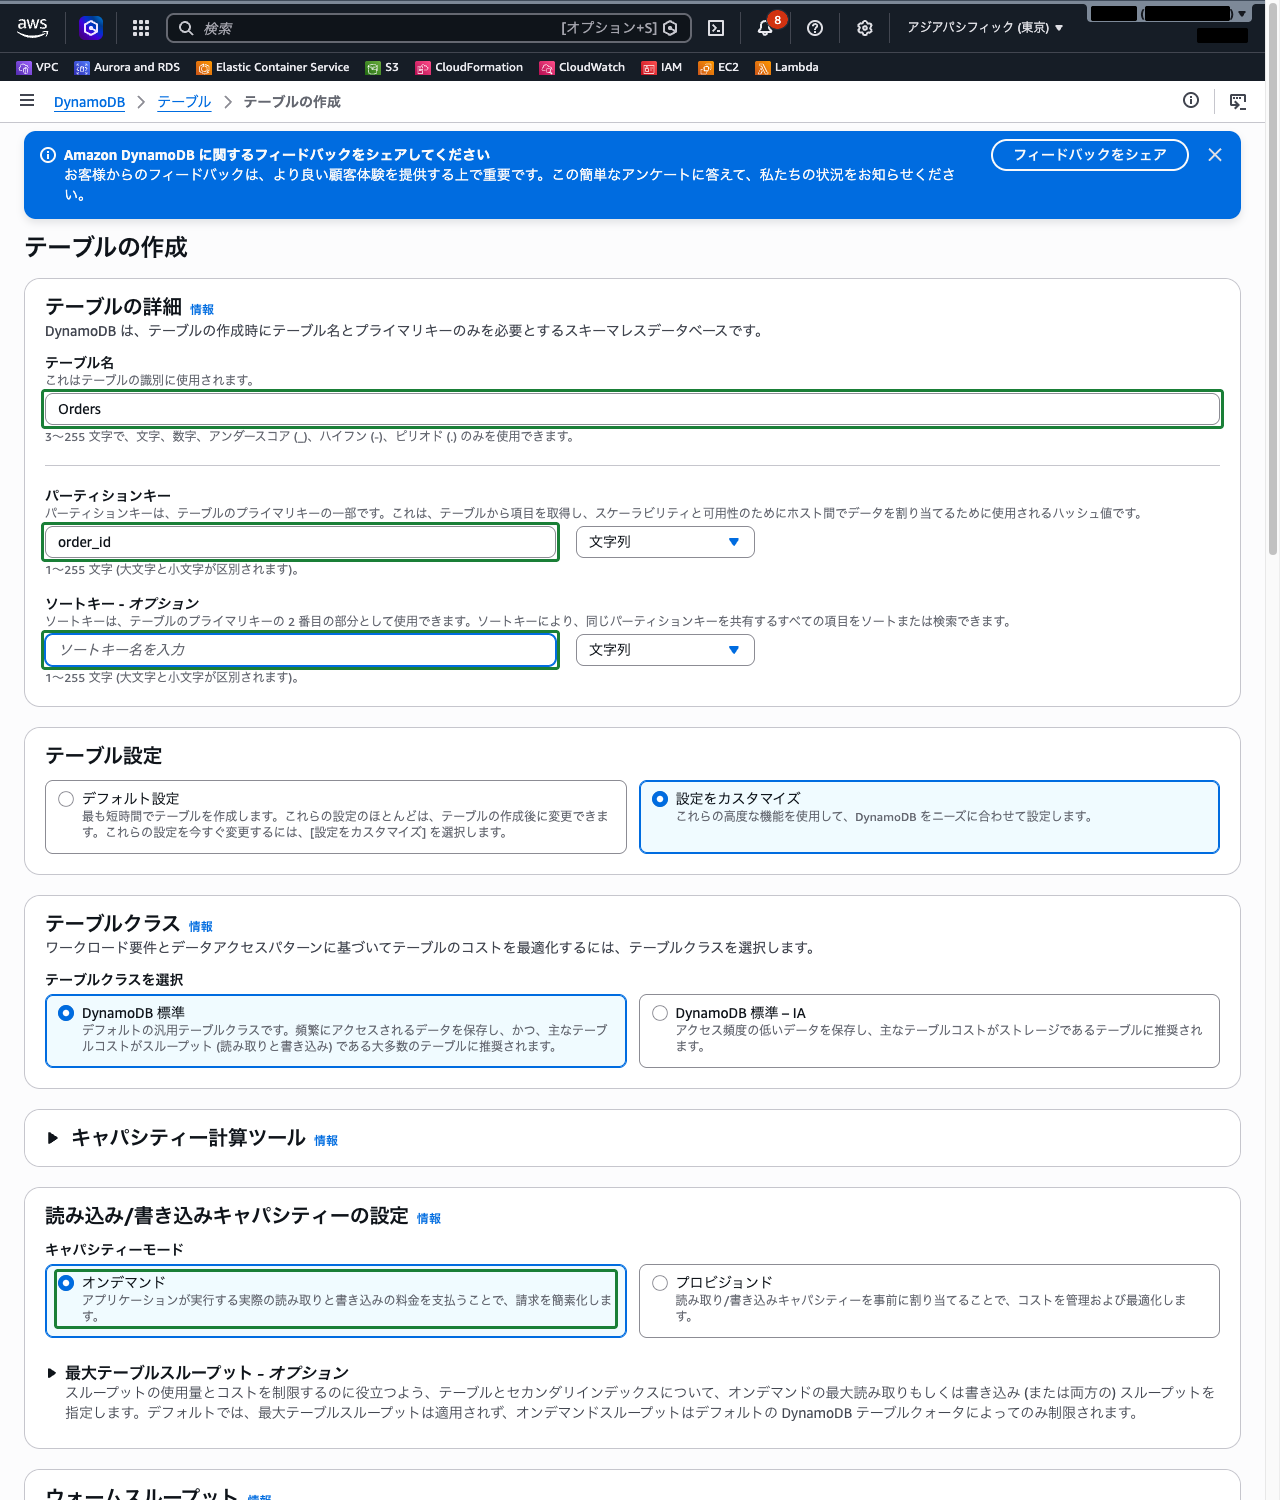
「テーブルの詳細」に以下の入力欄が並んでいることを確認します。
- テーブル名
- パーティションキー
- ソートキー – オプション
インスタンスのサイズやエンジンのバージョンを選ぶ欄はなく、キーを決めればテーブルを作れる画面になっています。RDS の作成画面と比べると、サーバーレスで「サーバーを用意しない」ことが画面からも分かります。
「テーブル設定」で 設定をカスタマイズ を選ぶと、「読み込み/書き込みキャパシティーの設定」に オンデマンド と プロビジョンド が並びます。技術解説で触れた 2 つの料金の払い方です。
確認が済んだら、画面下部の「テーブルの作成」は押さずに、ブラウザでこのページを離れます。
クラウドおさる弊猿が見比べたところ、RDS はエンジンやテンプレートを選ぶ欄がずらり、DynamoDB はキーを決めるだけでござった。運用をどこまで AWS に任せるかが、作成画面の項目の数にも表れているのでござるな。
クラウドおさる試験では「この用途に合うデータベースはどれか」を、データの形と「運用を任せたいか」の 2 つの手がかりから選ばせる観点が多いでござる。DynamoDB と ElastiCache、RDS と Redshift の取り違えには気をつけるでござる。
—
まとめ
| 選ぶ手がかり | 選ぶサービス |
|---|---|
| 表形式のデータを既存と同じエンジンで扱いたい | Amazon RDS |
| MySQL / PostgreSQL 互換で、より高い性能と自動拡張するストレージがほしい | Amazon Aurora |
| サーバーレスで大量アクセスを 1 桁ミリ秒でさばきたい(キーバリュー) | Amazon DynamoDB |
| よく読むデータをメモリに置いて読み取りを速くしたい | Amazon ElastiCache |
| MongoDB 互換のドキュメントデータベースがほしい | Amazon DocumentDB |
| つながり(関係)をたどる検索をしたい | Amazon Neptune |
| Apache Cassandra 互換で使いたい | Amazon Keyspaces |
| 大量データを SQL で集計・分析したい | Amazon Redshift |
| オンプレミスのデータベースを AWS に移したい | AWS DMS |
- データベースは「データの形(データモデル)」で候補を絞り、「運用をどこまで任せるか」で決める
- RDS では OS やデータベースソフトウェアのパッチ、バックアップ、高可用性を AWS が担う。EC2 に自分で入れるとそれらはお客様の担当になる
- マネージドでも、クエリのチューニングやデータの設計はお客様に残る
- ElastiCache はメインのデータベースの前に置くキャッシュ、Redshift は分析用のデータウェアハウス。日々の処理を担うデータベースとは役割が違う
関連記事として、クラウドを使う利点は クラウドコンピューティングとは?AWS クラウドの 6 つの利点、マルチ AZ の前提となるアベイラビリティーゾーンは AWS グローバルインフラストラクチャ:リージョン・AZ・エッジロケーション で解説しています。
—
参照先
- AWS データベースサービスの選択 – AWS 決定ガイド
- データベース – Amazon Web Services の概要
- Amazon Relational Database Service (Amazon RDS) とは – Amazon Relational Database Service
- Amazon RDS DB インスタンスの作成 – Amazon Relational Database Service
- Amazon Aurora とは – Amazon Aurora
- Amazon DynamoDB とは – Amazon DynamoDB
- ステップ 1: DynamoDB にテーブルを作成する – Amazon DynamoDB
- Amazon ElastiCache とは – Amazon ElastiCache
- Amazon DocumentDB (MongoDB 互換) とは – Amazon DocumentDB
- Amazon Neptune とは – Amazon Neptune
- Amazon Keyspaces (Apache Cassandra 向け) とは – Amazon Keyspaces
- Amazon Redshift とは – Amazon Redshift
- とは AWS Database Migration Service – AWS データベース移行サービス