概要
テレビ番組の投票やセールの開始直後のように、短い時間に書き込みが集中すると、Web サーバーを増やしてもデータベースが追いつかなくなります。Web サーバーがデータベースへの書き込み完了を待つ作りだと、データベースの遅れがそのまま利用者のタイムアウトになり、最悪の場合はデータが失われます。
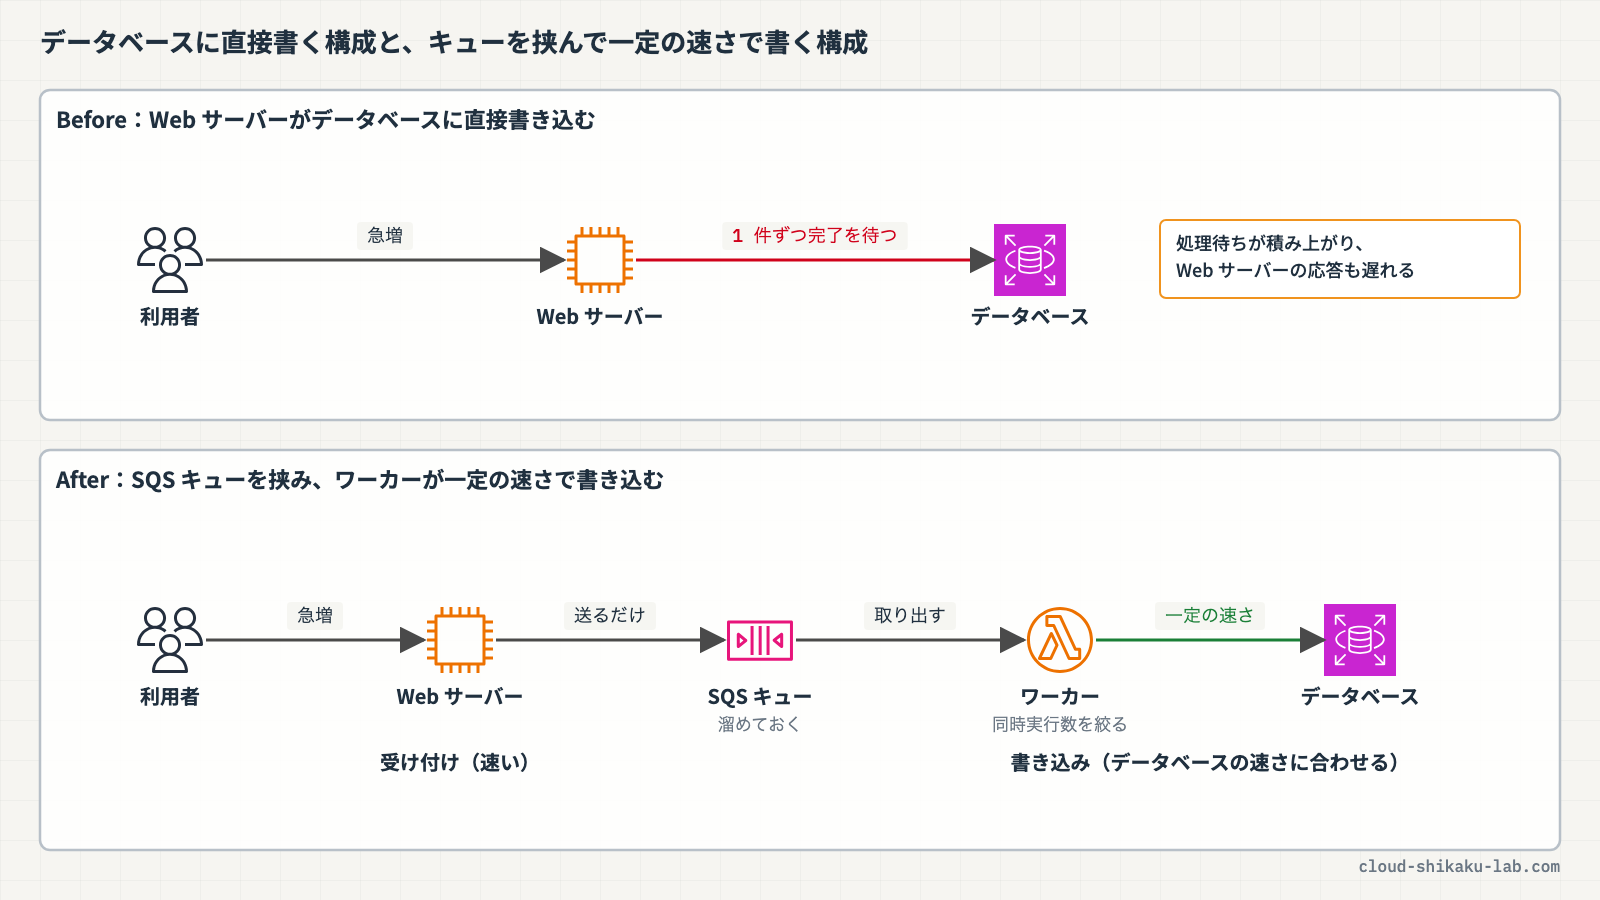
この問題は、「受け付ける処理」と「書き込む処理」をキューで切り離すことで解けます。Web サーバーは Amazon SQS のキューにメッセージを置いたらすぐに応答を返し、ワーカーがキューからメッセージを取り出して、データベースが処理できる速さで書き込みます。キューは急増した分を溜めておく「緩衝材」になります。
この記事では、キューで負荷を平らにする考え方と、データベースの性能を上げる方法との違いを整理します。実践では、同時実行数を 2 に絞った AWS Lambda のワーカーで、一気に送った 1,000 件のメッセージを一定の速さで DynamoDB に書き込み、キューの滞留が増えてから減っていく様子と、1 件も欠けずに書き込まれたことを確かめます。
 クラウドおさる
収穫祭の日は、バナナが一気に倉庫の前に届くでござる。倉庫番が一本ずつ棚に並べるのを待たせず、まずは受け取り箱に入れてもらう。今日はその受け取り箱を SQS で作るでござるよ。
この記事のメリット
- 書き込みの急増に対して、キューで「受け付け」と「書き込み」を切り離す設計を説明できるようになる
- データベースのマルチ AZ 化やインスタンスサイズの変更では、書き込みの詰まりが解けない理由が分かる
- Lambda の SQS トリガーの「最大同時実行数」と「予約済み同時実行数」の違いが分かる
- 可視性タイムアウト・デッドレターキューなど、メッセージを失わないための設定を押さえられる
- 標準キューの「少なくとも 1 回の配信」を前提にした、ワーカー側の作り方が分かる
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
クラウドおさるはじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
 クラウドおさる
基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
書き込みが詰まる理由と、キューで切り離す考え方
Web サーバーがデータベースに直接書き込む構成では、利用者のリクエスト 1 件ごとにデータベースの書き込み完了を待ちます。リクエストが急増すると、データベースの処理待ちが積み上がり、Web サーバーの応答も遅れます。
キューを挟むと、流れが 2 つに分かれます。
| 処理 | 担当 | 速さを決めるもの |
|---|---|---|
| 受け付け | Web サーバー → SQS キュー | キューへの送信だけなので速い。標準キューは 1 秒あたりほぼ無制限の API コールを受けられる |
| 書き込み | ワーカー → データベース | ワーカーの数(同時実行数)で決まる。データベースが処理できる速さに合わせて絞れる |
急増した分はキューに溜まり、ワーカーが一定の速さで少しずつ減らしていきます。データベースから見ると、ピークが「平らにならされた」書き込みになります。このように、部品同士が相手の処理を待たずに動ける構成を疎結合と呼びます。
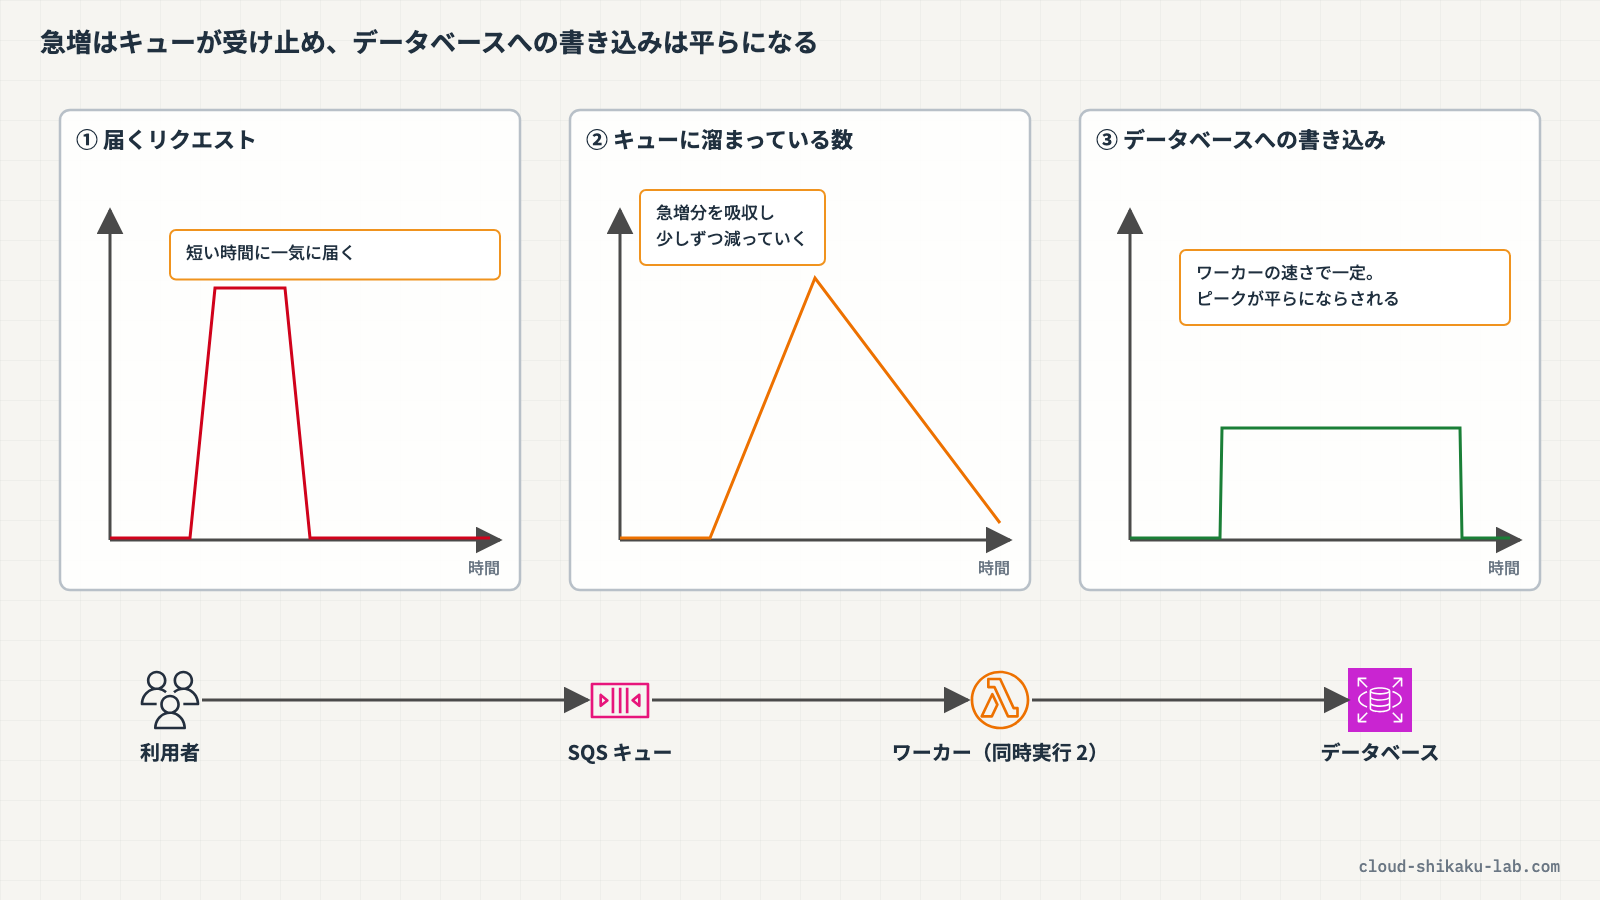 クラウドおさる
受け取り箱があれば、倉庫番は自分の速さで棚に並べればよいのでござる。届く速さと並べる速さを切り離す、これが疎結合の肝でござるな。
データベースの性能を上げる方法との違い
書き込みが追いつかないとき、データベース側を強くする方法も考えられます。ただし、それぞれ効く問題が違います。
| 方法 | 書き込みの急増に効くか | 理由 |
|---|---|---|
| RDS をマルチ AZ にする | 効かない | スタンバイは障害に備えた控えで、書き込みも読み取りも受けない。同期レプリケーションのぶん書き込みの待ち時間はむしろ長くなることがある |
| 投票の時間だけ大きいインスタンスに変える | 一部だけ | 変更のたびに切り替えが要り、想定を超えるピークには追いつかない |
| Web 層をサーバーレスにする | 効かない | 受け付け側が速くなっても、データベースへの書き込みの速さは変わらない |
| キューで受け付けと書き込みを切り離す | 効く | ピークをキューが吸収し、データベースには処理できる速さで書く |
Lambda のワーカーと 2 つの同時実行数
SQS のメッセージを Lambda で処理するときは、Lambda 関数に SQS のトリガー(イベントソースマッピング)を設定します。Lambda がキューをポーリングし、メッセージをまとめて(バッチで)関数に渡します。
標準キューでは、メッセージがあると Lambda は 5 つのバッチを同時に処理し始め、メッセージが残っている間は 1 分あたり最大 300 ずつ処理の数を増やします。何も制限しないと、ワーカーが一気に増えて、守りたいデータベースに負荷が集中します。ワーカーの数を絞る設定は 2 つあります。
| 設定 | 設定する場所 | 何を制限するか |
|---|---|---|
| 最大同時実行数 | SQS トリガー(イベントソースマッピング)。2〜1,000 | そのキューのために Lambda が同時に呼び出す関数の数 |
| 予約済み同時実行数 | 関数 | 関数の同時実行数を確保し、同時にそれを上限にする。追加料金はかからない |
キューのワーカーの数を絞りたいときは、最大同時実行数を使います。予約済み同時実行数だけで絞ると、Lambda がキューから読み出す量と関数が動ける量が合わず、呼び出しがスロットリングされます。スロットリングされた呼び出しは、メッセージが可視性タイムアウトを超えるまで再試行され、超えたメッセージはキューで再び見えるようになります。これを繰り返して受信回数の上限を超えると、デッドレターキューに移ります。
両方を設定する場合は、予約済み同時実行数を、その関数につながるすべての SQS トリガーの最大同時実行数の合計以上にします。
 クラウドおさる
ワーカーの数を絞るなら、トリガー側の「最大同時実行数」でござる。関数側の「予約済み同時実行数」だけで絞ると、取り出したのに処理できないメッセージが出て、スロットリングが起きるのでござるぞ。
メッセージを失わないための設定
キューを挟んでも、ワーカーが失敗したメッセージをどう扱うかを決めておかないと、データが欠けたり同じ処理が繰り返されたりします。
| 設定・作り | 内容 |
|---|---|
| 可視性タイムアウト | ワーカーが受け取ったメッセージを、ほかのワーカーから見えなくする時間。関数のタイムアウトの少なくとも 6 倍にする |
| デッドレターキュー | 何度処理しても失敗するメッセージの退避先。maxReceiveCount(受信回数の上限)は少なくとも 5 にする |
| 冪等な書き込み | 標準キューは「少なくとも 1 回」配信するので、同じメッセージが 2 回届くことがある。同じ ID は 1 回だけ書く作りにする |
| 順序 | 標準キューは送った順序をできるだけ保とうとするが、保証はしない。順序が必要なら FIFO キューを使う |
実践

同時実行数を 2 に絞った Lambda のワーカーに SQS のトリガーを設定し、CloudShell から 1,000 件の投票メッセージを一気に送ります。キューに溜まった投票が一定の速さで DynamoDB に書き込まれ、1 件も欠けないことを確かめます。
前提条件
- リージョン:
ap-northeast-1(東京) - SQS・Lambda・DynamoDB・CloudShell の操作権限を持つ IAM ユーザーまたはロールでコンソールにログイン済みであること
以下のリソースが作成済みであることを前提とします。Lambda 関数 vote-lab-worker は、受け取ったメッセージ 1 件ごとに 0.5 秒かけて DynamoDB に書き込みます(書き込みの遅いデータベースの代わり)。同じ vote_id は 1 回だけ書き込みます。
まだ用意していない場合は、「作り方の参考」の記事の手順で作れます。リソース名は、この記事の名前に読み替えてください。
| リソース種別 | リソース名 | 内容 | 作り方の参考 |
|---|---|---|---|
| SQS キュー | vote-lab-queue | 標準キュー。可視性タイムアウト 180 秒。デッドレターキュー vote-lab-dlq(最大受信数 5) | Amazon SQS でキューを作り、SNS との違いを体験する |
| SQS キュー | vote-lab-dlq | デッドレターキュー | 同上 |
| Lambda 関数 | vote-lab-worker | Python。タイムアウト 30 秒。SQS の読み取りと DynamoDB への書き込み権限を持つ実行ロール | AWS Lambda で関数を作成しイベント駆動で実行する |
| DynamoDB テーブル | vote-lab-votes | パーティションキー vote_id(文字列)。オンデマンド | Amazon DynamoDB でテーブルを作り Lambda から読み書きする |
手順 1: Lambda に SQS のトリガーを設定し、最大同時実行数を絞る
AWS マネジメントコンソールにログインし、リージョンが ap-northeast-1(東京)であることを確認します。
上部の検索バーに Lambda と入力し、「Lambda」を選択します。「関数」から vote-lab-worker を開き、「関数の概要」の図にある「トリガーを追加」をクリックします。以下を設定します。
- ソース:
SQS - SQS キュー:
vote-lab-queue(候補から選ぶと、キューの ARN が入ります) - バッチサイズ:
10(デフォルト) - 最大同時実行数:
2(デフォルトは空欄) - トリガーをアクティブ化: オンのまま(デフォルト)
その他の項目はデフォルトのままにして、「追加」をクリックします。
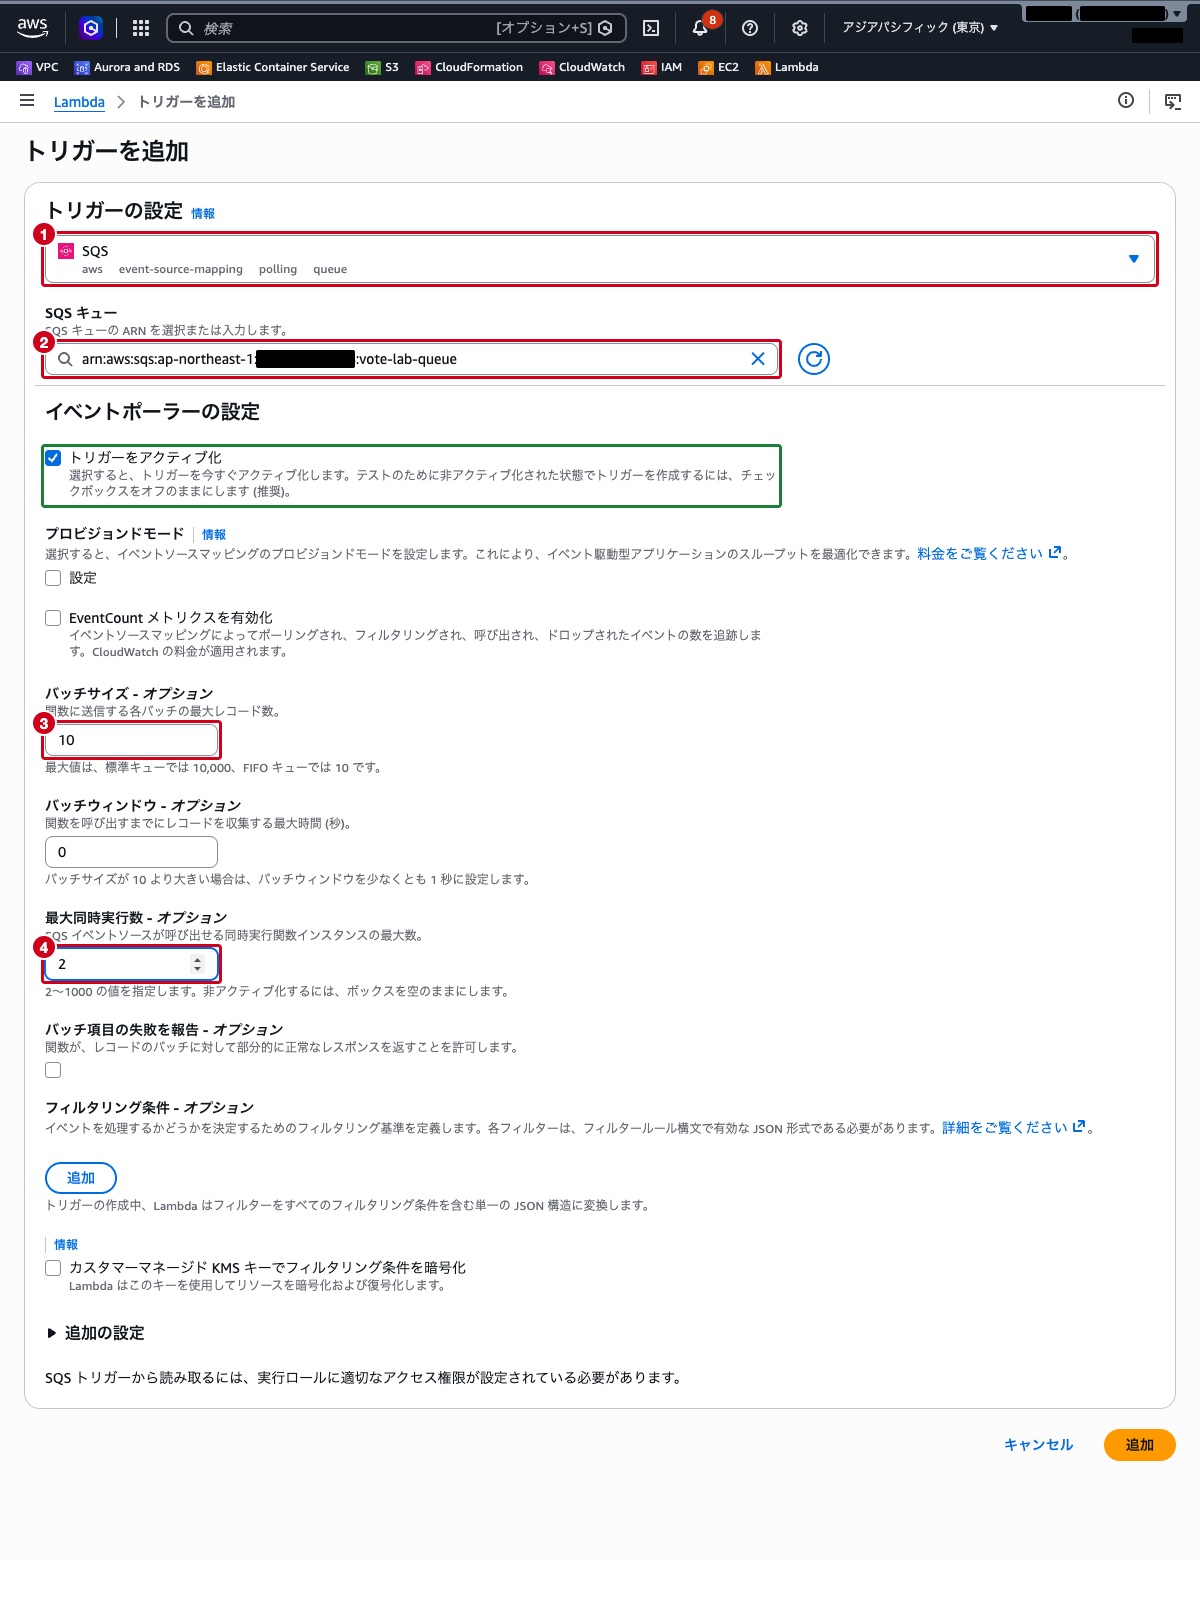
「設定」タブの「トリガー」で、vote-lab-queue のトリガーの状態が Creating から Enabled に変わり、最大同時実行数が 2 であることを確認します。
手順 2: CloudShell から 1,000 件の投票を一気に送る
コンソール上部の CloudShell アイコンから CloudShell を開き、次のコマンドを実行します。10 件ずつまとめて送る send-message-batch を 100 回繰り返し、1,000 件の投票を送ります。
QUEUE_URL=$(aws sqs get-queue-url --queue-name vote-lab-queue --query QueueUrl --output text)
for b in $(seq 1 100); do
  ENTRIES=$(for i in $(seq 1 10); do
    n=$(( (b - 1) * 10 + i ))
    printf '{"Id":"m%d","MessageBody":"{\\"vote_id\\":\\"v%04d\\",\\"choice\\":\\"%s\\"}"}\n' \
      "$i" "$n" "$(shuf -n1 -e A B C)"
  done | jq -s .)
  aws sqs send-message-batch --queue-url "$QUEUE_URL" --entries "$ENTRIES" \
    --query 'length(Successful)' --output text
done | awk '{s+=$1} END {print "送信成功:", s, "件"}'「送信成功: 1000 件」と表示されることを確認します。
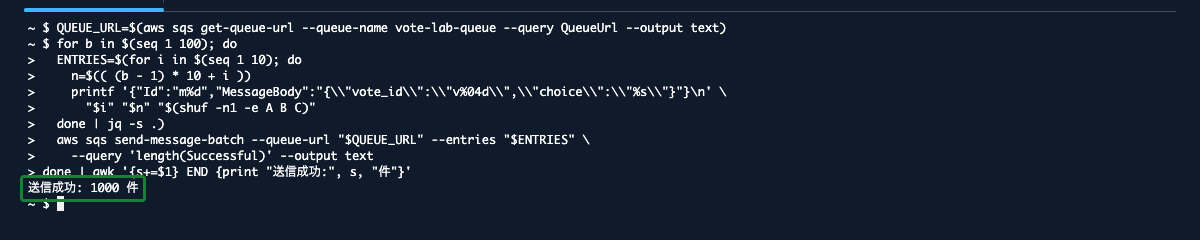
手順 3: キューに溜まった投票が一定の速さで減っていくことを確かめる
上部の検索バーに SQS と入力し、「Simple Queue Service」を選択します。
「キュー」の一覧で、vote-lab-queue の「利用可能なメッセージ」と「処理中のメッセージ」の列を確認します。送信直後は利用可能なメッセージが数百〜800 件ほど溜まっており、画面を更新するたびに少しずつ減っていきます。処理中のメッセージは、2 つのワーカーが受け取っている 20 件以下(0・10・20 を行き来します)にとどまります。
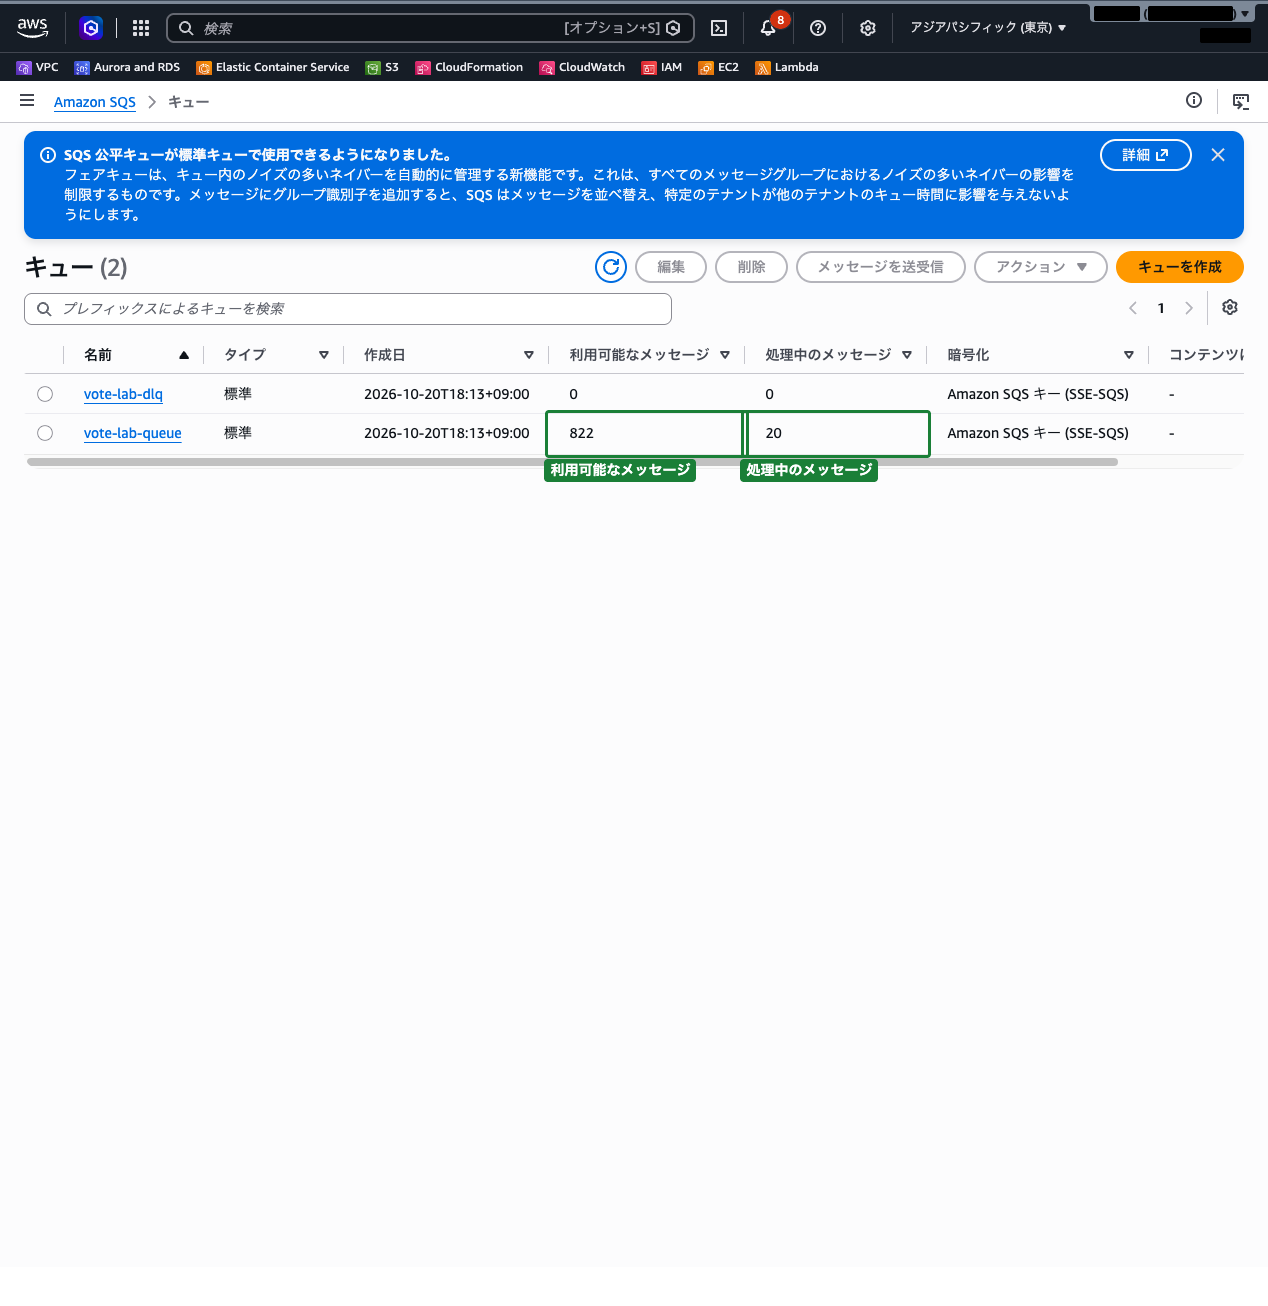
ワーカーは 2 つ、1 件あたり 0.5 秒かかるので、書き込みは多くても 1 秒あたり 4 件ほどです。実際には Lambda の起動やキューの受信の時間も加わり、今回は送信を始めてから書き終わるまで 6 分ほどかかりました。
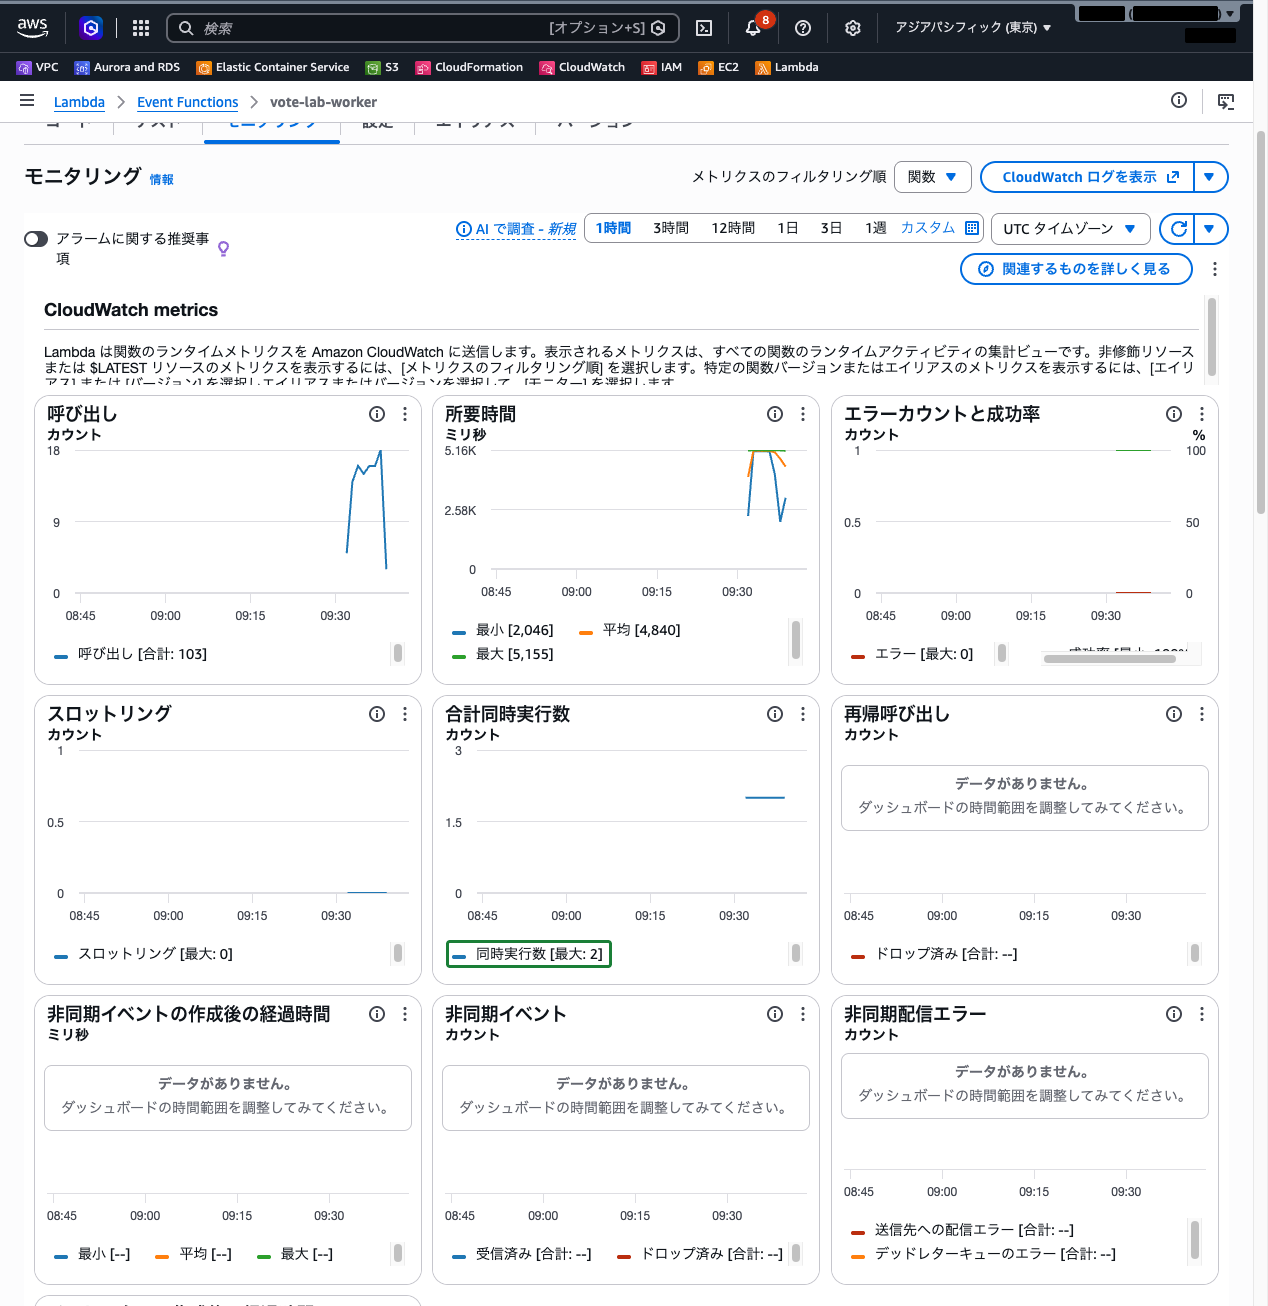
Lambda コンソールに戻り、vote-lab-worker の「モニタリング」タブを開きます。「合計同時実行数」のグラフで、同時実行数が 2 を超えていないことを確認します(凡例に「同時実行数 [最大: 2]」と表示されます)。グラフに反映されるまで数分かかり、時刻は UTC で表示されます。
 クラウドおさる
受け取り箱にはバナナが山になっているのに、倉庫番は 2 匹のまま、同じ速さで並べ続けているでござる。倉庫の棚が崩れないのは、この速さを決めているのが届く側ではなく並べる側だからでござるな。
手順 4: 1 件も欠けずに書き込まれたことを確かめる
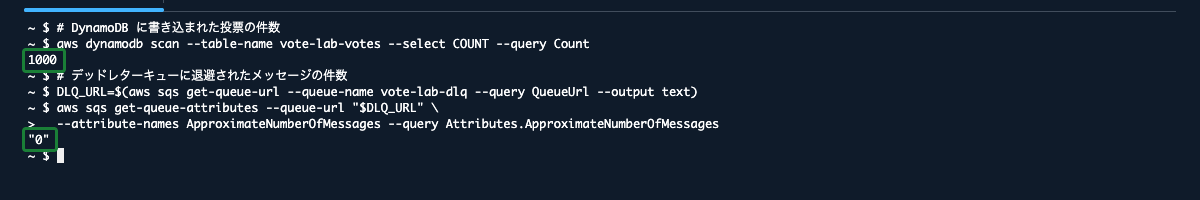
SQS コンソールのキューの一覧で、vote-lab-queue の「利用可能なメッセージ」と「処理中のメッセージ」がどちらも 0 になったら、CloudShell で次のコマンドを実行します。
# DynamoDB に書き込まれた投票の件数
aws dynamodb scan --table-name vote-lab-votes --select COUNT --query Count
# デッドレターキューに退避されたメッセージの件数
DLQ_URL=$(aws sqs get-queue-url --queue-name vote-lab-dlq --query QueueUrl --output text)
aws sqs get-queue-attributes --queue-url "$DLQ_URL" \
--attribute-names ApproximateNumberOfMessages --query Attributes.ApproximateNumberOfMessages投票の件数が 1000、デッドレターキューのメッセージが "0" になっていることを確認します。急増した 1,000 件の投票が、データベースの速さに合わせて 1 件も欠けずに書き込まれました。
 クラウドおさる
「データベースが書き込みに追いつかない」ときに、マルチ AZ やインスタンスの付け替えを選びたくなるでござる。けれど、ピークを吸収できるのはキューで受け付けと書き込みを切り離す形だけ。何が詰まっているのかを見極めるのが要でござるな。
まとめ
| 要件 | 選ぶもの |
|---|---|
| 書き込みの急増からデータベースを守り、データを失わない | SQS キューで受け付けと書き込みを切り離す(疎結合) |
| キューのワーカーの数を絞る | Lambda の SQS トリガーの最大同時実行数(2〜1,000) |
| 関数の同時実行数を確保し、上限にする | 予約済み同時実行数(キューのワーカーを絞る目的だけで使うとスロットリングが起きる) |
| 何度処理しても失敗するメッセージを退避する | デッドレターキュー(maxReceiveCount は少なくとも 5) |
| 送った順序どおりに処理する | FIFO キュー(標準キューは順序を保証しない) |
- 標準キューは 1 秒あたりほぼ無制限の API コールを受けられ、ピークをキューが吸収する
- マルチ AZ のスタンバイは書き込みを受けないので、書き込みの急増には効かない
- 可視性タイムアウトは関数のタイムアウトの少なくとも 6 倍にする
- 標準キューは「少なくとも 1 回」配信するので、ワーカーは同じメッセージを 2 回受けても結果が変わらない作りにする
参照先
- Amazon SQS の標準キュー – Amazon Simple Queue Service
- SQS イベントソースマッピングのスケーリング動作の設定 – AWS Lambda
- Amazon SQS イベントソースマッピングの作成と管理 – AWS Lambda
- Lambda での SQS イベントソースのエラーの処理 – AWS Lambda
- 関数に対する予約済み同時実行数の設定 – AWS Lambda