概要
EC2 インスタンスを 1 台だけで Web サーバーとして動かしていると、そのインスタンスが停止した時点でサービスも止まります。台数を増やしても、壊れたインスタンスを人が見つけて作り直す運用のままでは、復旧までの時間は人の対応速度に左右されます。
Amazon EC2 Auto Scaling は、あらかじめ決めた台数の EC2 インスタンスを維持し、異常になったインスタンスや終了したインスタンスを自動で置き換えるサービスです。負荷に応じて台数を増減させるスケーリングポリシーも設定できます。Elastic Load Balancing と組み合わせると、「ロードバランサーの裏で、落ちても自動で戻る Web サーバー群」を作れます。
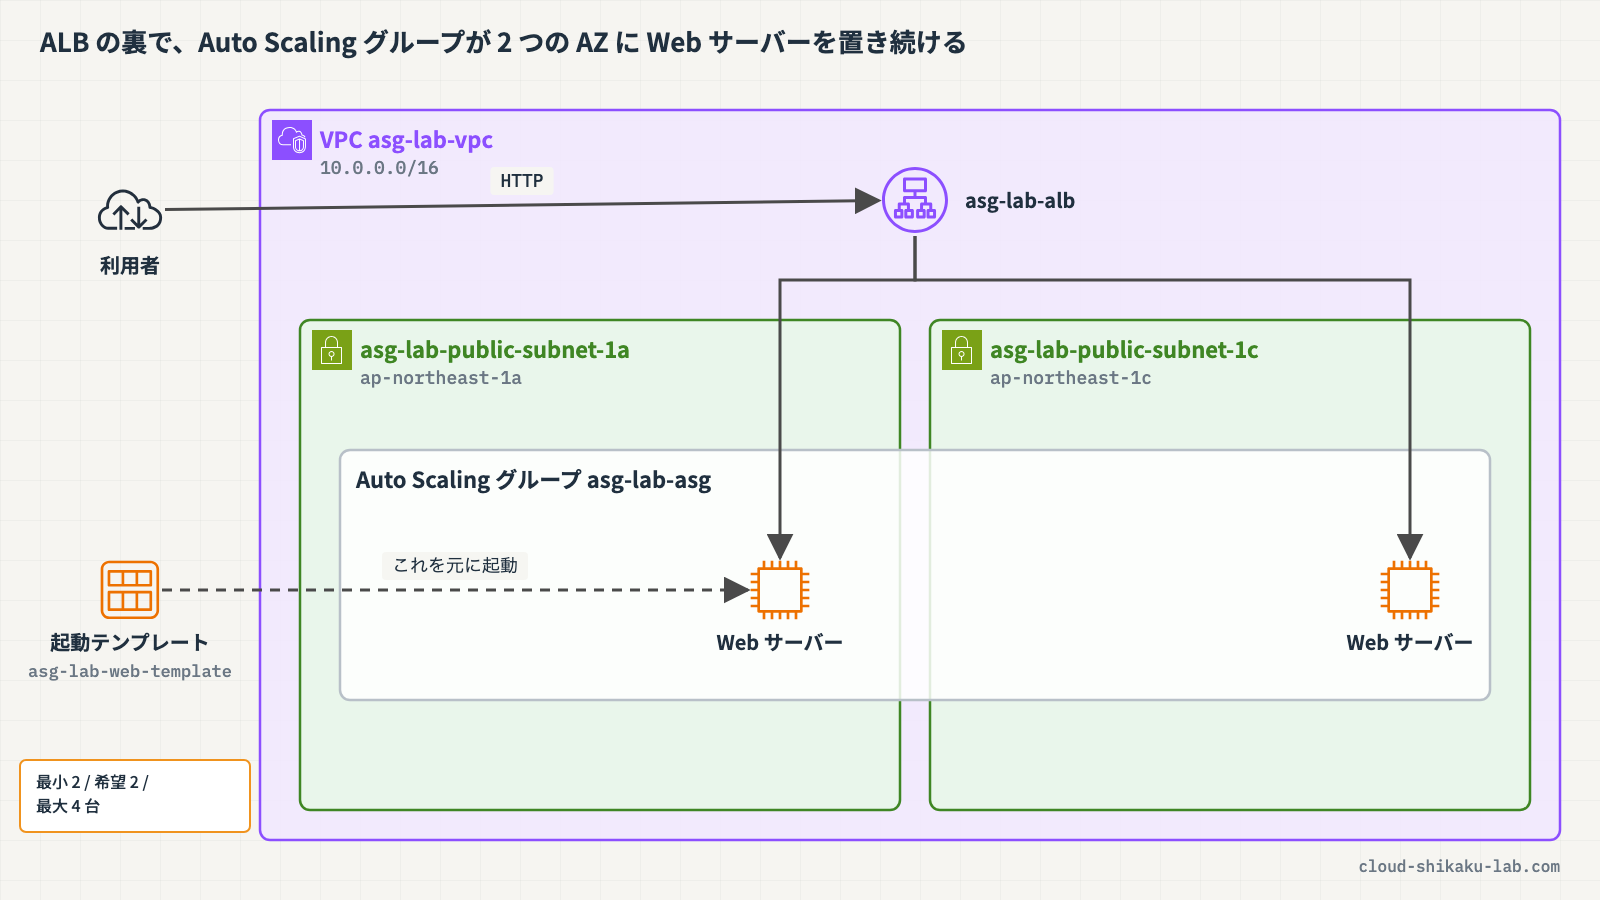
この記事では、起動テンプレートと Auto Scaling グループの基本を押さえたうえで、2 つのアベイラビリティーゾーン(AZ)にまたがる Web サーバー群を Application Load Balancer(ALB)の裏に作ります。インスタンスを 1 台わざと終了して自動で置き換わる様子を確かめ、最後に CPU 使用率に応じて台数を調整するターゲット追跡スケーリングポリシーを設定します。EC2 インスタンスの起動や VPC の基本は、Amazon EC2 でインスタンスを起動しSSH接続する と Amazon VPC で仮想ネットワークを構築しサブネットを設定する で扱っています。
 クラウドおさる
今日は「倒れても勝手に起き上がる Web サーバー」を作るのでござる。猿山の見張り台も、当番の猿が倒れたら控えの猿がすぐ登る決まりでござるが、それを AWS が自動でやってくれるか確かめるでござる!
この記事のメリット
- 起動テンプレートと Auto Scaling グループの役割の違いを理解できる
- 最小・希望・最大の 3 つの容量が何を決めているかを把握できる
- EC2 ヘルスチェックと ELB ヘルスチェックの違いを理解できる
- ターゲット追跡・ステップ・スケジュールの各スケーリングの使い分けを把握できる
- ALB の裏に、インスタンスが落ちても自動で置き換わる Web サーバー群を作る手順を体験できる
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
 クラウドおさる
はじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
クラウドおさる基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
EC2 Auto Scaling とは
クラウドおさるとひさん、EC2 Auto Scaling とはどんなサービスでござるか? 名前からすると、台数を増やしたり減らしたりするものでござるか?
 土肥
それも正解なんだけど、実はもう 1 つ大事な役割があるんだ。EC2 Auto Scaling は、決めた台数の EC2 インスタンスが動いている状態を保ってくれるサービスだよ。インスタンスの状態を監視していて、終了したり異常になったりしたインスタンスがあれば、新しいインスタンスに置き換えてくれるんだ。
クラウドおさるなんと、増減よりも先に「減ったら補充する」のでござるな! 猿山の見張り台で、当番が倒れたら控えが登るのと同じでござる。
土肥そうそう、まさにそのイメージ! 主な機能をまとめるとこんな感じだよ。
| 機能 | 内容 |
|---|---|
| ヘルスのモニタリングと置き換え | ヘルスチェックで異常と判断したインスタンスや、終了したインスタンスを置き換えて、希望する台数を保つ |
| AZ 間のバランス調整 | 複数の AZ を指定すると、AZ 間でインスタンスの数がそろうように起動する |
| スケーリング | スケーリングポリシーやスケジュールに従って台数を増減する |
 クラウドおさる
そんなに便利だと、バナナがたくさん要りそうでござる……。
土肥EC2 Auto Scaling 自体には追加料金はかからないんだ。料金がかかるのは、起動した EC2 インスタンスや EBS ボリューム、CloudWatch アラームみたいに、実際に使った AWS リソースの分だけだよ。
起動テンプレート
クラウドおさる新しいインスタンスに置き換えるとき、どんなインスタンスを作ればよいかは、どうやって知るのでござるか?
土肥そこで使うのが起動テンプレートだよ。AMI の ID、インスタンスタイプ、キーペア、セキュリティグループ、ユーザーデータみたいな「インスタンスを起動するための設定」をまとめておくものなんだ。Auto Scaling グループは、この起動テンプレートを使ってインスタンスを起動するよ。
クラウドおさる見張り当番の「持ち物リスト」のようなものでござるな。控えの猿は、そのリストどおりに支度して登るわけでござる。
土肥うまいね! それに起動テンプレートはバージョン管理ができるから、AMI を新しくしたいときは新しいバージョンを作ればいいんだ。ちなみに、似たものに「起動設定」っていう古い仕組みもあるけど、複数のインスタンスタイプを使えないなど機能に制限があるから、今は起動テンプレートを使うのが推奨だよ。
クラウドおさる起動テンプレートにはサブネットも書くのでござるか?
土肥書くこともできるけど、Auto Scaling グループで使うときはサブネットを指定しなくていいんだ。どのサブネットに置くかは Auto Scaling グループ側で決めて、そっちが優先されるからね。今回の実践でも、起動テンプレートにはサブネットを入れないよ。
Auto Scaling グループと 3 つの容量
クラウドおさるAuto Scaling グループというのは、インスタンスの集まりのことでござるか?
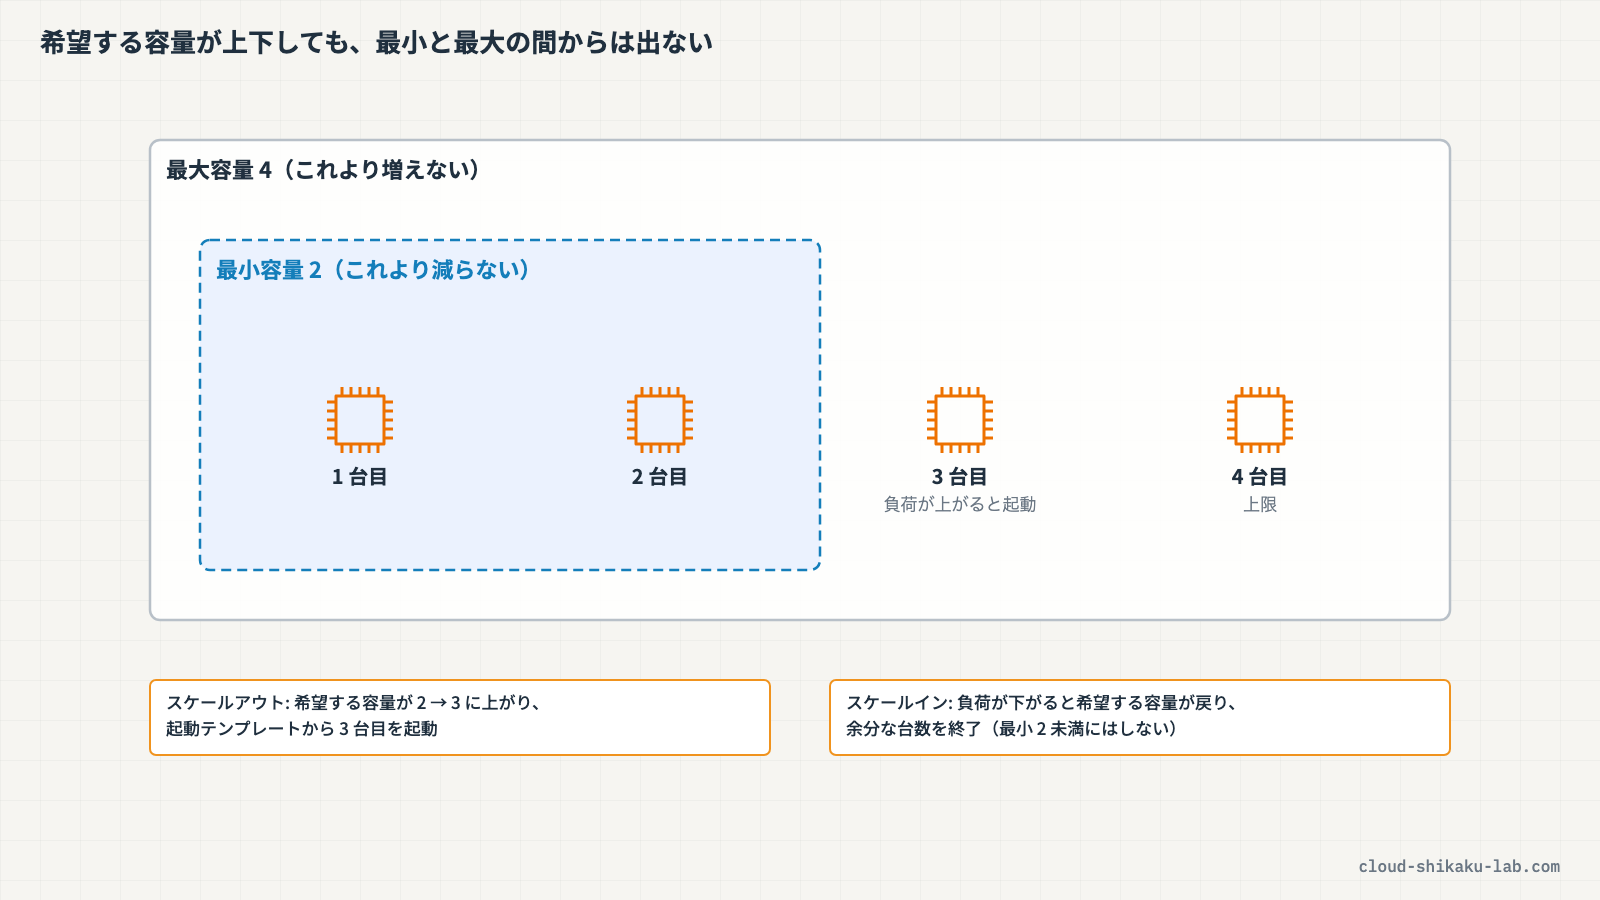
土肥そうだよ。台数の管理やスケーリングをするときの単位になる、EC2 インスタンスのまとまりなんだ。グループには 3 つの容量を設定するよ。
| 項目 | 意味 |
|---|---|
| 最小容量 | グループがこれより少なくなることはない |
| 希望する容量 | いま動かしておきたい台数。EC2 Auto Scaling はインスタンス数をこの数に合わせる |
| 最大容量 | グループがこれより多くなることはない |
土肥たとえば最小 2・希望 2・最大 4 にしておくと、普段は 2 台で動いて、1 台が終了したら 2 台に戻るように補充される。スケーリングポリシーで台数を増やすときも、4 台より多くはならないんだ。
クラウドおさる最低でも 2 匹は見張り台に立たせて、忙しい日でも 4 匹までにする、という長老会の決まりのようでござるな!
土肥そのとおり! スケーリングポリシーが動かしているのは「希望する容量」で、最小と最大はその上下の柵だと思っておくとわかりやすいかな。
 クラウドおさる
希望する容量を大きくすると、その台数ぶん EC2 インスタンスが動き続けるのでござるな。うっかり大きな数を入れると、バナナがどんどん減っていくでござる……。
複数 AZ への分散
クラウドおさるインスタンスを何台も並べても、同じ AZ にまとめて置いていたら、その AZ ごと止まったときに全滅するのではござらぬか?
土肥いいところに気づいたね! だから Auto Scaling グループには複数の AZ のサブネットを指定するんだ。そうすると、AZ 間でインスタンス数がそろうように起動してくれるよ。1 か所で障害が起きても、ほかの AZ のインスタンスでアプリケーションを動かし続けられるんだ。
クラウドおさるもし片方の AZ でインスタンスを起動できなかったら、どうなるのでござる?
土肥デフォルトの「バランシング(ベストエフォート)」っていう分散の戦略だと、起動に失敗した AZ の代わりに、別の正常な AZ でインスタンスを起動しようとするよ。今回の実践では ap-northeast-1a と ap-northeast-1c の 2 つの AZ に 1 台ずつ置く構成にするね。
クラウドおさる見張り台を東の峰と西の峰に分けておけば、片方に雷が落ちても見張りは続けられるのでござるな。
ヘルスチェック(EC2 と ELB)
クラウドおさる「異常になったら置き換える」と聞いたでござるが、異常かどうかは誰が判断するのでござるか?
土肥それがヘルスチェックだよ。Auto Scaling グループでは、組み込みの EC2 ステータスチェックがいつも動いていて、それに加えて ELB や VPC Lattice、EBS、独自のカスタムヘルスチェックを追加で使えるんだ。基本の 2 つを比べるとこうなるよ。
| ヘルスチェック | 見ているもの | 使い方 |
|---|---|---|
| EC2 ヘルスチェック | EC2 のステータスチェック(インスタンスが動いているか、ハードウェアなどに問題がないか) | 常に有効 |
| ELB ヘルスチェック | ロードバランサーのターゲットグループのヘルスチェック結果(アプリケーションが応答しているか) | 「Elastic Load Balancing のヘルスチェックをオンにする」で追加する |
クラウドおさるEC2 ヘルスチェックだけでは足りないのでござるか?
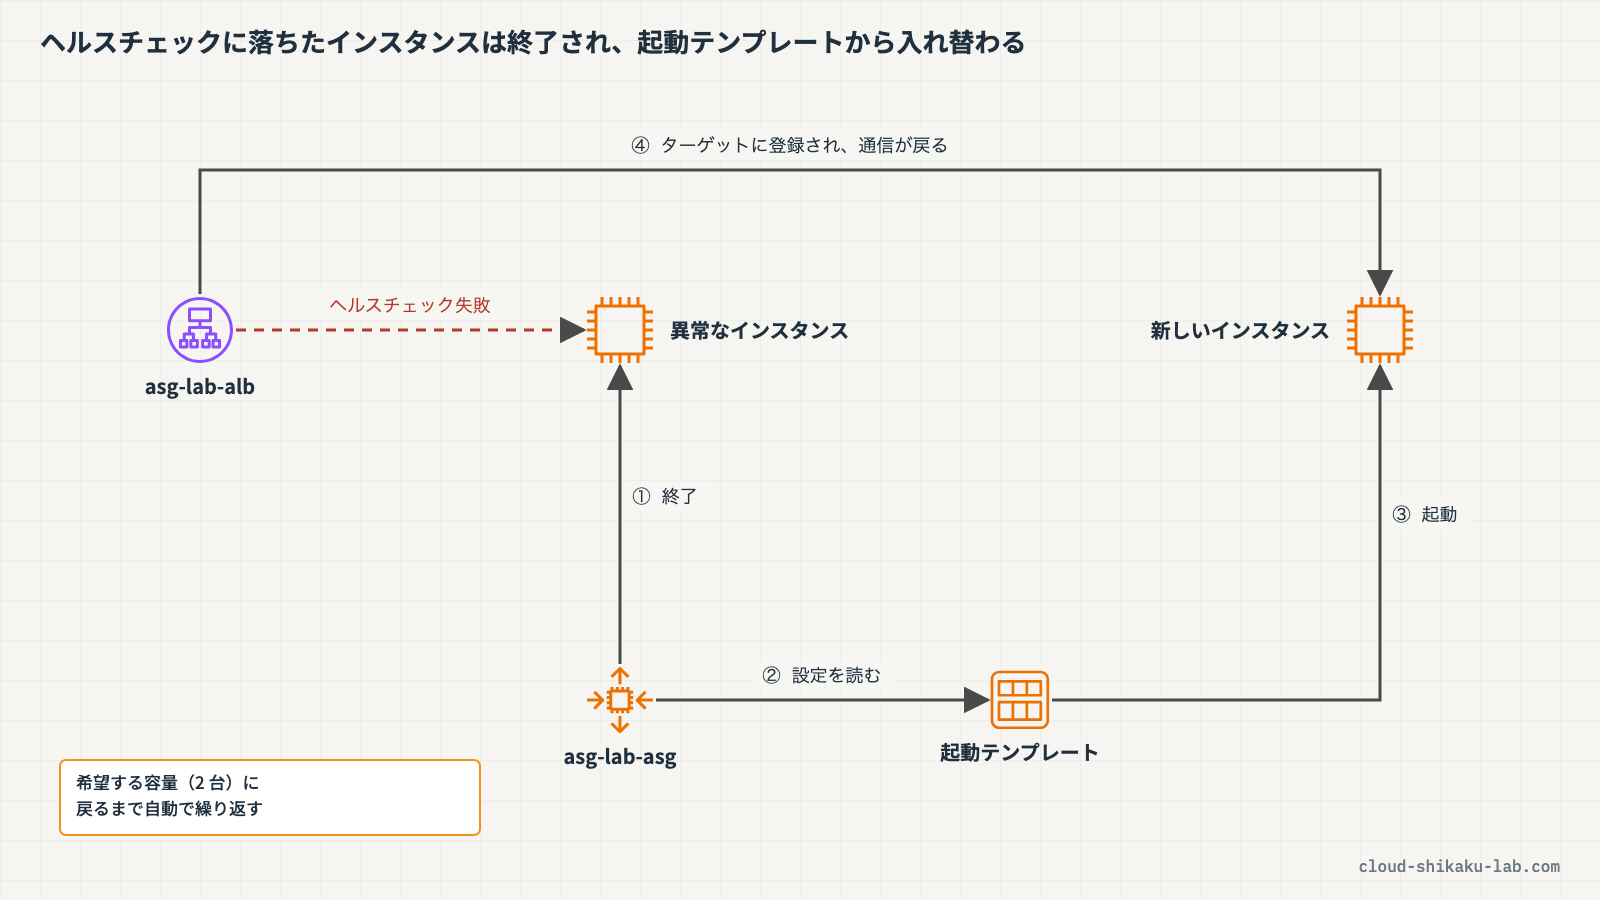
土肥デフォルトだと、EC2 Auto Scaling は EC2 ヘルスチェックで異常と判断したインスタンスしか置き換えないんだ。だから、インスタンスは動いているのに Web サーバーのプロセスが止まって応答しない、みたいな状態だと置き換えてくれない。ELB ヘルスチェックをオンにすると、ロードバランサーが「異常」と報告したインスタンスも置き換えの対象になるよ。
クラウドおさる見張り台に立ってはいるけれど居眠りしている猿も、交代させられるようになるのでござるな!
土肥ははは、そういうことだね。ただ、起動したばかりのインスタンスは、Web サーバーの準備ができるまでヘルスチェックに失敗することがあるよね。そこで「ヘルスチェックの猶予期間」があって、その間は異常でもすぐには終了させないんだ。コンソールで Auto Scaling グループを作ると、デフォルトは 300 秒だよ。
スケーリングポリシー
クラウドおさるいよいよ台数を増やしたり減らしたりする話でござるな。どんな方法があるのでござるか?
土肥よく使うのはこの 3 つだよ。
| 種類 | 動き方 | 向いている場面 |
|---|---|---|
| ターゲット追跡スケーリング | 「平均 CPU 使用率 50%」のように目標値を決めると、その値に近づくように台数を調整する。必要な CloudWatch アラームは EC2 Auto Scaling が作成・管理する | 多くのケースの第一候補。AWS も使用を強く推奨している |
| ステップスケーリング | 自分で作った CloudWatch アラームのしきい値の超え方に応じて、段階的に増やす台数を変える | 「少し超えたら少し、大きく超えたら大きく」増やしたいとき |
| スケジュールされたスケーリング | 決めた日時(1 回限り、または cron 式での繰り返し)に希望・最小・最大の容量を変える | 平日の朝に増やす、など負荷の変化が予測できるとき |
クラウドおさるターゲット追跡は、目標の温度を決めておけば勝手に調整してくれるエアコンのようなものでござるな。
土肥そうそう、AWS のドキュメントでもサーモスタットに例えられているよ。ほかに、1 つの調整値で増減する「シンプルスケーリング」もあるけど、まずはターゲット追跡から考えればいいかな。目標にするメトリクスには、Auto Scaling グループの平均 CPU 使用率や、ALB のターゲットあたりのリクエスト数みたいに、台数を増やすと値が下がるものを選ぶのがコツなんだ。
クラウドおさる予測できる混雑はスケジュール、予測できない混雑はターゲット追跡、と組み合わせるのもよさそうでござるな。収穫祭の日だけ見張りを増やすのは、前もって決めておけばよいのでござる。
AWS Auto Scaling との違い
クラウドおさるそういえば「AWS Auto Scaling」という名前も聞いたことがあるでござる。EC2 Auto Scaling と同じものでござるか?
土肥名前が似ているけど別物なんだ。AWS Auto Scaling は「スケーリングプラン」を作るサービスで、タグや CloudFormation スタックでまとめた複数のリソースのスケーリングを、まとめて設定できるんだよ。
| サービス | 対象 | 役割 |
|---|---|---|
| Amazon EC2 Auto Scaling | EC2 インスタンス(Auto Scaling グループ) | 台数の維持・インスタンスの置き換え・スケーリング |
| AWS Auto Scaling(スケーリングプラン) | EC2 Auto Scaling グループ、ECS サービス、DynamoDB テーブル、Aurora のレプリカ、スポットフリート | 複数サービスのスケーリングをまとめて構成する |
クラウドおさるEC2 Auto Scaling は見張り台の当番表、AWS Auto Scaling は猿山全体の人手配置の計画、という関係でござるな。
土肥いい整理だね! 注意点として、インスタンスの置き換え(自己修復)は EC2 Auto Scaling の Auto Scaling グループがやっていることなんだ。それから、スケーリングプランを予測スケーリングのためだけに使うなら、AWS は EC2 Auto Scaling に直接予測スケーリングポリシーを設定するほうを推奨しているよ。
実践

ここでは、Web サーバーを自動で入れる起動テンプレートを作り、2 つの AZ にまたがる Auto Scaling グループを ALB と一緒に作成します。インスタンスを 1 台手動で終了して自動で置き換わることを確認し、最後にターゲット追跡スケーリングポリシーを設定します。
前提条件
- リージョン:
ap-northeast-1(東京) - AWS マネジメントコンソールにログイン済み
- 以下のリソースが作成済みであること
| リソース種別 | リソース名 | 用途 |
|---|---|---|
| VPC | asg-lab-vpc | 検証用 VPC(CIDR: 10.0.0.0/16) |
| パブリックサブネット | asg-lab-public-subnet-1a | ap-northeast-1a のパブリックサブネット(CIDR: 10.0.1.0/24、パブリック IPv4 アドレスの自動割り当て有効) |
| パブリックサブネット | asg-lab-public-subnet-1c | ap-northeast-1c のパブリックサブネット(CIDR: 10.0.2.0/24、パブリック IPv4 アドレスの自動割り当て有効) |
| インターネットゲートウェイ | asg-lab-igw | インターネット接続用 |
| ルートテーブル | asg-lab-public-rt | 0.0.0.0/0 をインターネットゲートウェイへ向けるルート。2 つのパブリックサブネットに関連付け済み |
| セキュリティグループ | asg-lab-alb-sg | ALB 用。インバウンドで HTTP(80)を 0.0.0.0/0 から許可 |
| セキュリティグループ | asg-lab-web-sg | Web サーバー用。インバウンドで HTTP(80)を asg-lab-alb-sg からのみ許可 |
作成するリソース一覧
| リソース種別 | リソース名 | 用途 |
|---|---|---|
| 起動テンプレート | asg-lab-web-template | Web サーバーを入れた EC2 インスタンスの設定 |
| Auto Scaling グループ | asg-lab-asg | Web サーバー群(最小 2 / 希望 2 / 最大 4) |
| Application Load Balancer | asg-lab-alb | Web サーバー群の入口 |
| ターゲットグループ | asg-lab-tg | ALB の転送先(Auto Scaling グループのインスタンスが自動で登録される) |
| スケーリングポリシー | asg-lab-cpu50 | 平均 CPU 使用率 50% を目標にするターゲット追跡ポリシー |
起動テンプレートを作成する
AWS マネジメントコンソールにログインし、リージョンが ap-northeast-1(東京)であることを確認します。
- 上部の検索バーに
EC2と入力し、表示された「EC2」を選択します - 左側ナビゲーションの「インスタンス」→「起動テンプレート」を選択します
- 「起動テンプレートを作成」をクリックします
- 「起動テンプレート名と説明」で以下を入力します
- 起動テンプレート名:
asg-lab-web-template - テンプレートバージョンの説明:
httpd web server - Auto Scaling のガイダンス: チェックを入れる
- 「アプリケーションおよび OS イメージ (Amazon マシンイメージ)」で「クイックスタート」の「Amazon Linux」を選び、
Amazon Linux 2023の AMI を選択します - 「インスタンスタイプ」で
t3.microを選択します - 「キーペア (ログイン)」は「起動テンプレートに含めない」のままにします(このハンズオンではインスタンスにログインしません)
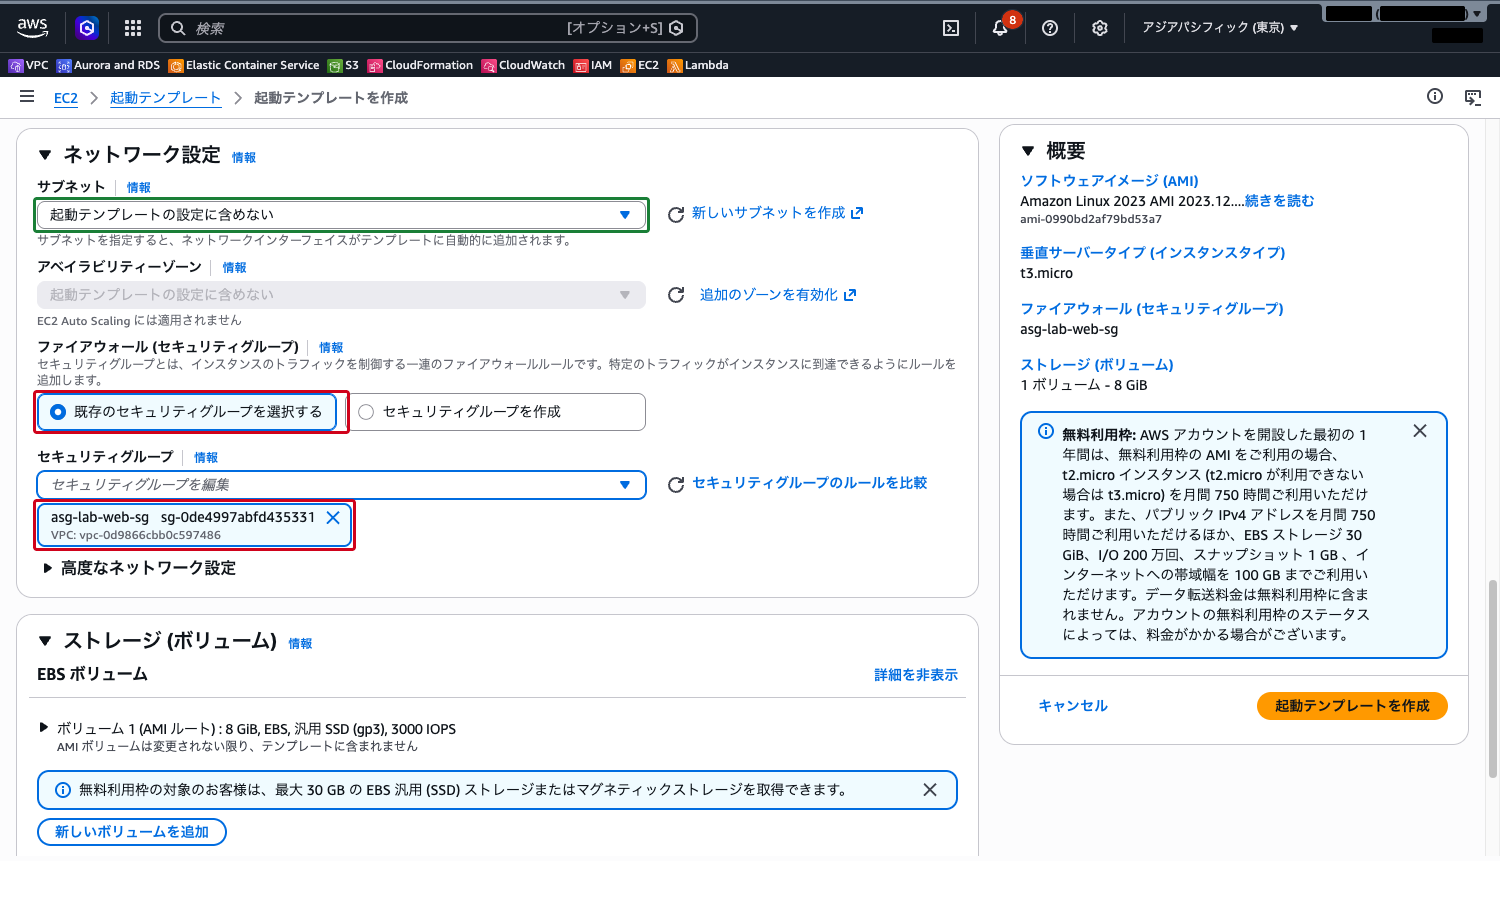
- 「ネットワーク設定」で以下を設定します
- サブネット: 「起動テンプレートに含めない」のまま
- ファイアウォール (セキュリティグループ): 「既存のセキュリティグループを選択する」を選び、
asg-lab-web-sgを選択
- 「高度な詳細」を展開し、一番下の「ユーザーデータ」に以下を貼り付けます。起動時に Apache(httpd)を入れ、インスタンス ID と AZ を表示するページを作るスクリプトです
#!/bin/bash
dnf install -y httpd
TOKEN=$(curl -s -X PUT "http://169.254.169.254/latest/api/token" -H "X-aws-ec2-metadata-token-ttl-seconds: 21600")
INSTANCE_ID=$(curl -s -H "X-aws-ec2-metadata-token: $TOKEN" http://169.254.169.254/latest/meta-data/instance-id)
AZ=$(curl -s -H "X-aws-ec2-metadata-token: $TOKEN" http://169.254.169.254/latest/meta-data/placement/availability-zone)
echo "<h1>Hello from ${INSTANCE_ID}</h1><p>AZ: ${AZ}</p>" > /var/www/html/index.html
systemctl enable --now httpd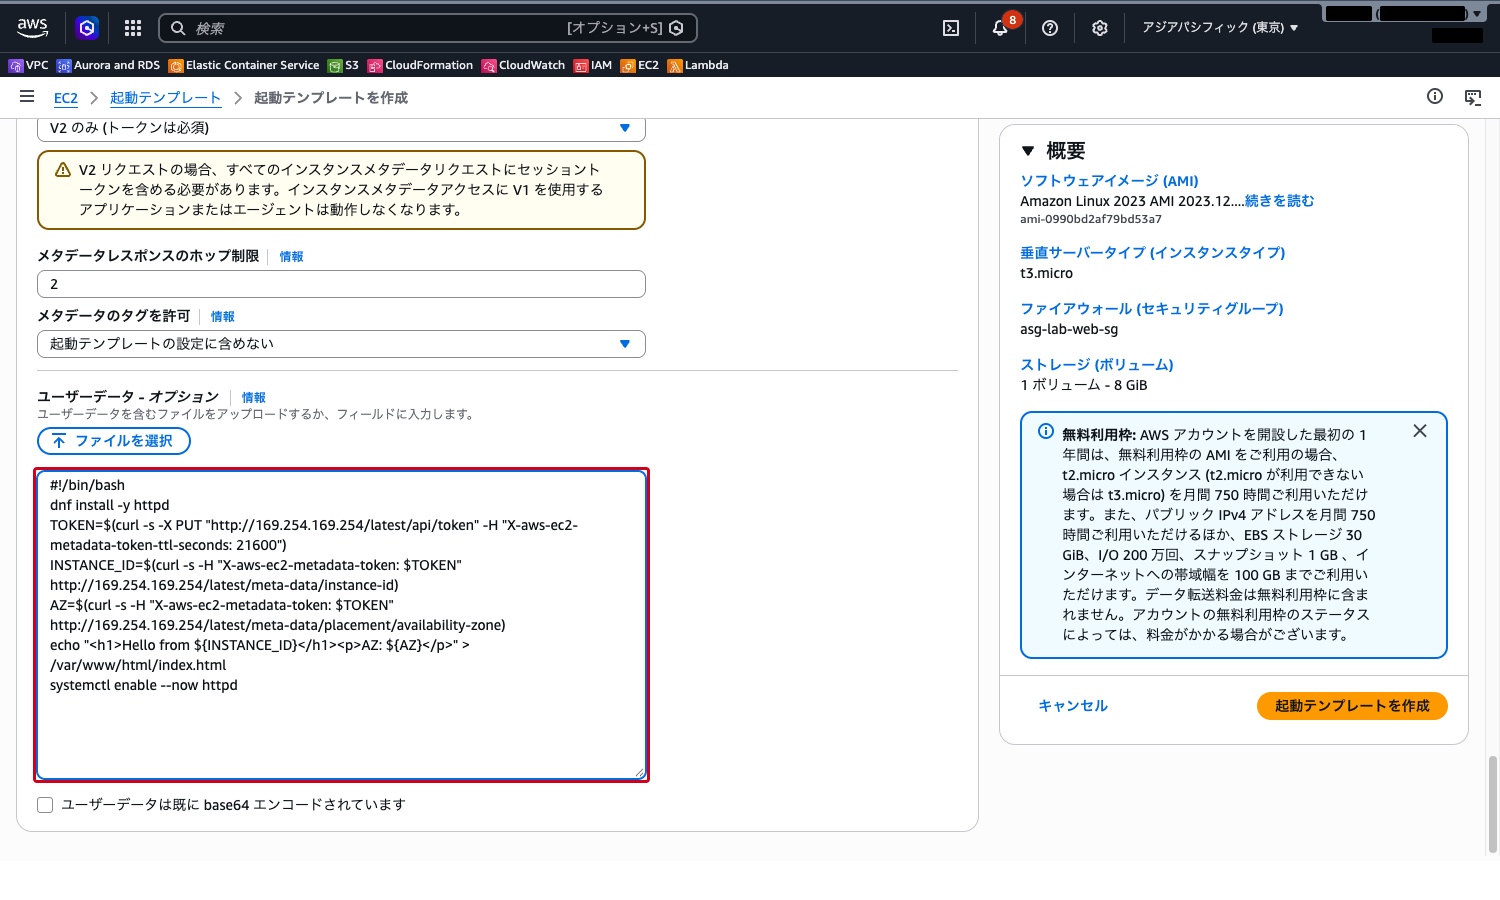
- その他の項目はデフォルトのままにし、右側の「起動テンプレートを作成」をクリックします
Auto Scaling グループを作成する(ALB も同時に作成)
Auto Scaling グループの作成ウィザードの中で、ALB とターゲットグループもあわせて作成します。
- 左側ナビゲーションの「Auto Scaling」→「Auto Scaling グループ」を選択します
- 「Auto Scaling グループを作成する」をクリックします
- 「ステップ 1: 起動テンプレートまたは起動設定を選択する」で以下を設定し、「次へ」をクリックします
- Auto Scaling グループ名:
asg-lab-asg - 起動テンプレート:
asg-lab-web-template - バージョン:
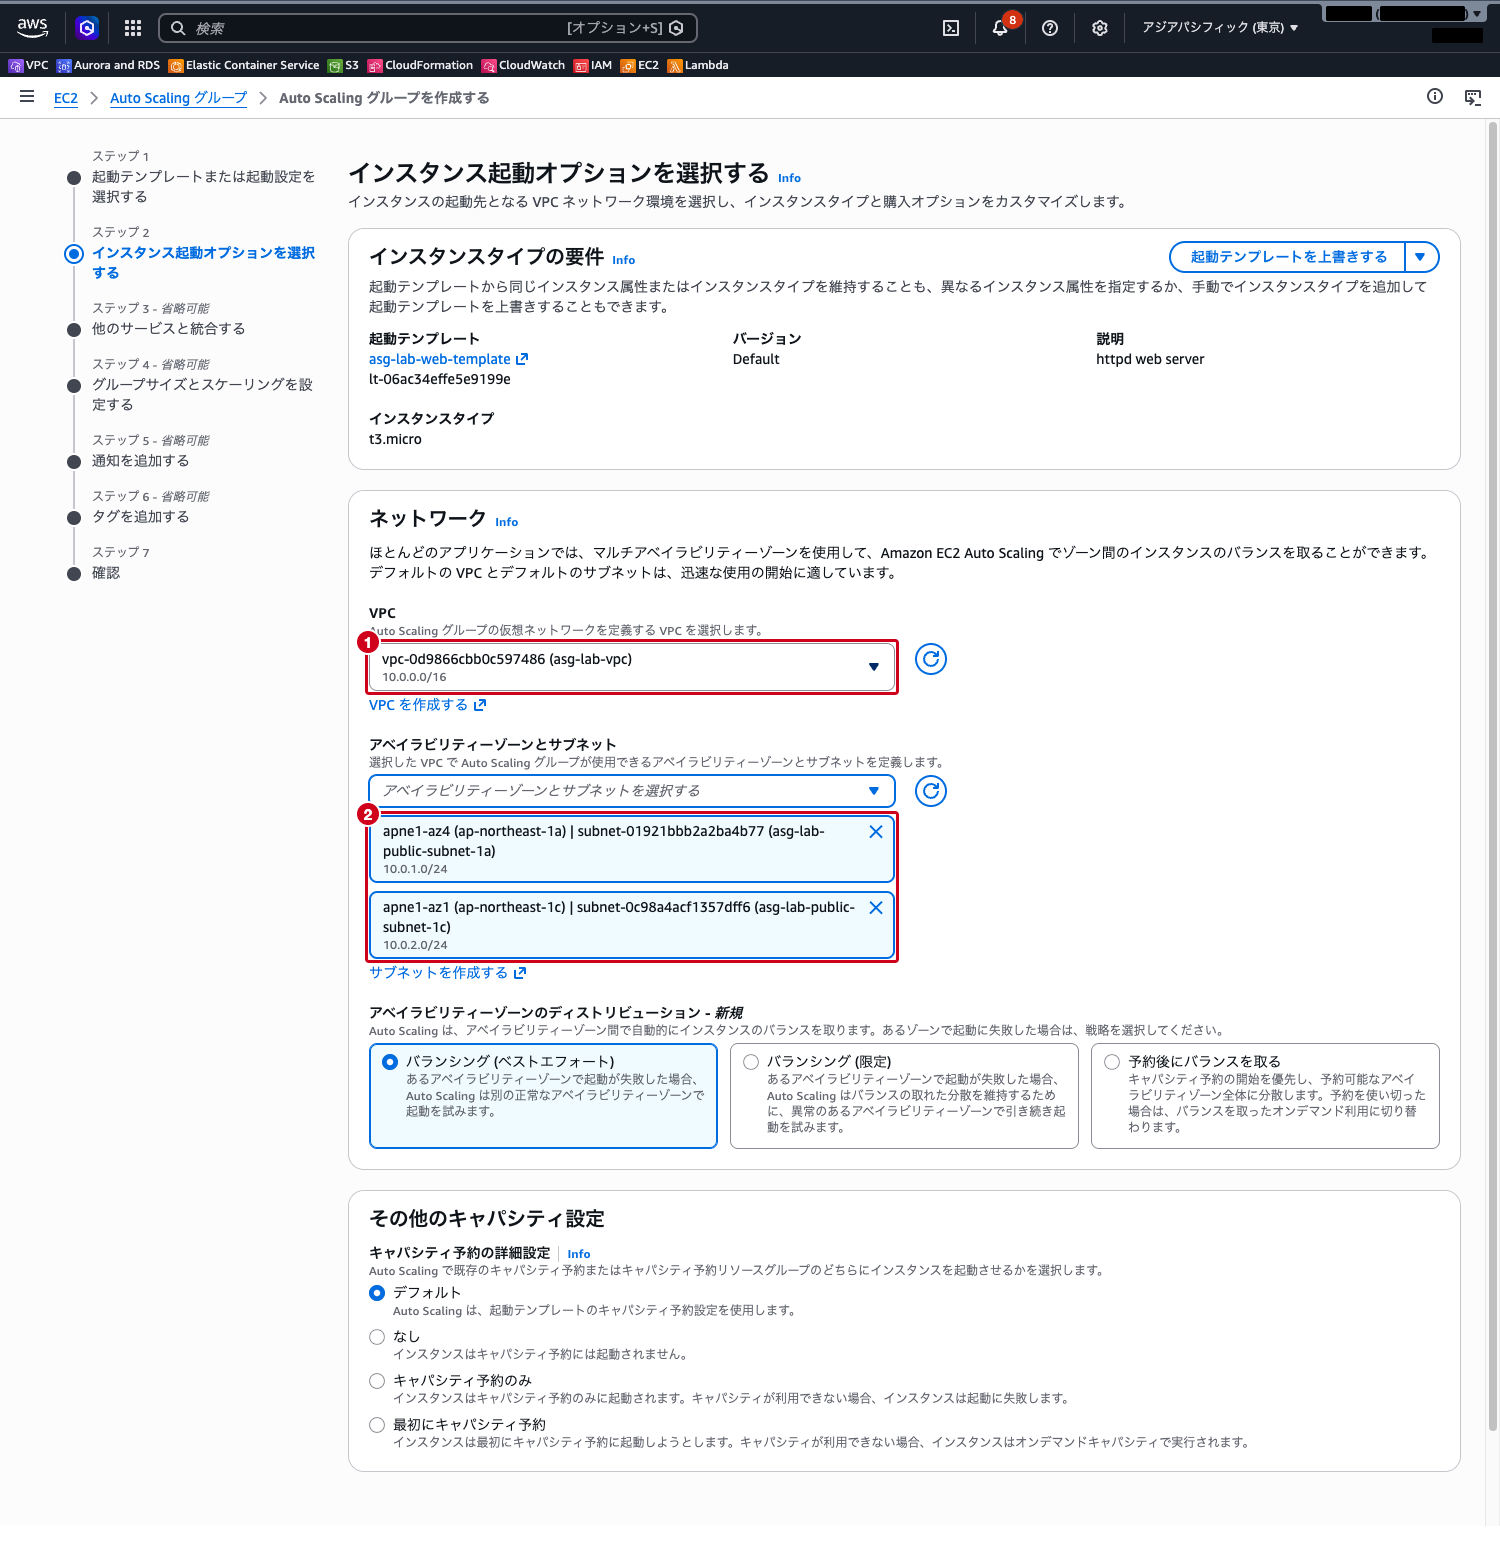
Default (1) - 「ステップ 2: インスタンス起動オプションを選択する」の「ネットワーク」で以下を設定します
- VPC:
asg-lab-vpc - アベイラビリティーゾーンとサブネット:
asg-lab-public-subnet-1aとasg-lab-public-subnet-1cの 2 つを選択 - アベイラビリティーゾーンのディストリビューション:
バランシング (ベストエフォート)(デフォルト) - 「インスタンスタイプの要件」は起動テンプレートの設定のまま(上書きしない)にし、「次へ」をクリックします
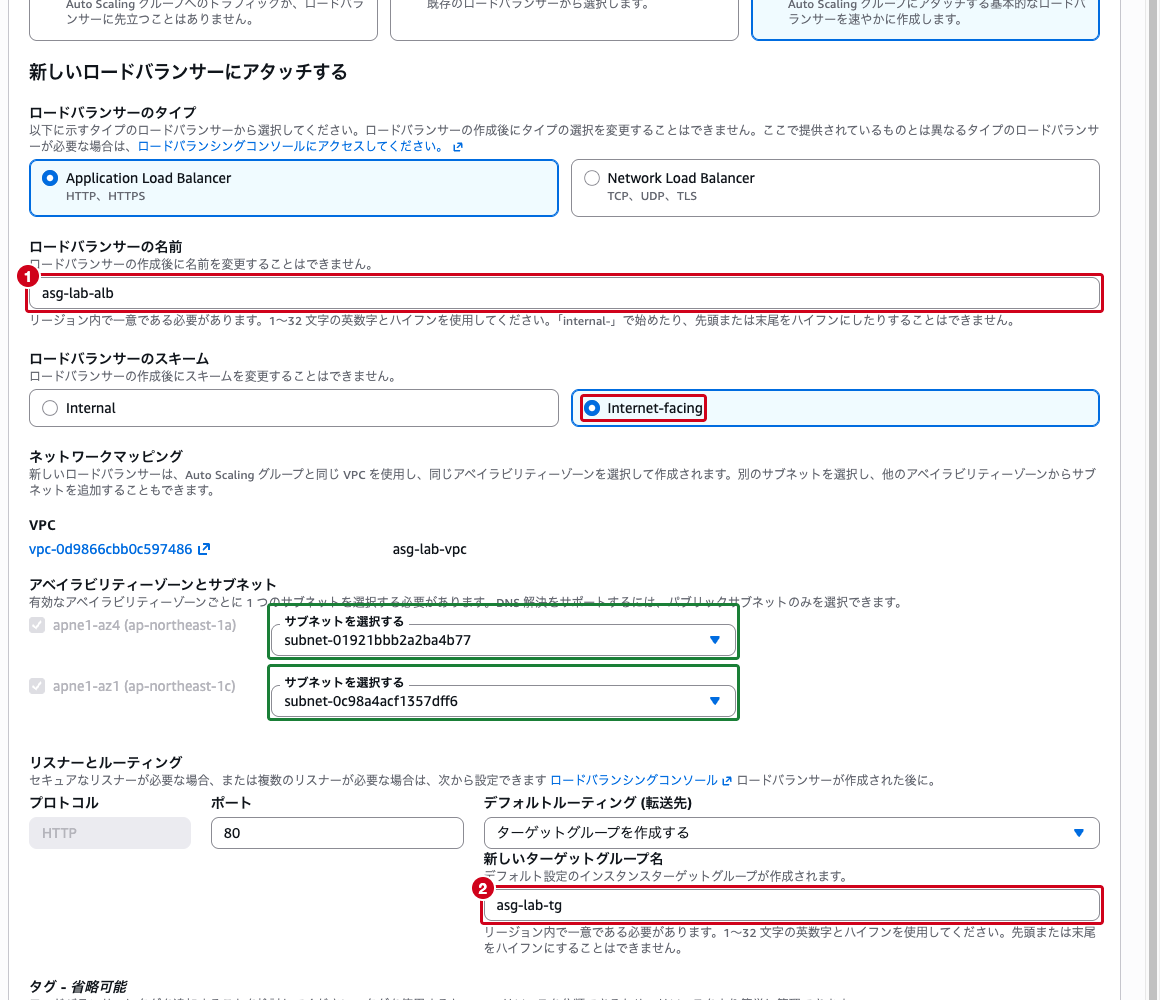
- 「ステップ 3: 他のサービスと統合する」の「ロードバランシング」で「新しいロードバランサーにアタッチする」を選択し、以下を設定します
- ロードバランサーのタイプ:
Application Load Balancer - ロードバランサーの名前:
asg-lab-alb - ロードバランサーのスキーム:
Internet-facing(既定はInternalなので、Internet-facingに切り替えます) - アベイラビリティーゾーンとサブネット:
ap-northeast-1a(asg-lab-public-subnet-1a)とap-northeast-1c(asg-lab-public-subnet-1c)が選ばれていることを確認 - リスナーとルーティング: プロトコル
HTTP、ポート80、デフォルトルーティングで「ターゲットグループを作成する」を選択 - 新しいターゲットグループ名:
asg-lab-tg
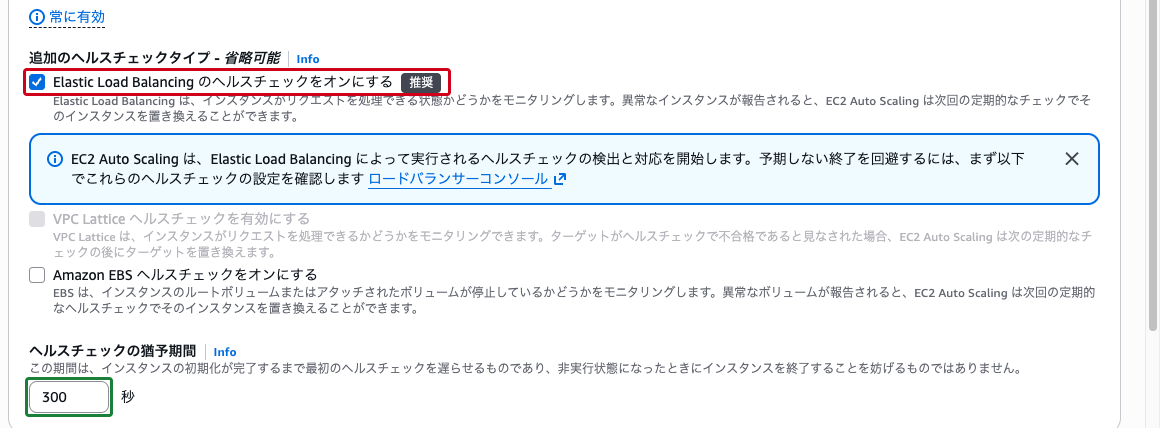
- 同じ画面の「ヘルスチェック」で以下を設定します
- 追加のヘルスチェックタイプ: 「Elastic Load Balancing のヘルスチェックをオンにする」にチェック
- ヘルスチェックの猶予期間:
300秒(デフォルト) - その他の項目はデフォルトのままにし、「次へ」をクリックします
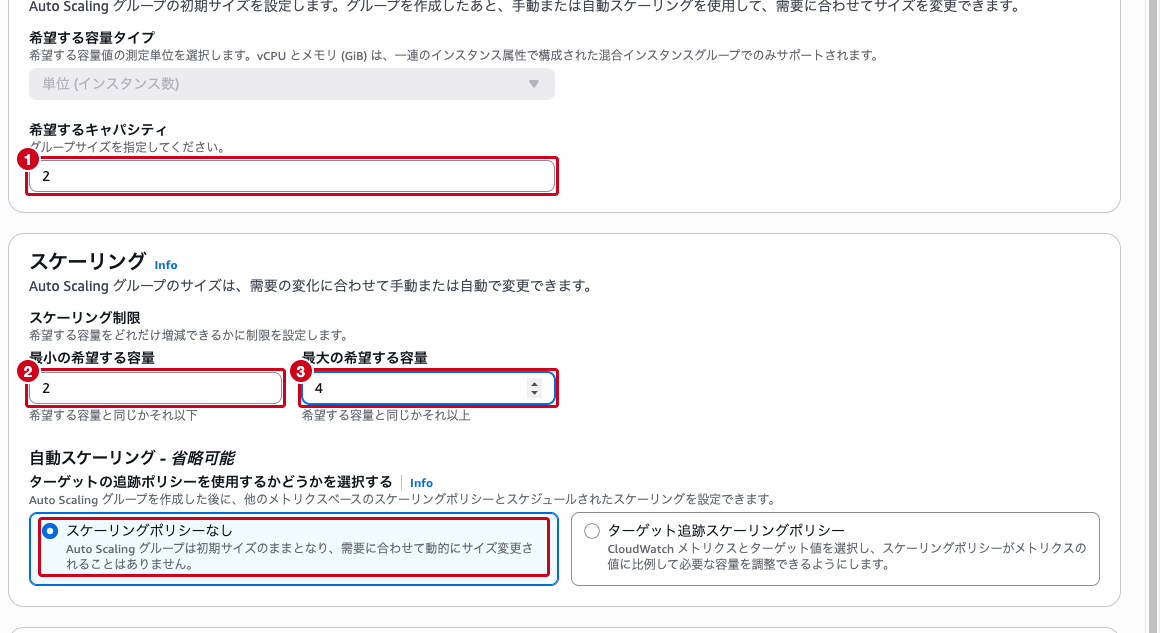
- 「ステップ 4: グループサイズとスケーリングを設定する」で以下を設定します
- 希望するキャパシティ:
2 - 最小の希望する容量:
2 - 最大の希望する容量:
4 - 自動スケーリング: 「スケーリングポリシーなし」(ポリシーは後で追加します)
- その他の項目はデフォルトのままにし、「次へ」をクリックします
- 「ステップ 5: 通知を追加する」は何も設定せず「次へ」をクリックします
- 「ステップ 6: タグを追加する」で「タグを追加する」をクリックし、キー
Name、値asg-lab-webを入力します。「新しいインスタンスにタグ付けする」にチェックが入っていることを確認し、「次へ」をクリックします - 「ステップ 7: 確認」で内容を確認し、「Auto Scaling グループを作成する」をクリックします
- 作成直後に「1 個の新しいターゲットグループを ASG にアタッチできません」というエラーが表示された場合は、ALB の作成がまだ終わっていないことがあります。ロードバランサー一覧で
asg-lab-albの状態が「アクティブ」になってから、asg-lab-asgの「統合」タブ →「ロードバランシング」の「編集」で「ターゲットグループ」にチェックを入れ、asg-lab-tgを選んで「更新」をクリックします
クラウドおさるここから ALB は、置いてある間ずっと時間単位で料金がかかるでござる。EC2 インスタンスも希望する容量の台数ぶん動き続けるので、希望する容量や最大容量を大きな数にしないよう気をつけるでござるぞ。
ALB のセキュリティグループを付け替える
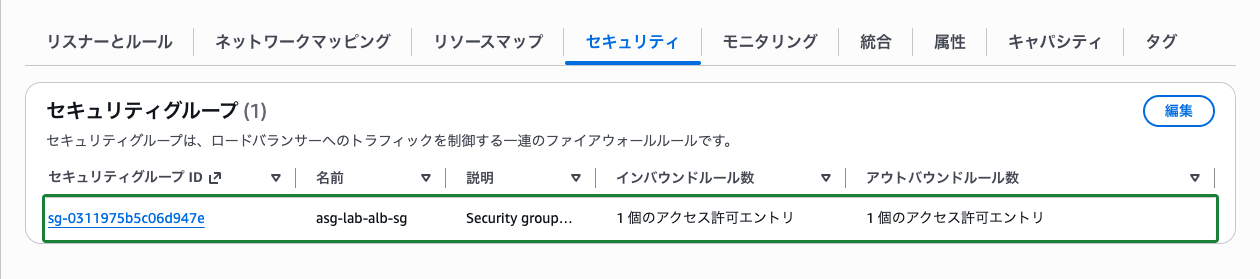
ウィザードにはロードバランサーのセキュリティグループを選ぶ項目がなく、ウィザードで作成した ALB には起動テンプレートに指定した asg-lab-web-sg が付きます。asg-lab-web-sg は asg-lab-alb-sg からの HTTP しか許可していないため、ALB に asg-lab-alb-sg を付けないとブラウザからも ALB のヘルスチェックからも Web サーバーに届きません。ヘルスチェックの猶予期間(300 秒)が過ぎる前に付け替えます。
- 左側ナビゲーションの「ロードバランシング」→「ロードバランサー」を選択し、
asg-lab-albを選択します - 下部の「セキュリティ」タブを選択し、「編集」をクリックします
asg-lab-alb-sgを追加で選択してから、付いていたasg-lab-web-sgを「×」で外し、asg-lab-alb-sgだけが残った状態にします- 「変更内容の保存」をクリックします
ALB の DNS 名でアクセスする
asg-lab-albの詳細画面で、状態が「アクティブ」になっていることを確認し、「DNS 名」をコピーします- 左側ナビゲーションの「ロードバランシング」→「ターゲットグループ」を選択し、
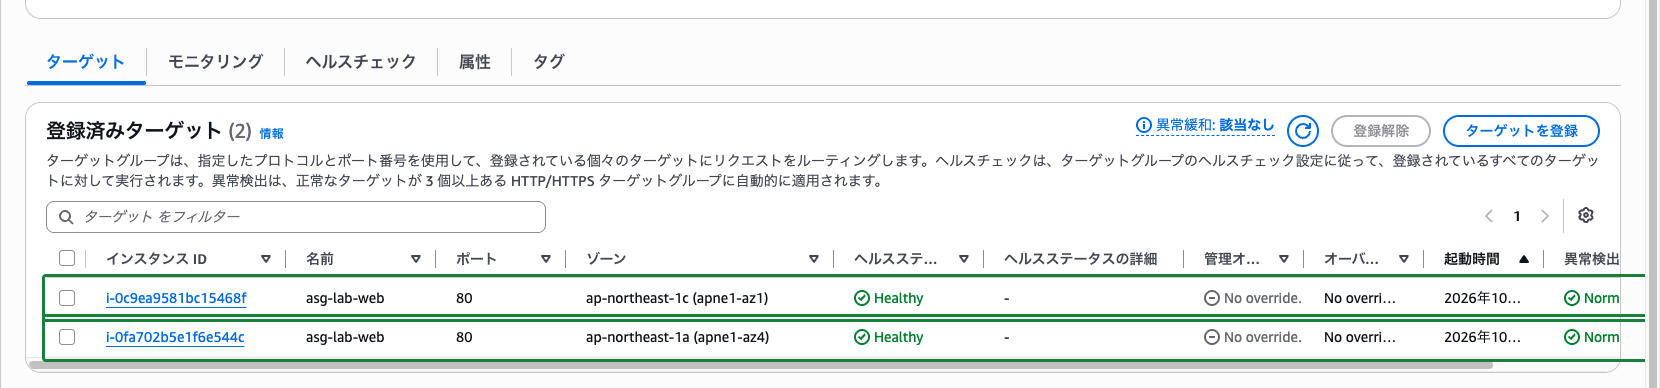
asg-lab-tgを選択します - 下部の「ターゲット」タブで、2 台のインスタンス(
ap-northeast-1aとap-northeast-1cに 1 台ずつ)のヘルスステータスがHealthyになるまで待ちます
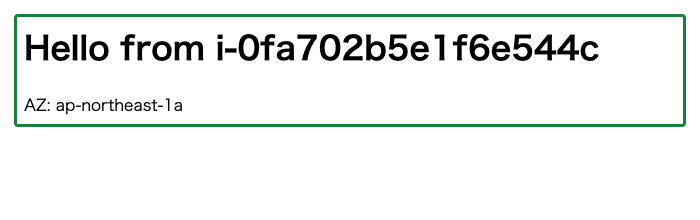
ブラウザで ALB の DNS 名にアクセスします。
http://<ALB の DNS 名>Hello from i-xxxxxxxx とインスタンス ID、AZ が表示されることを確認します。何度か再読み込みすると、2 台のインスタンスの ID と AZ が入れ替わって表示されます。
インスタンスを 1 台終了して自動で置き換わることを確認する
インスタンスが落ちた状況を作るため、Auto Scaling グループのインスタンスを 1 台手動で終了します。
- 左側ナビゲーションの「インスタンス」→「インスタンス」を選択します
- 名前が
asg-lab-webのインスタンスのうち 1 台を選択し、インスタンス ID を控えます - 「インスタンスの状態」→「インスタンスを終了 (削除)」をクリックし、確認画面で「終了 (削除)」をクリックします
- 左側ナビゲーションの「Auto Scaling」→「Auto Scaling グループ」を選択し、
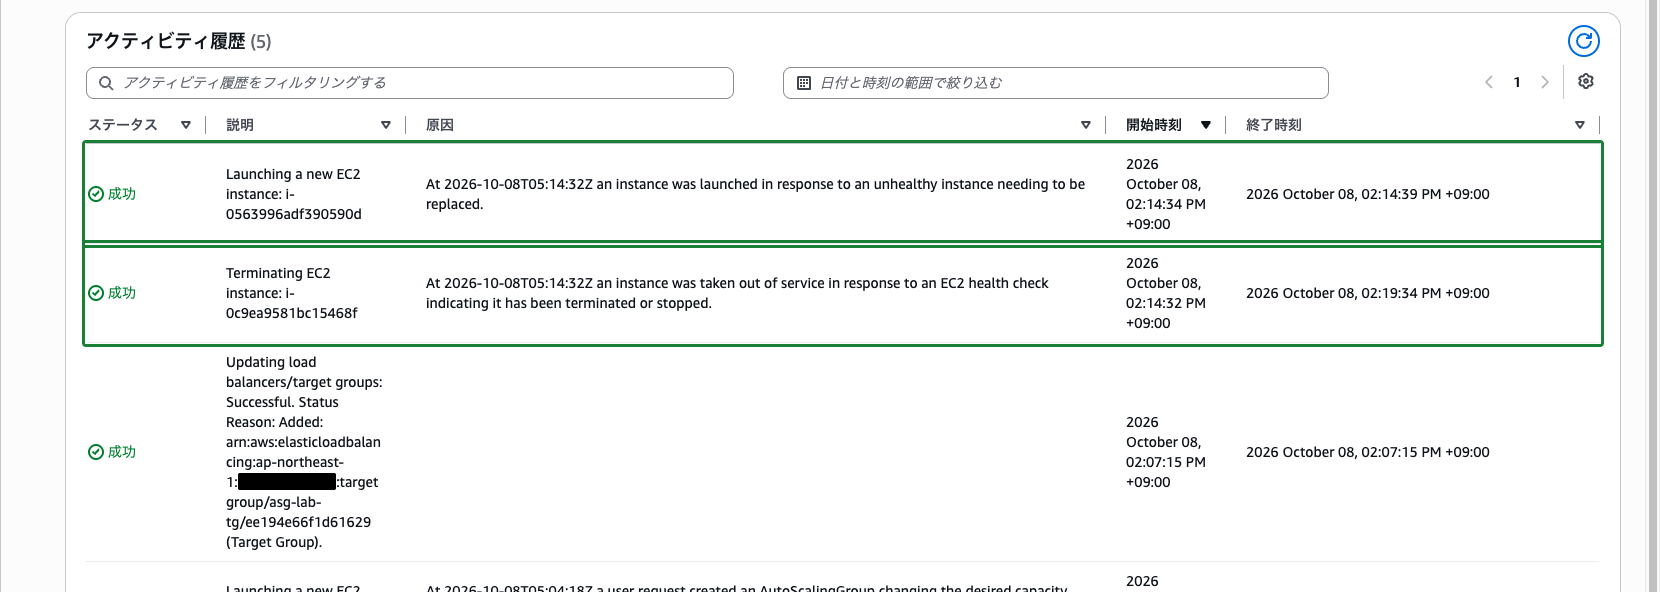
asg-lab-asgを選択します - 「アクティビティ」タブを選択します。インスタンスの終了が検知されて置き換えが始まるまで、2 分ほどかかることがあります。表示されない場合は少し待ってから更新します
「アクティビティ履歴」に、控えたインスタンスの終了と、新しいインスタンスの起動(Launching a new EC2 instance)が記録されることが確認できます。希望する容量 2 に対して実際の台数が 1 になったため、EC2 Auto Scaling が新しいインスタンスを起動して 2 台に戻しています。
- 「インスタンス管理」タブを選択し、新しいインスタンスが追加され、ライフサイクルが
InServiceになるまで待ちます - ターゲットグループ
asg-lab-tgの「ターゲット」タブで、新しいインスタンスがHealthyになったことを確認します - ブラウザで ALB の DNS 名に再度アクセスし、何度か再読み込みすると、新しいインスタンスの ID が表示されることが確認できます
クラウドおさる1 台を倒しても、人が何もしないうちに 2 台に戻ったでござる! 起動テンプレートという持ち物リストがあるから、控えの猿が同じ支度で見張り台に登れたのでござるな。
ターゲット追跡スケーリングポリシーを設定する
最後に、平均 CPU 使用率が 50% 前後になるように台数を調整するポリシーを追加します。
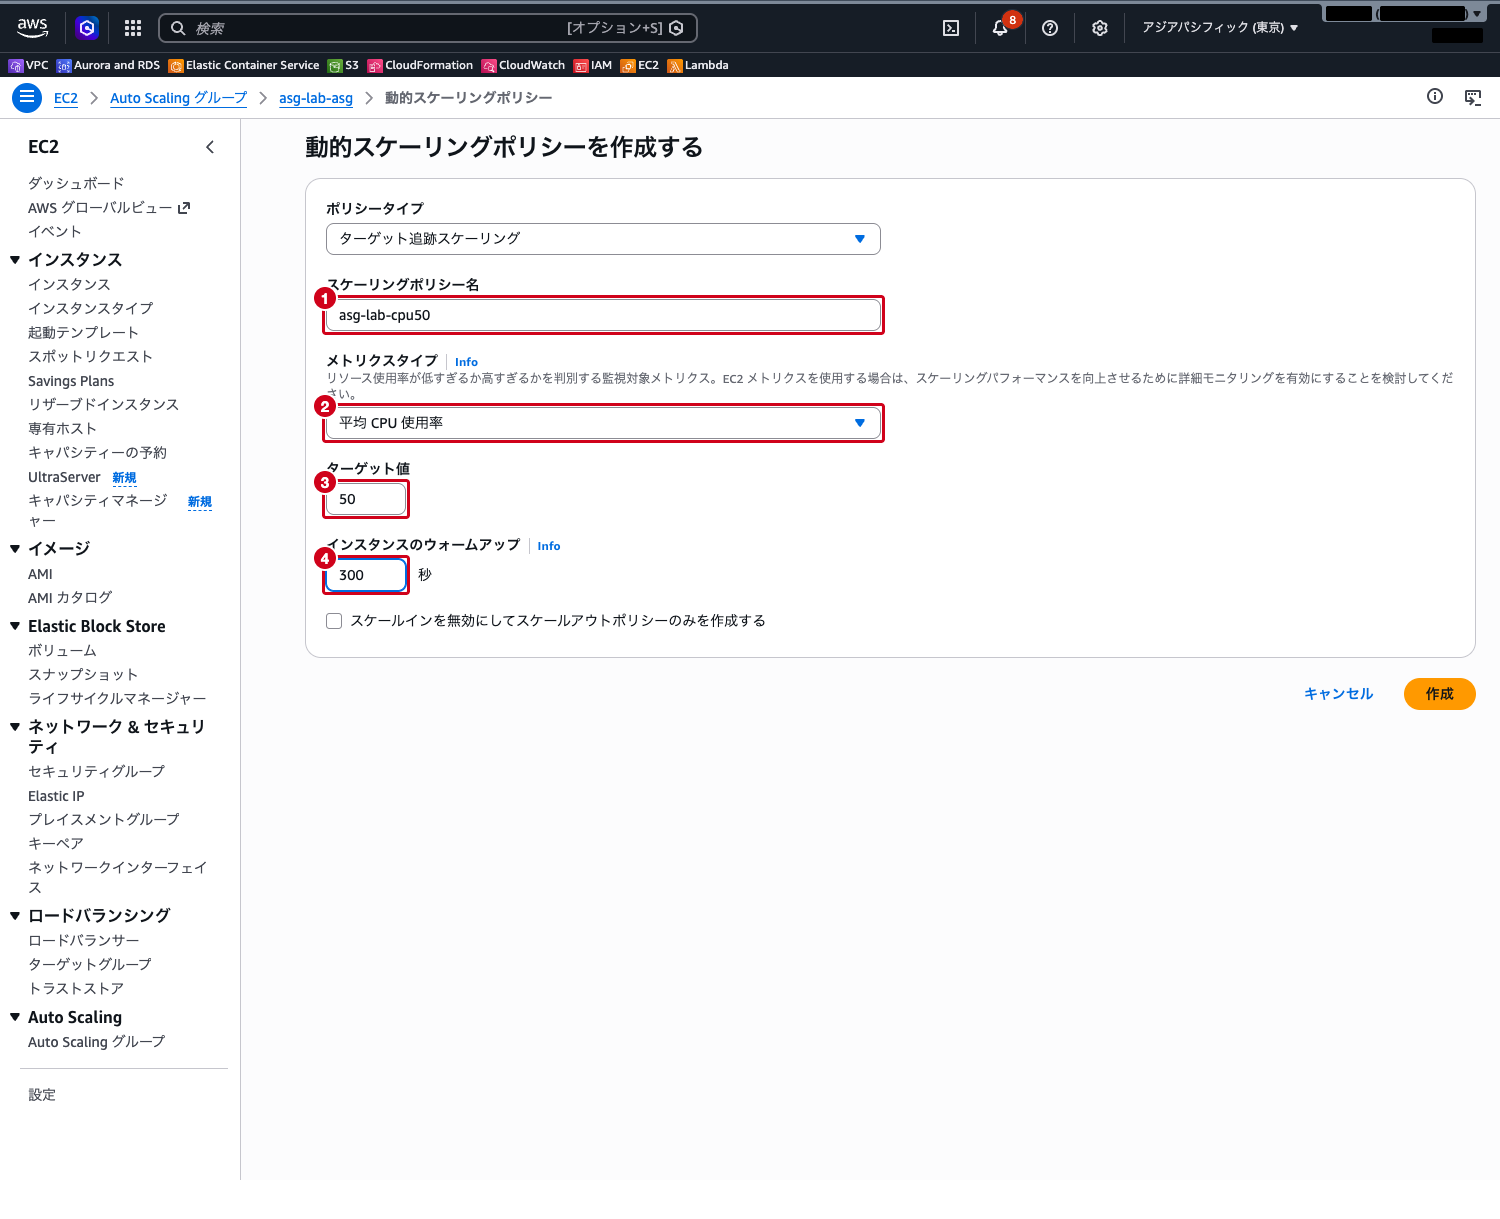
asg-lab-asgの詳細画面で「オートスケーリング」タブを選択します- 「動的スケーリングポリシー」の「動的スケーリングポリシーを作成する」をクリックします
- 以下を設定します
- ポリシータイプ:
ターゲット追跡スケーリング - スケーリングポリシー名:
asg-lab-cpu50 - メトリクスタイプ:
平均 CPU 使用率 - ターゲット値:
50 - インスタンスのウォームアップ:
300秒(入力欄は空欄なので300を入力します) - 「スケールインを無効にしてスケールアウトポリシーのみを作成する」: チェックを入れない
- 「作成」をクリックします
「動的スケーリングポリシー」に asg-lab-cpu50 が追加されたことを確認します。
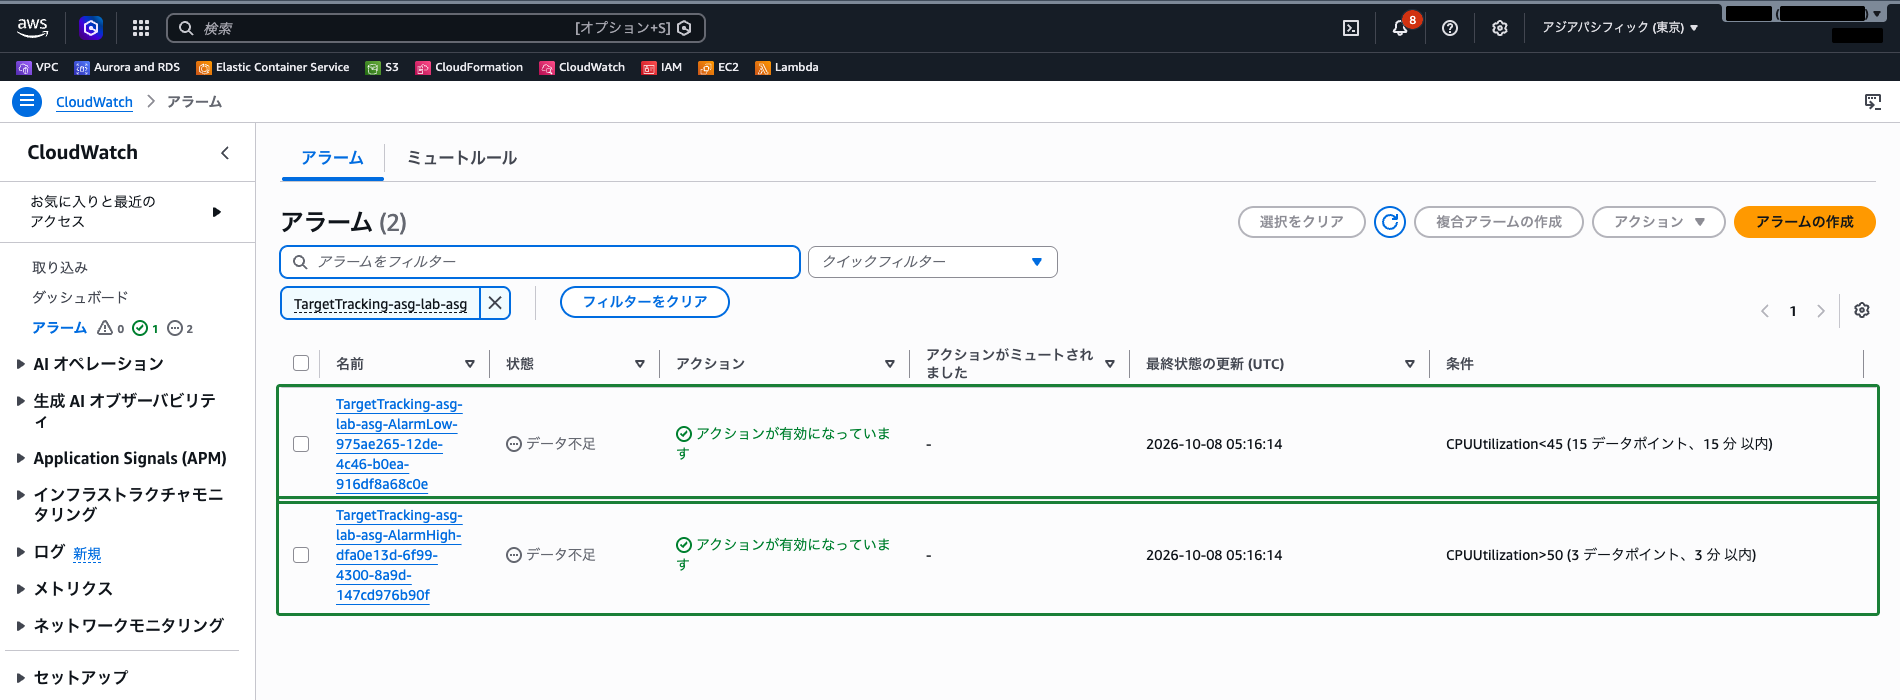
- 上部の検索バーに
CloudWatchと入力し、表示された「CloudWatch」を選択します - 左側ナビゲーションの「アラーム」→「すべてのアラーム」を選択します
TargetTracking-asg-lab-asg-AlarmHigh- と TargetTracking-asg-lab-asg-AlarmLow- で始まる 2 つのアラームが作られていることが確認できます。ターゲット追跡ポリシーでは、これらのアラームを EC2 Auto Scaling が作成・管理するため、自分で編集・削除しないようにします。いまは負荷がかかっていないため、CPU 使用率が上がって台数が増えることはなく、最小容量の 2 台のまま動き続けます。
まとめ
- Amazon EC2 Auto Scaling は、希望する台数の EC2 インスタンスを維持し、終了・異常になったインスタンスを自動で置き換える。サービス自体に追加料金はかからない
- 起動テンプレートには AMI・インスタンスタイプ・セキュリティグループ・ユーザーデータなどをまとめる。Auto Scaling グループで使う場合、サブネットはグループ側で指定する
- Auto Scaling グループは最小・希望・最大の 3 つの容量で台数を決める。スケーリングで動くのは希望する容量で、最小と最大がその上下限になる
- 複数の AZ のサブネットを指定すると、AZ 間でインスタンス数がそろうように起動される
- デフォルトでは EC2 ヘルスチェックだけで置き換えを判断する。ELB ヘルスチェックをオンにすると、アプリケーションが応答しないインスタンスも置き換えの対象になる
- スケーリングポリシーは、目標値に合わせるターゲット追跡、アラームの超え方で段階を変えるステップ、日時で容量を変えるスケジュールを使い分ける
- AWS Auto Scaling(スケーリングプラン)は、複数のサービスのスケーリングをまとめて構成するサービスで、EC2 Auto Scaling とは別物である
参照先
- Amazon EC2 Auto Scaling とは – Amazon EC2 Auto Scaling
- Auto Scaling 起動テンプレート – Amazon EC2 Auto Scaling
- Auto Scaling グループの起動テンプレートを作成する – Amazon EC2 Auto Scaling
- 起動テンプレートを使用して Auto Scaling グループを作成する – Amazon EC2 Auto Scaling
- Auto Scaling グループのアベイラビリティーゾーンの分散 – Amazon EC2 Auto Scaling
- コンソールから Application Load Balancer または Network Load Balancer を設定する – Amazon EC2 Auto Scaling
- チュートリアル: スケーリングとロードバランシングを使用するアプリケーションのセットアップ – Amazon EC2 Auto Scaling
- Auto Scaling グループでのインスタンスのヘルスチェック – Amazon EC2 Auto Scaling
- Auto Scaling グループに Elastic Load Balancing ロードバランサーをアタッチする – Amazon EC2 Auto Scaling
- Auto Scaling グループにヘルスチェックの猶予期間を設定する – Amazon EC2 Auto Scaling
- Amazon EC2 Auto Scaling の動的スケーリング – Amazon EC2 Auto Scaling
- Amazon EC2 Auto Scaling のターゲットトラッキングスケーリングポリシー – Amazon EC2 Auto Scaling
- ターゲット追跡スケーリングポリシーを作成する – Amazon EC2 Auto Scaling
- Amazon EC2 Auto Scaling のステップおよび簡易スケーリングポリシー – Amazon EC2 Auto Scaling
- Amazon EC2 Auto Scaling のスケジュールされたスケーリング – Amazon EC2 Auto Scaling
- Auto Scaling グループのスケーリングアクティビティを検証する – Amazon EC2 Auto Scaling
- スケーリングプランとは? – AWS Auto Scaling