概要
Web サイトのクリック、アプリケーションのログ、IoT 機器のセンサー値のように、途切れることなく次々に発生するデータを「ストリーミングデータ」と呼びます。こうしたデータは 1 件ずつは小さくても、量が多く、発生した直後に処理したり、まとめて保存して後から分析したりしたい場面がよくあります。
AWS でストリーミングデータを扱うサービス群が Amazon Kinesis です。データを取り込んで複数のアプリケーションから読み取れるようにする Amazon Kinesis Data Streams、取り込んだデータを S3 などの宛先へ自動で配信する Amazon Data Firehose(旧称 Amazon Kinesis Data Firehose)、動画を扱う Amazon Kinesis Video Streams、ストリームをリアルタイムに分析する Amazon Managed Service for Apache Flink があり、名前が似ているぶん役割の違いが分かりにくいサービスでもあります。
この記事では、ストリーミングデータの考え方と Kinesis の各サービスの役割、Kinesis Data Streams のシャード・保持期間・容量モード、Data Firehose のバッファリングと変換、そして Amazon SQS との違いを整理します。実践では、Data Firehose で S3 に配信するストリームを作成し、コンソールのデモデータと CloudShell からのデータ送信で、バッファ時間のあとに S3 にオブジェクトができることを確認します。
 クラウドおさる
猿山の見張り台からは、一日中「バナナが何本実ったでござる」という報告が流れてくるのでござる。流れ続ける報告をこぼさず倉庫に積み上げるにはどうするのか、Data Firehose で確かめるでござる!
この記事のメリット
- ストリーミングデータとは何か、バッチ処理との違いを理解できる
- Kinesis Data Streams・Data Firehose・Kinesis Video Streams・Managed Service for Apache Flink の役割を区別できる
- Kinesis Data Streams のシャード、保持期間、オンデマンド / プロビジョンドの容量モードの意味が分かる
- Data Firehose のバッファリング(バッファサイズとバッファ間隔)と、Lambda による変換・形式変換の位置づけが分かる
- Kinesis と Amazon SQS の使い分けを説明できる
- Data Firehose で S3 に配信するストリームを作成し、データが S3 に届くまでを実際に確認できる
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
クラウドおさるはじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
 クラウドおさる
基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
ストリーミングデータとは
クラウドおさるとひさん、「ストリーミングデータ」とはどういうデータでござるか? 動画配信のことでござる?
 土肥
動画も含まれるけど、もっと広い意味なんだ。ログ、Web サイトのクリックストリーム、ソーシャルメディアの投稿、マーケットデータのように、発生し続けるデータを途切れなく受け取るものをストリーミングデータって言うよ。1 日分をまとめてから処理する「バッチ処理」と違って、届いたそばから取り込んで処理していくのが特徴だね。
 クラウドおさる
まとめてから処理するのでは、何がいけないのでござる?
土肥いけないわけじゃないよ。ただ、ログをサーバーに溜めておいて夜にまとめて送る作りだと、その前にサーバーが壊れたらログが消えちゃうよね。発生したらすぐストリームに送っておけば、取りこぼしを防げるし、数秒後には集計やアラートに使える。Kinesis Data Streams では、レコードがストリームに入ってから取り出せるようになるまでの遅延は通常 1 秒未満なんだ。
クラウドおさるなるほど、見張り台の報告を夕方にまとめて長老会に届けるのではなく、聞こえたそばから伝言リレーで流すのでござるな! 途中で見張りが居眠りしても、もう伝わっているのでござる。
土肥そのイメージで大丈夫! AWS では、そうしたストリーミングデータを扱うサービスを Kinesis という名前でまとめているんだ。
Kinesis のサービスファミリー
クラウドおさるKinesis と付くサービスがいくつもあって、どれを使えばよいのか迷うでござる……。
土肥最初はみんな迷うところだね。まずは名前と役割を並べてみよう。
| サービス | 役割 | ひとことで言うと |
|---|---|---|
| Amazon Kinesis Data Streams | 大量のデータレコードをリアルタイムに取り込み、複数のアプリケーションから読み取れるようにする | データを流して、自分のアプリで読む「流れる川」 |
| Amazon Data Firehose | ストリーミングデータを S3・Amazon Redshift・Amazon OpenSearch Service などの宛先へ自動で配信する。配信前に変換もできる | 宛先まで運んでくれる「配送サービス」 |
| Amazon Kinesis Video Streams | カメラなどからのライブ動画を AWS にストリーミングし、保存・再生・分析に使う | 動画専用のストリーム |
| Amazon Managed Service for Apache Flink | Apache Flink を使って、Java・Scala・Python・SQL でストリーミングデータを処理・分析する | 流れているデータをその場で計算する |
クラウドおさるData Firehose だけ「Kinesis」が付いていないでござるな?
土肥よく見てるね! 以前は Amazon Kinesis Data Firehose という名前だったけど、今は Amazon Data Firehose に名前が変わっているんだ。Kinesis Data Streams のドキュメントでも、Firehose、Kinesis Video Streams、Managed Service for Apache Flink とあわせて Kinesis のストリーミングデータプラットフォームを構成する、と説明されているよ。試験や古い資料で旧名が出てきても同じサービスだと覚えておこう。
クラウドおさる動画なら Video Streams、その場で計算するなら Flink。残る Data Streams と Firehose の違いをしっかり押さえるのでござるな。
Kinesis Data Streams のシャードと保持期間
クラウドおさるでは Data Streams から教えてほしいでござる。データはどのように流れるのでござるか?
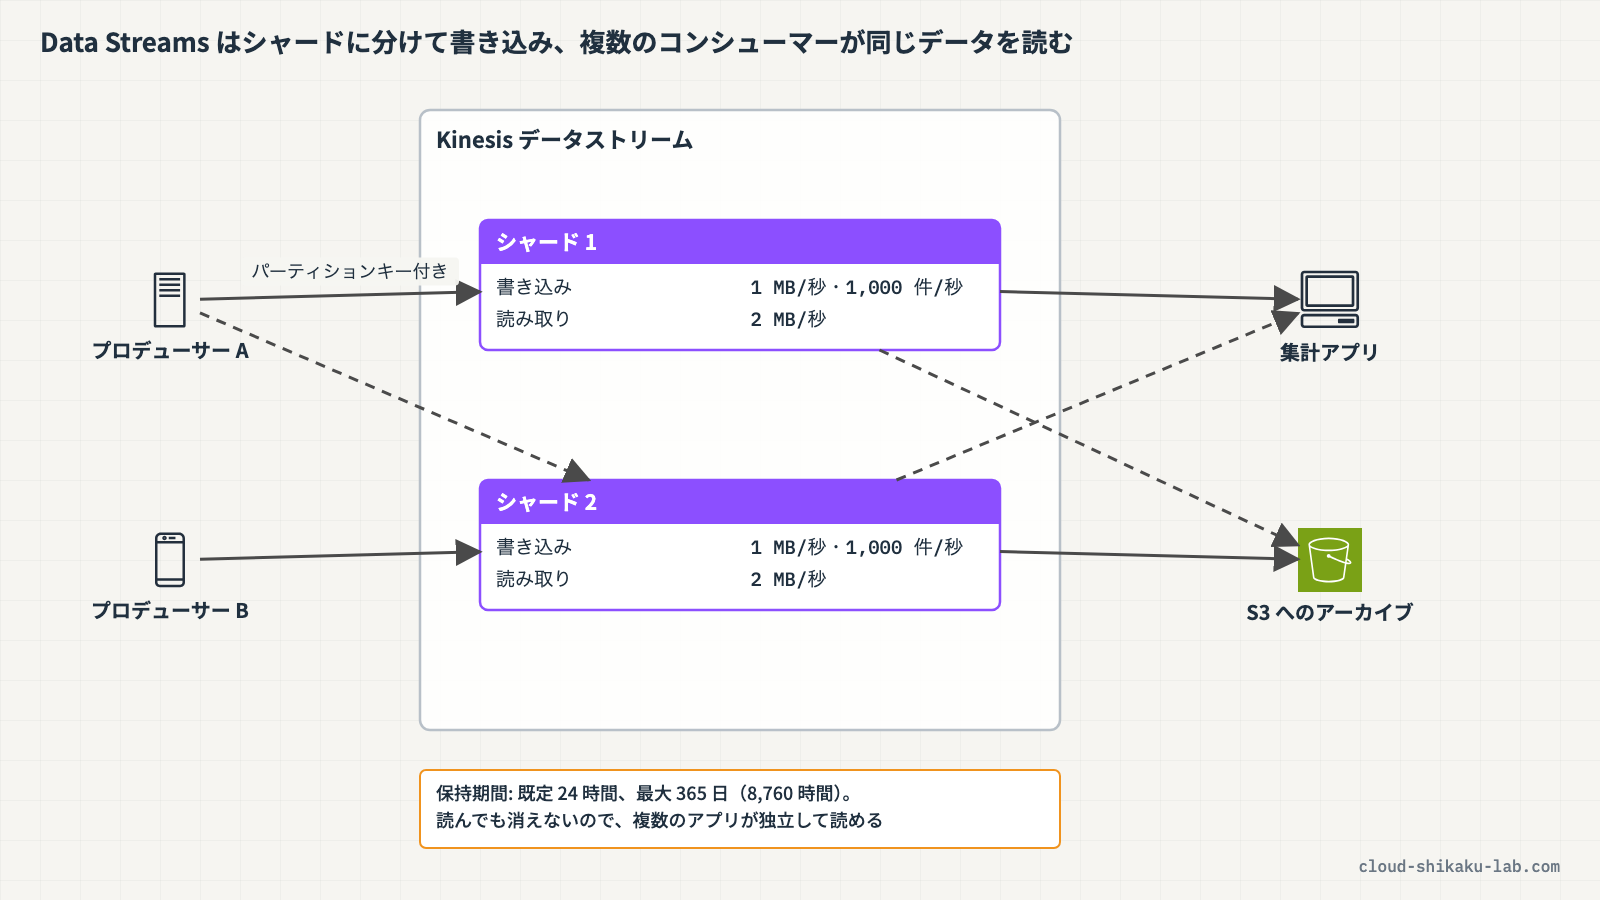
土肥データを書き込む側を「プロデューサー」、読み取る側を「コンシューマー」って呼ぶよ。プロデューサーはストリームにデータレコードを書き込み、コンシューマーはストリームからレコードを読み取って処理するんだ。ストリームの中は「シャード」という単位に分かれていて、1 シャードあたりの容量が決まっているよ。
| 項目 | 1 シャードあたりの容量 |
|---|---|
| 書き込み | 最大 1,000 レコード/秒、最大 1 MB/秒 |
| 読み取り | 最大 5 トランザクション/秒、最大 2 MB/秒 |
クラウドおさるレコードはどのシャードに入るのでござる?
土肥レコードを書き込むときに「パーティションキー」を指定するんだ。Kinesis Data Streams はパーティションキーをハッシュして、どのシャードに入れるかを決めるよ。同じパーティションキーのレコードは同じシャードに入って、シャード内では「シーケンス番号」で順番が付くんだ。
クラウドおさるシャードは伝言リレーの「列」でござるな! 東の見張り台の報告は 1 列目、西の見張り台は 2 列目と決めておけば、同じ見張り台の報告は順番どおりに届くのでござる。
土肥うまい! それからもう 1 つ大事なのが「保持期間」だよ。Kinesis Data Streams のレコードは、読み取られても消えずに、保持期間のあいだストリームに残るんだ。
| 項目 | 値 |
|---|---|
| 保持期間の既定値 | 24 時間 |
| 設定できる範囲 | 24 時間〜8,760 時間(365 日) |
| 注意点 | 24 時間を超える保持期間には追加料金がかかる |
クラウドおさる読まれても消えないのは、なぜうれしいのでござる?
土肥複数のアプリケーションが、同じストリームのデータをそれぞれ独立して読めるからなんだ。例えば 1 つ目のアプリは集計して DynamoDB のテーブルを更新し、2 つ目のアプリは同じデータを圧縮して S3 にアーカイブする、といった使い方ができるよ。
オンデマンドモードとプロビジョンドモード
クラウドおさるシャードの数は、自分で決めないといけないのでござるか?
土肥「容量モード」で選べるよ。容量モードは、容量の管理方法と課金方法を決めるものなんだ。
| 観点 | オンデマンドモード | プロビジョンドモード |
|---|---|---|
| シャードの管理 | Kinesis Data Streams が自動で管理する | シャード数を自分で指定し、必要に応じて増減する |
| 向いているトラフィック | 変動が大きく予測しにくい | 予測しやすく、容量要件が見積もれる |
| 課金の考え方 | 読み書きしたデータ量に応じて課金 | シャード数に対して時間料金が発生 |
 クラウドおさる
プロビジョンドモードは、データを流していなくてもシャードがある限りバナナが減っていくのでござるな……。
土肥そうなんだ。シャード数に対する時間料金だから、使わないストリームを置きっぱなしにしないことが大事だよ。この記事の実践で Data Streams を作らないのもそのためなんだ。ちなみにオンデマンドモードには、標準のほかにアカウント単位で切り替える「オンデマンドアドバンテージ」というモードもあるけど、まずは「自動で増減するオンデマンド」と「シャード数を決めるプロビジョンド」の 2 つを押さえておけば大丈夫だよ。
Data Firehose の配信とバッファリング
クラウドおさる次は Data Firehose でござる。Data Streams とはどう違うのでござるか?
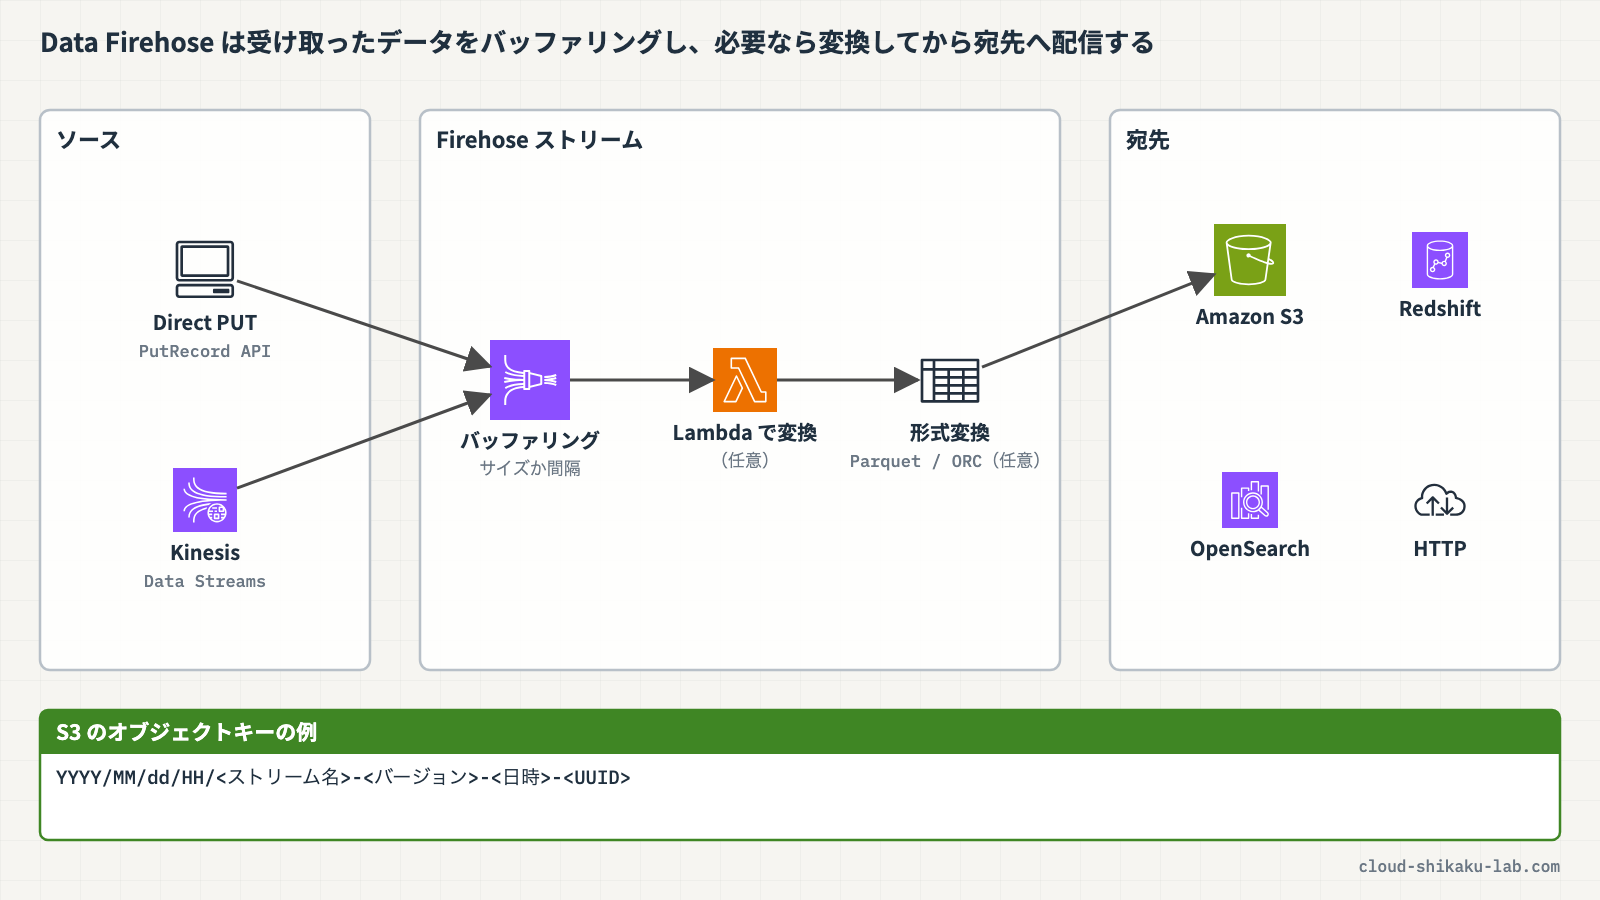
土肥Data Streams は「データを流して、自分で作ったアプリで読む」サービスだったよね。Data Firehose は、データを受け取ったら指定した宛先まで自動で届けてくれるフルマネージドのサービスなんだ。読み取るアプリを書かなくても、Firehose ストリームを作ってデータを送るだけで、S3 や Amazon Redshift、Amazon OpenSearch Service、Splunk、HTTP エンドポイントなどに配信してくれるよ。
クラウドおさる1 件届くたびに、すぐ S3 に置いてくれるのでござるか?
土肥そこがポイントで、Firehose は届いたデータをいったんメモリに「バッファリング」して、ある程度まとめてから宛先に配信するんだ。条件は「バッファサイズ」と「バッファ間隔」の 2 つで、どちらか先に満たされたほうで配信されるよ。S3 が宛先のときの値はこうなっている。
| 設定 | S3 宛先の範囲 | 既定値 |
|---|---|---|
| バッファサイズ | 1〜128 MB | 5 MB |
| バッファ間隔 | 0〜900 秒 | 300 秒 |
クラウドおさる1 本ずつ倉庫に運ぶのではなく、カゴがいっぱいになるか、決めた時間がたったら倉庫に運ぶのでござるな! 小さなファイルが山ほどできるのを防げるのでござる。
土肥その通り! バッファ間隔を 0 秒にするとバッファリングせずに数秒以内に配信する「ゼロバッファリング」もできるけど、60 秒未満にすると S3 にはマルチパートアップロードで書き込むから、S3 の PUT API のコストが少し増えるよ。それと、S3 に配信されるオブジェクトには、既定で UTC の YYYY/MM/dd/HH 形式の時刻プレフィックスが付くんだ。
クラウドおさるUTC ということは、日本時間とは 9 時間ずれるのでござるな。朝 9 時に流したデータが「0 時」のフォルダに入っていても慌てないようにするでござる。
土肥いい注意だね。タイムゾーンは設定で Asia/Tokyo などに変えることもできるよ。それから、Firehose はレコードを区切り文字なしでつなげて 1 つのオブジェクトにするのが既定なんだ。あとで Amazon Athena でクエリしたいなら、レコードの間に改行を入れる「改行区切り文字」を有効にしておこう。Athena については「Amazon Athena で S3 上のデータをSQLクエリで分析する」で紹介しているよ。
配信前の変換と、Data Streams を入力にする構成
クラウドおさる届ける前にデータを加工することはできるのでござるか?
土肥できるよ。Firehose は Lambda 関数を呼び出して、届いたデータを変換してから宛先に配信できるんだ。それとは別に、JSON のデータを列指向の Apache Parquet や Apache ORC に変換してから S3 に保存する「形式変換」もある。列指向の形式は容量を節約できるし、JSON よりクエリが速くなるよ。Lambda については「AWS Lambda で関数を作成しイベント駆動で実行する」で紹介しているね。
クラウドおさるFirehose にはどこからデータを入れるのでござる?
土肥Firehose ストリームを作るときに「ソース」を選ぶんだ。主な選択肢はこの 3 つだよ。
| ソース | 使い方 |
|---|---|
| Direct PUT | プロデューサーが Firehose の PutRecord / PutRecordBatch API で直接書き込む。AWS SDK、CloudWatch Logs、AWS WAF のログなど多くのサービスや Kinesis Agent から送れる |
| Amazon Kinesis Data Streams | 既存の Kinesis データストリームを Firehose が読み取って、宛先に配信する |
| Amazon MSK | 既存の Amazon MSK クラスターからデータを読み取って配信する |
クラウドおさるData Streams と Firehose は、どちらか一方ではなく、つなげて使えるのでござるな!
土肥そうなんだ。Data Streams に流したデータを、集計アプリがリアルタイムに読みつつ、Firehose が同じデータを S3 に配信してためておく、という組み合わせはよくある構成だよ。ただ、Data Streams をソースにすると、Firehose の PutRecord / PutRecordBatch は使えなくなって、データは Data Streams 側の PutRecord / PutRecords で書き込むことになる。今回の実践は、シャードの時間料金がかからない Direct PUT で試すよ。
Amazon SQS との違い
クラウドおさるデータを受け渡すサービスといえば SQS もあったでござる。Kinesis とはどう違うのでござるか?
土肥「受け取ったあとのデータがどうなるか」で比べると分かりやすいよ。SQS のメッセージは受信しても自動では消えないけど、処理が終わったらコンシューマーが削除するのが前提で、1 つのメッセージは 1 つのコンシューマーが処理する作りなんだ。Kinesis Data Streams のレコードは保持期間のあいだ残り続けて、複数のアプリケーションが同じデータを読めるよ。
| 観点 | Amazon SQS | Kinesis Data Streams | Amazon Data Firehose |
|---|---|---|---|
| 主な目的 | システム間を疎結合にするメッセージキュー | ストリームを取り込み、自分のアプリでリアルタイムに処理する | ストリームを宛先へ自動で配信する |
| 処理後のデータ | コンシューマーが削除する | 保持期間(24 時間〜365 日)のあいだ残る | 宛先に配信される |
| 複数の受け手 | 1 つのメッセージは 1 つのコンシューマーが処理する | 複数のアプリケーションが同じデータを独立して読める | 受け手のアプリは不要で、作成時に選んだ宛先へ配信する |
| 保持 | 既定 4 日、1 分〜14 日 | 既定 24 時間、最大 365 日 | 宛先に届けられない場合、最大 24 時間保持して再試行する |
| 読み取りのコード | 必要(ポーリングして受信・削除) | 必要(コンシューマーアプリ) | 不要(宛先まで自動) |
クラウドおさる注文票を 1 枚ずつ担当の猿に渡して、済んだら捨てるのが SQS。見張りの報告を川に流して、何匹もの猿が同じ流れを見られるのが Data Streams。流れを倉庫まで運んで積んでくれるのが Firehose、でござるな!
土肥完璧なまとめだね! 「大量のログやクリックを取り込んでリアルタイムに分析したい」なら Kinesis Data Streams、「とにかく S3 にためて後で Athena で分析したい」なら Data Firehose、「処理単位のタスクを受け渡したい」なら SQS、と考えると選びやすいよ。
実践

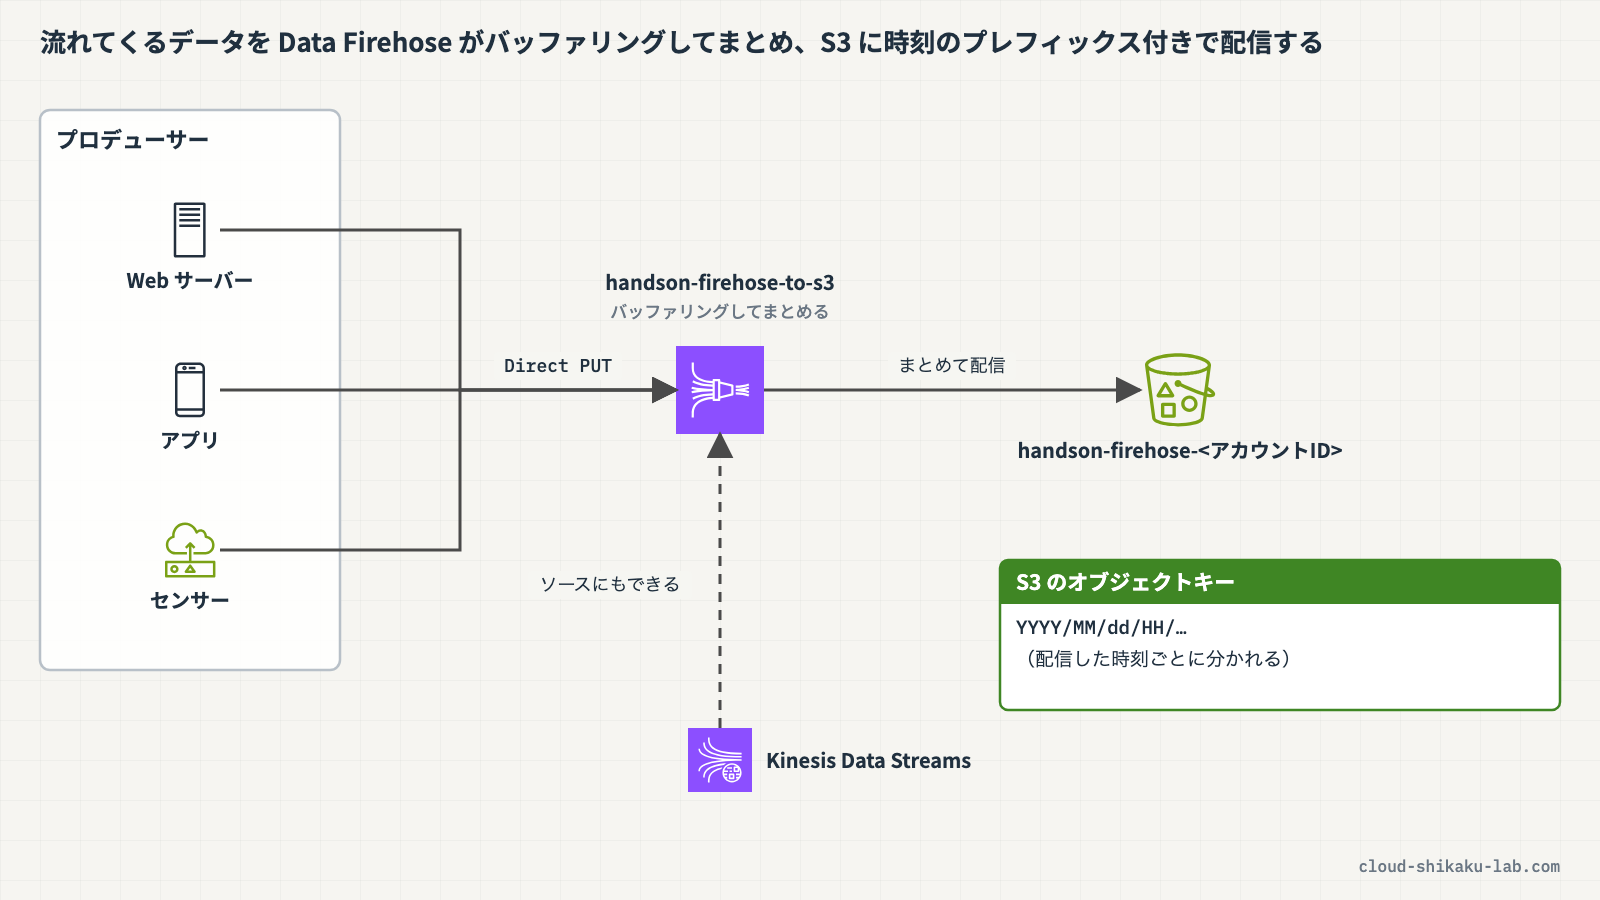
ここでは、Amazon Data Firehose で S3 バケットに配信する Firehose ストリーム(ソースは Direct PUT)を作成します。コンソールのデモデータと、CloudShell からの put-record でデータを流し、バッファ間隔のあとに S3 にオブジェクトができることを確認します。
前提条件
- リージョン:
ap-northeast-1(東京) - AWS マネジメントコンソールにログイン済みで、Amazon Data Firehose・Amazon S3・IAM ロールの作成・AWS CloudShell を操作できる IAM 権限があること
- 事前に作成しておくリソースはありません
作成するリソース一覧
| リソース種別 | リソース名 | 用途 |
|---|---|---|
| S3 バケット | handson-firehose-<アカウントID> | Firehose ストリームの配信先 |
| Firehose ストリーム | handson-firehose-to-s3 | Direct PUT で受けたデータを S3 に配信する |
| IAM ロール | KinesisFirehoseServiceRole-handson--ap-northeast-1-<数字>(Firehose ストリーム作成時にコンソールが自動作成) | Firehose が S3 バケットに書き込むための権限 |
配信先の S3 バケットを作成する
- AWS マネジメントコンソールにログインし、リージョンが
ap-northeast-1(東京)であることを確認します - 上部の検索バーに
S3と入力し、表示された「S3」を選択します - 左側ナビゲーションの「汎用バケット」を選択し、「バケットを作成」をクリックします
- 以下を設定します
- バケット名:
handson-firehose-<アカウントID>(例:handson-firehose-123456789012) - その他の項目はデフォルトのままにします
- ページ下部の「バケットを作成」をクリックします
バケット一覧に handson-firehose-<アカウントID> が表示されれば作成完了です。S3 の基本操作は「Amazon S3 でバケットを作成しオブジェクトを管理する」で扱っています。
Firehose ストリームを作成する
- 上部の検索バーに
Firehoseと入力し、表示された「Amazon Data Firehose」を選択します - 「Firehose ストリームを作成」をクリックします
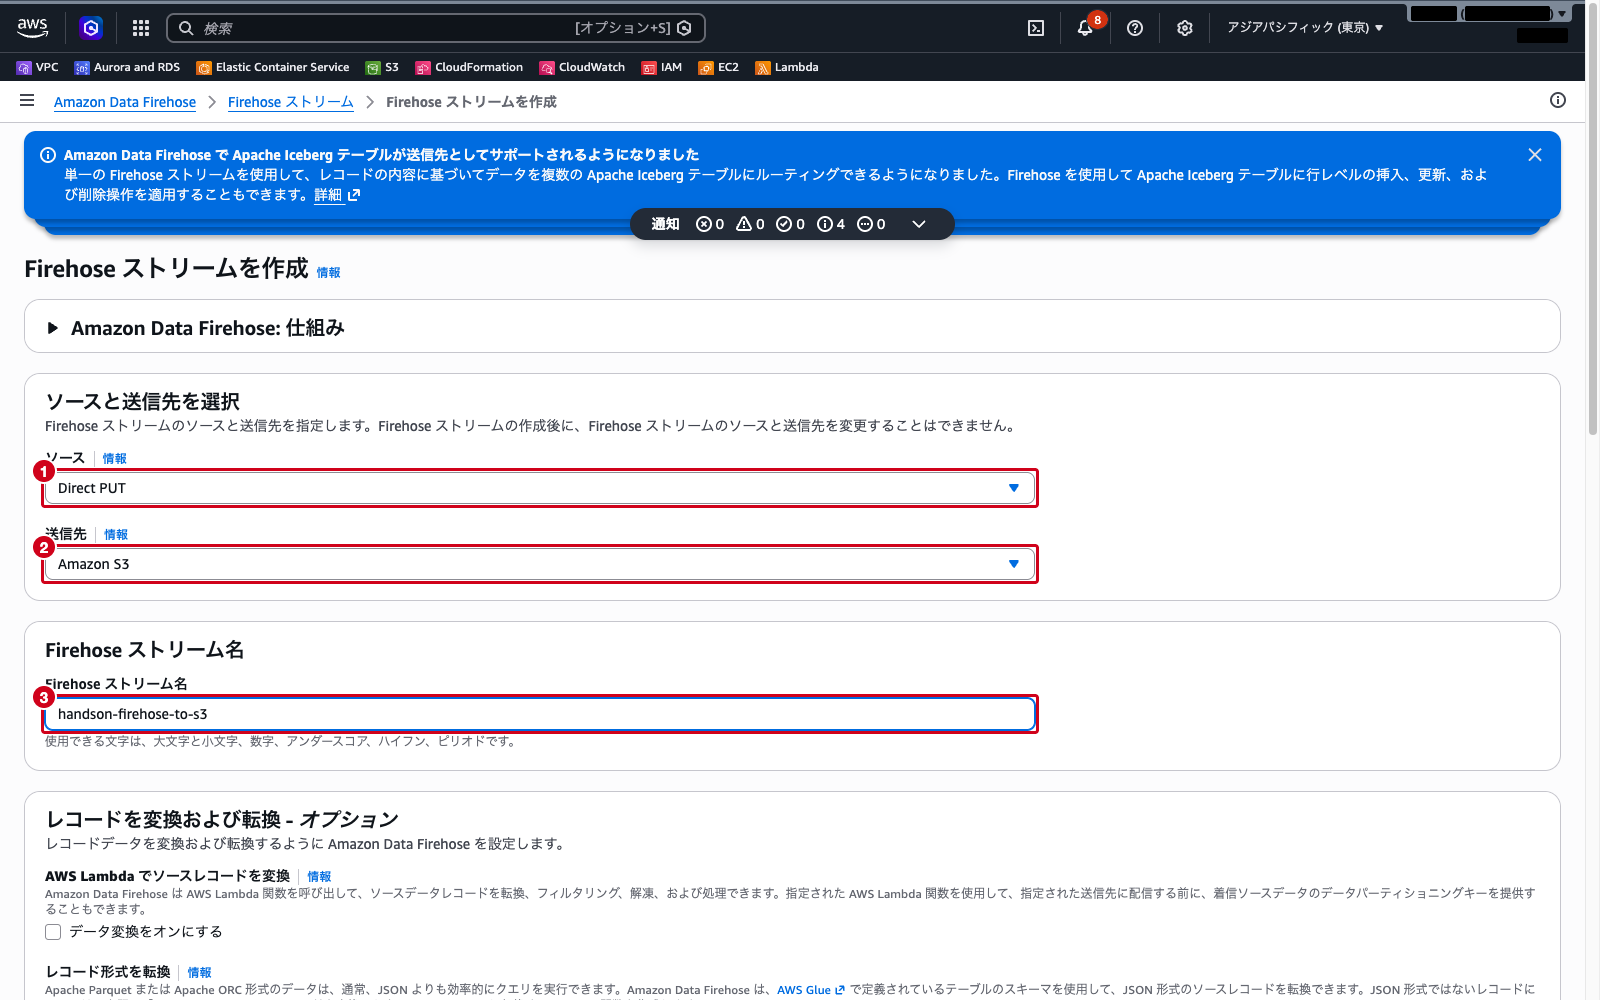
- 「ソースと送信先を選択」で以下を設定します
- ソース:
Direct PUT - 送信先:
Amazon S3 - 「Firehose ストリーム名」に
handson-firehose-to-s3と入力します
- 「レコードを変換および転換 – オプション」セクションは、「データ変換をオンにする」「レコード形式の変換を有効にする」「解凍をオンにする」のいずれもオフ(デフォルト)のままにします
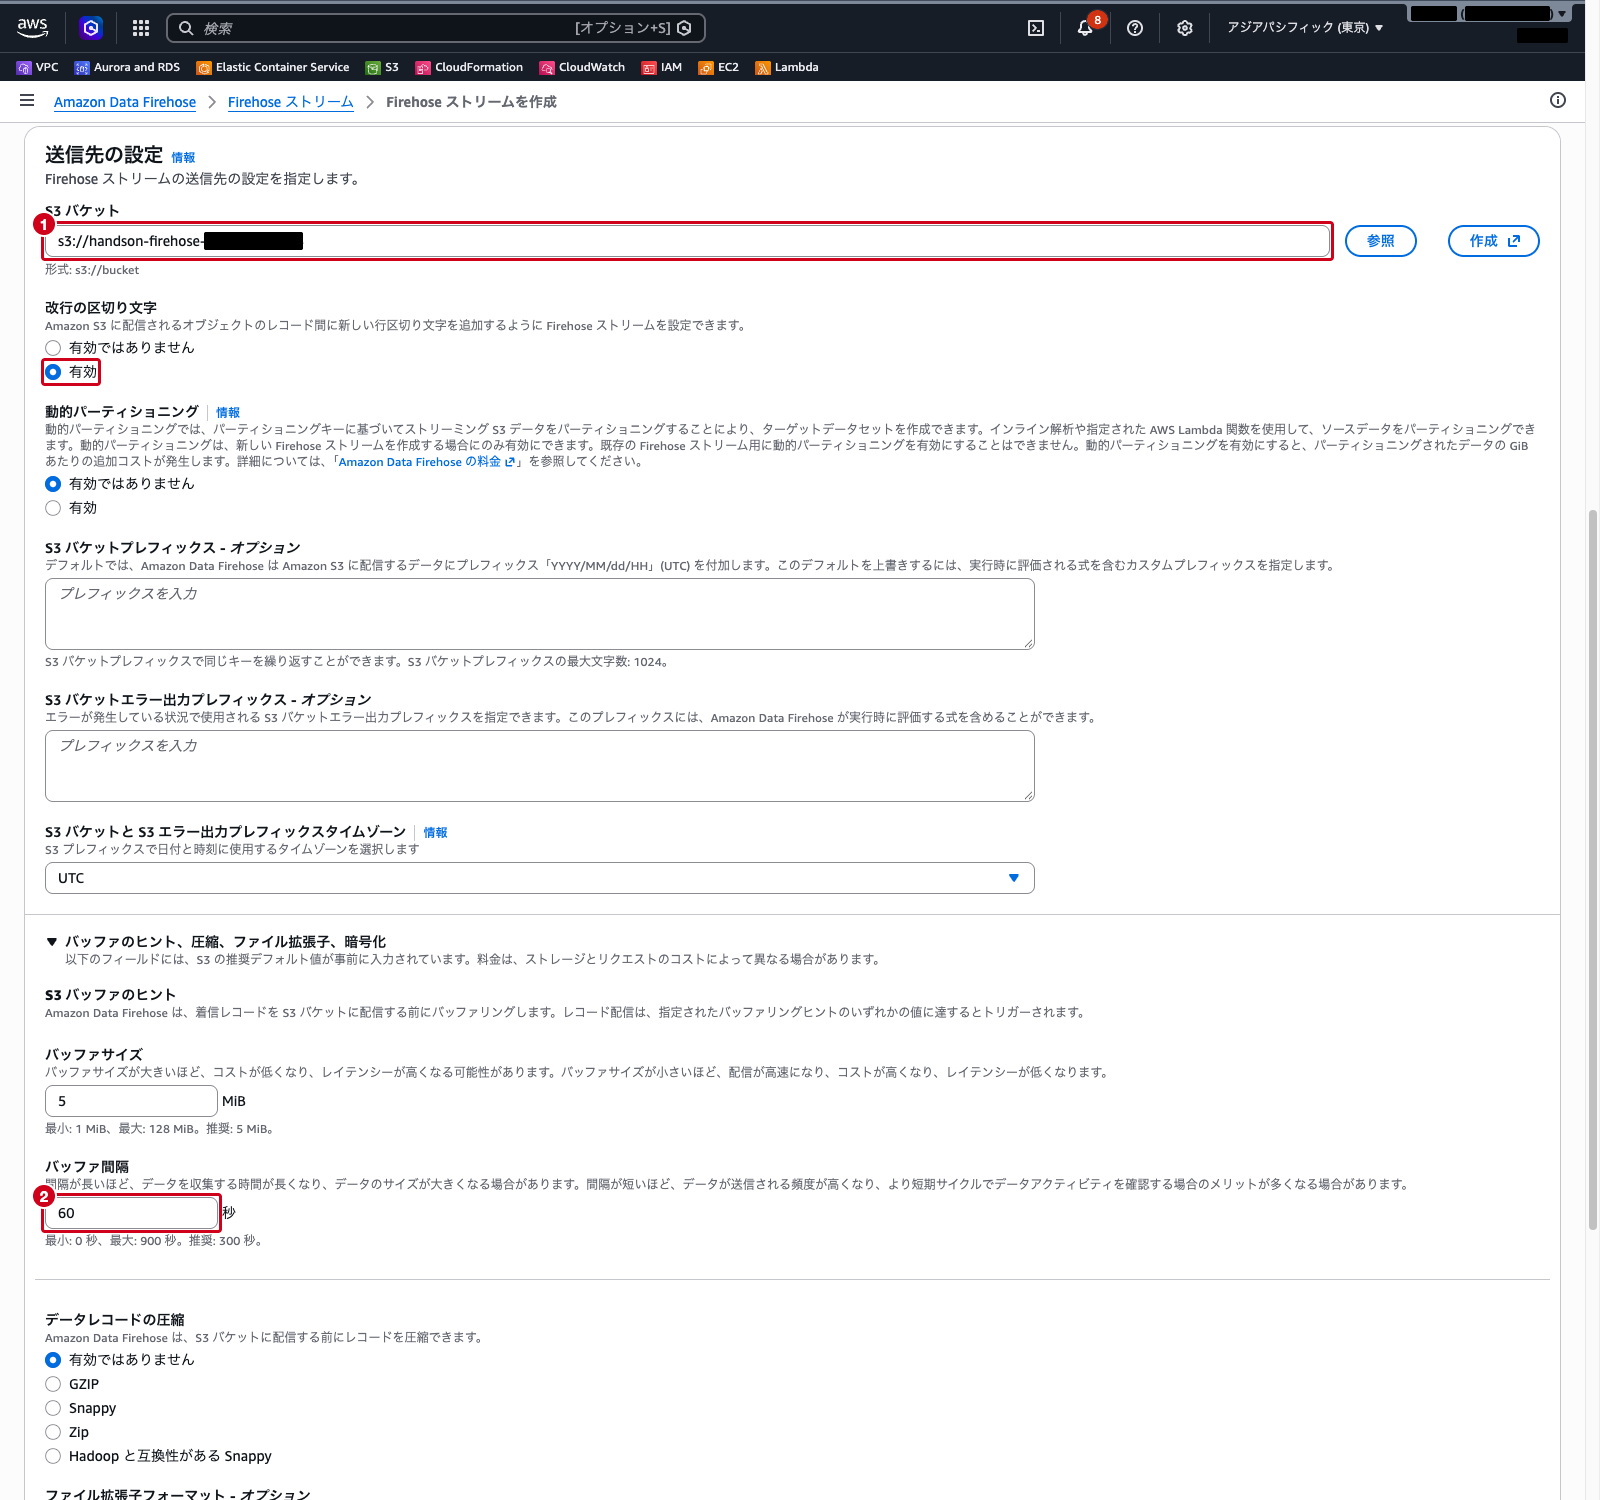
- 「送信先の設定」セクションで以下を設定します
- S3 バケット: 「参照」をクリックし、表示された「Amazon S3 のバケットを選択する」の検索ボックスに
handson-firehoseと入力して、handson-firehose-<アカウントID>を選択し「選択」をクリック - 改行の区切り文字:
有効(デフォルトは「有効ではありません」なので、「有効」に切り替えます) - 「バッファのヒント、圧縮、ファイル拡張子、暗号化」を展開し、以下を設定します
- バッファサイズ:
5MiB(デフォルトのまま) - バッファ間隔:
60秒(結果を早く確認するため、デフォルトの 300 秒から短くします) - S3 バケットプレフィックス、圧縮、暗号化などその他の項目はデフォルトのままにします
- 「詳細設定」を展開し、「サービスアクセス」が「IAM ロール
KinesisFirehoseServiceRole-handson--ap-northeast-1-<数字>を作成または更新」になっている(デフォルト)ことを確認し、そのままにします - ページ下部の「Firehose ストリームを作成」をクリックします(直後に「Firehose ストリームが作成されませんでした」と表示された場合は、IAM ロールが反映されるまで数十秒待ってから、もう一度クリックします)
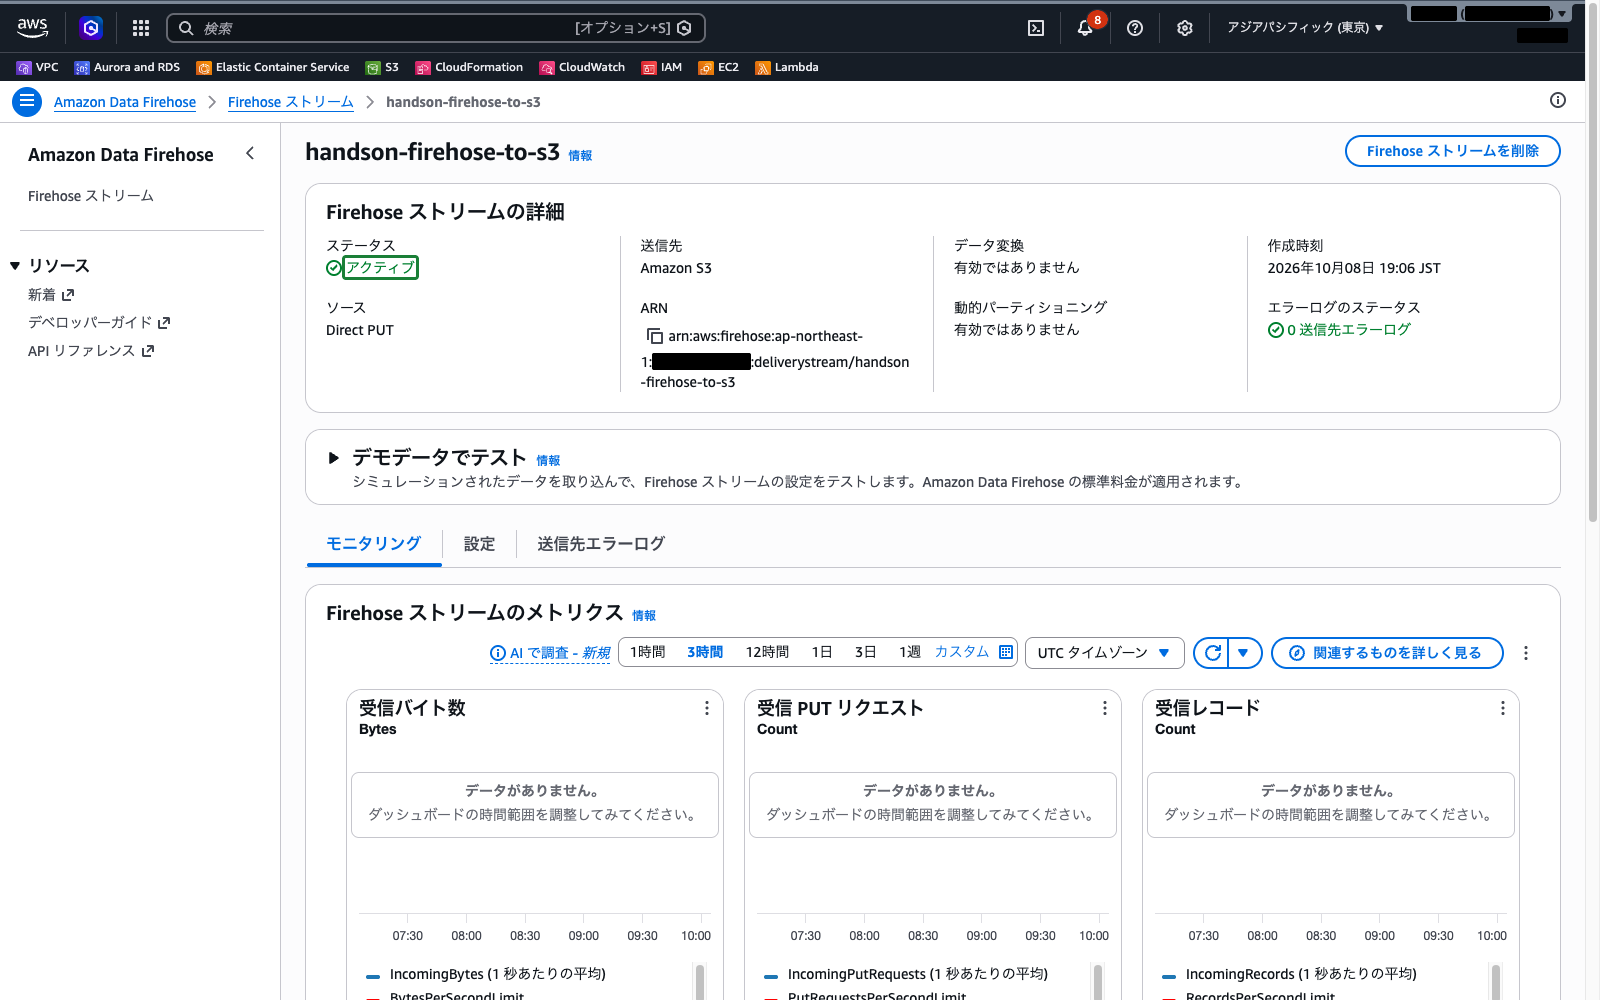
- ストリームの詳細画面が表示され、ステータスが「作成中」から「アクティブ」に変わるまで待ちます
デモデータを送信する
handson-firehose-to-s3の詳細画面で、「デモデータでテスト」セクションを展開します(折りたたまれています)- 「デモデータの送信を開始」をクリックします
- 株価を模したデモデータ(
{"TICKER_SYMBOL":"QXZ","SECTOR":"HEALTHCARE","CHANGE":-0.05,"PRICE":84.51}のような JSON)が Firehose ストリームに送信され始め、ボタンの表示が「デモデータの送信中」に変わります。送信はブラウザでスクリプトを実行して行うため、送信中はこの画面を開いたままにします(別のページに移動すると送信が止まります)
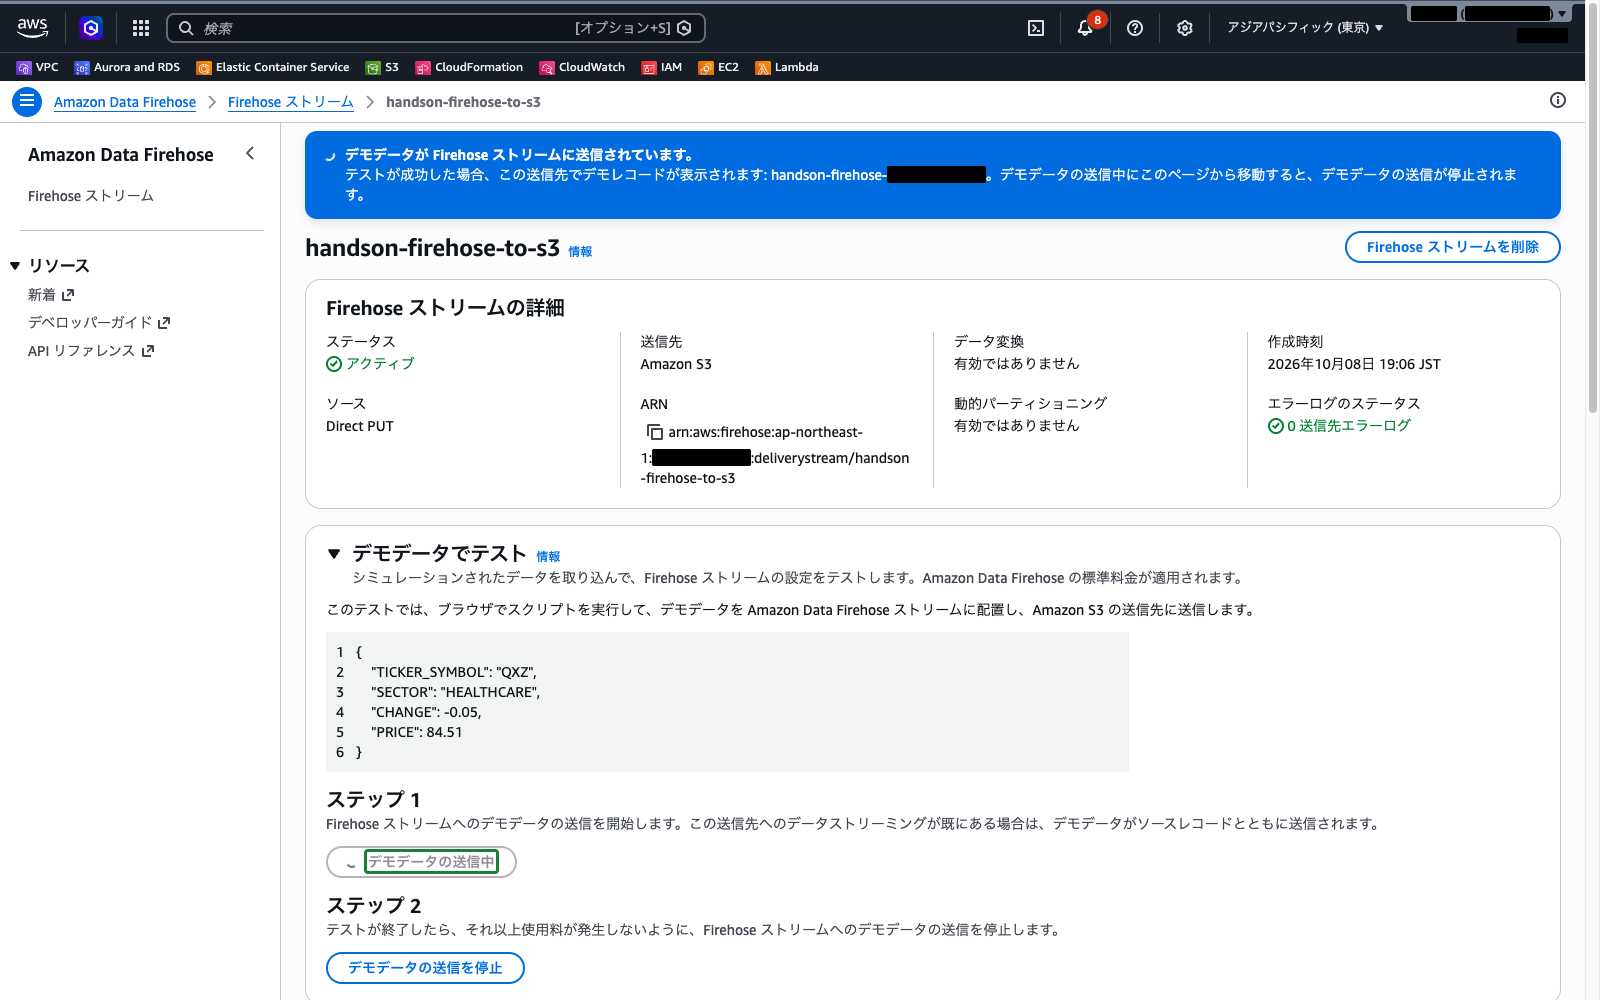
- 2 分ほど待ったら、「デモデータの送信を停止」をクリックします
クラウドおさるデモデータは、生成するだけならタダでも、Firehose ストリームから送られるぶんには通常の料金がかかるのでござる。確認が済んだら「デモデータの送信を停止」を押し忘れないようにするでござるぞ。
S3 にオブジェクトが配信されたことを確認する
- 上部の検索バーに
S3と入力し、表示された「S3」を選択します - 「汎用バケット」から
handson-firehose-<アカウントID>をクリックします - 「オブジェクト」タブに、年のフォルダ(例:
2026/)が作成されていることを確認します 年/→月/→日/→時/の順にフォルダをクリックして開きますhandson-firehose-to-s3-1-2026-...のような名前のオブジェクトが、1 つ以上作成されていることを確認します
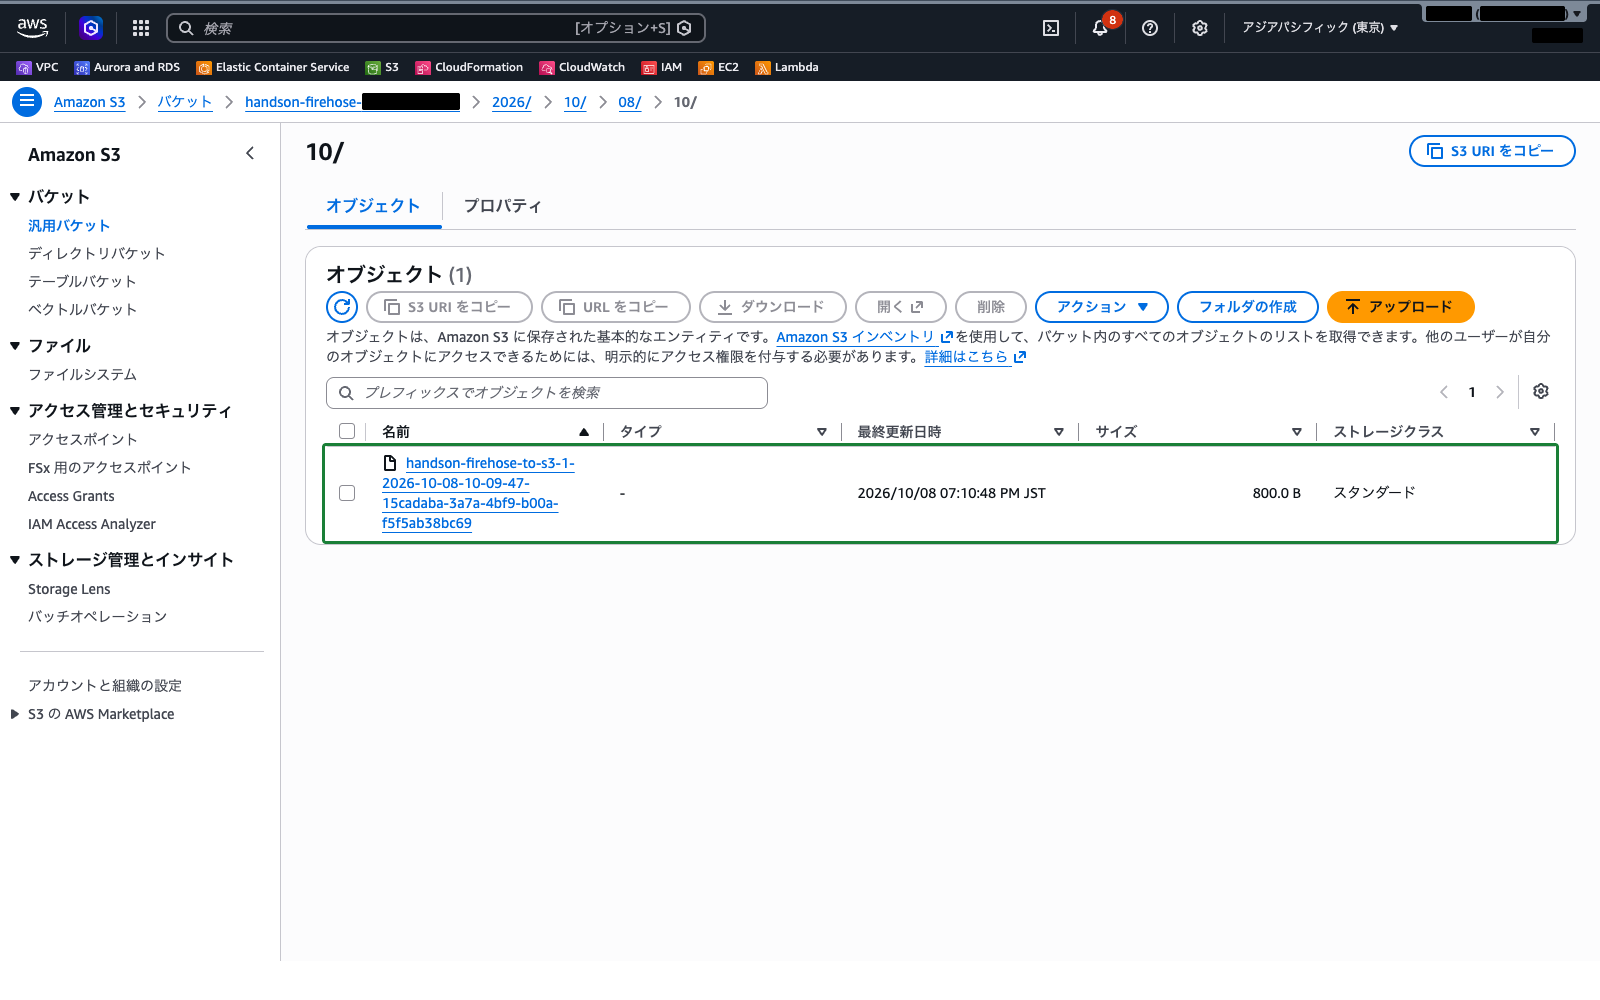
時のフォルダは UTC で作られるため、日本時間とは 9 時間ずれます。オブジェクト名は <Firehose ストリーム名>-<Firehose ストリームバージョン>-<年>-<月>-<日>-<時>-<分>-<秒>-<UUID> の形式で、バッファ間隔の 60 秒ごとにまとめて配信されていることが確認できます。
CloudShell から自分のデータを送信する
次に、CloudShell から AWS CLI の put-record で、自分で作ったレコードを Direct PUT で送信します。
- コンソール上部(またはコンソール左下)の CloudShell アイコンをクリックし、CloudShell を起動します
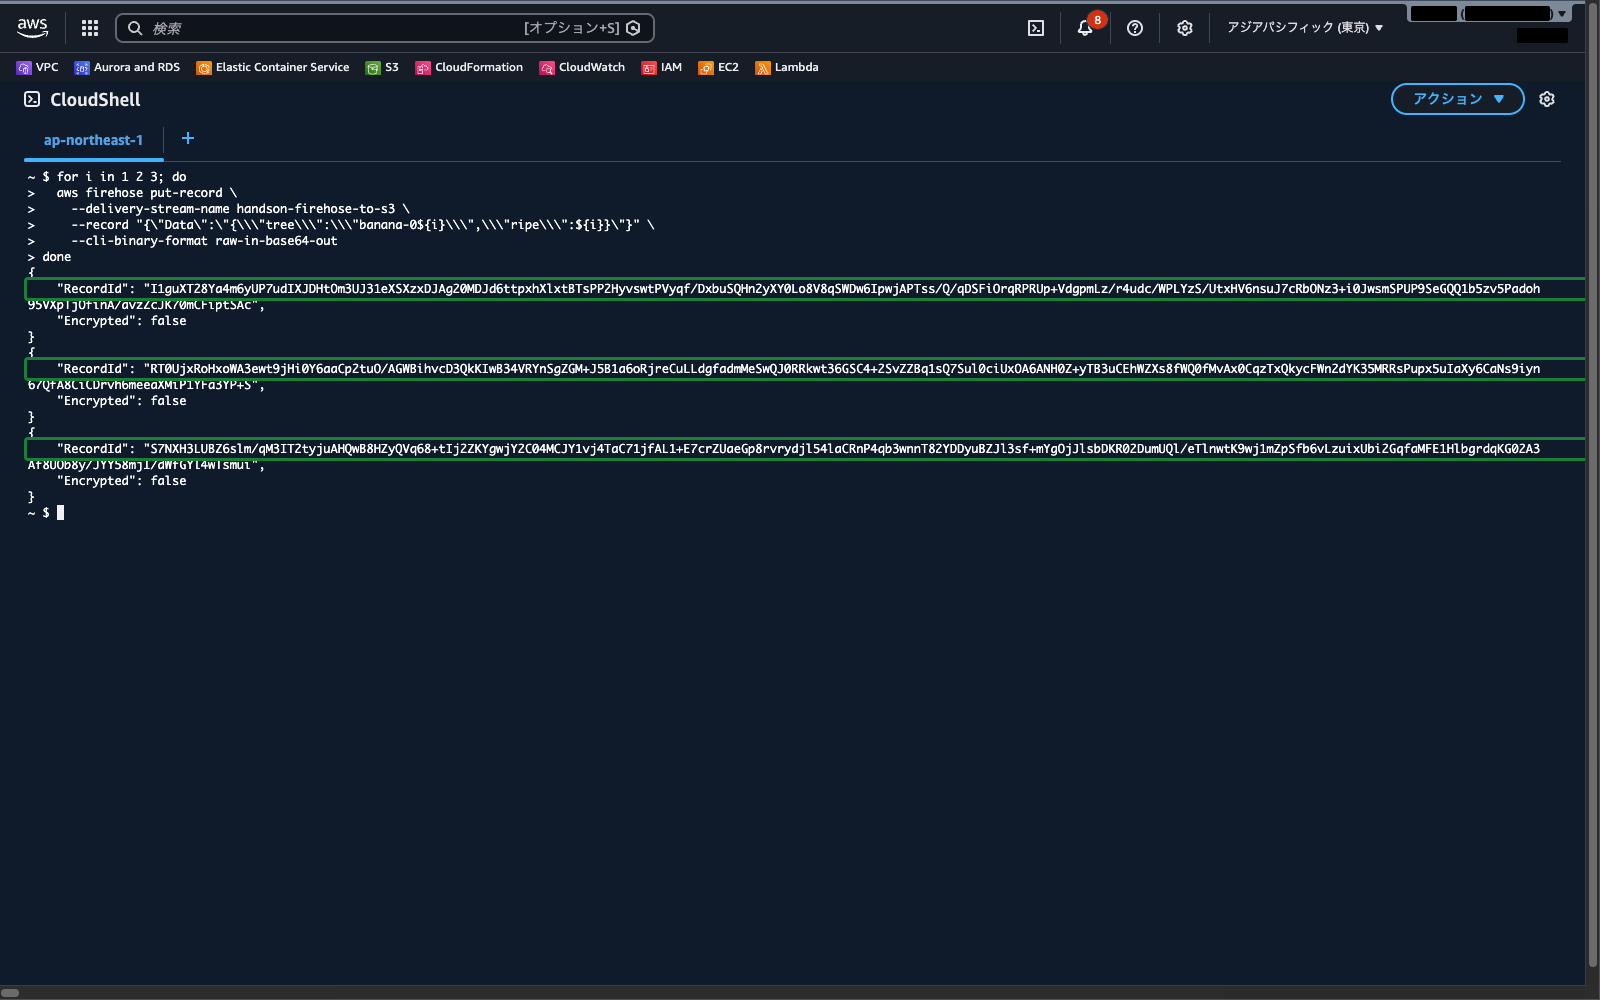
- 以下のコマンドを実行し、3 件のレコードを送信します。AWS CLI バージョン 2 ではバイナリ型のパラメータに base64 文字列を渡すのが既定のため、
--cli-binary-format raw-in-base64-outを付けて JSON 文字列をそのまま渡します
for i in 1 2 3; do
  aws firehose put-record \
    --delivery-stream-name handson-firehose-to-s3 \
    --record "{\"Data\":\"{\\\"tree\\\":\\\"banana-0${i}\\\",\\\"ripe\\\":${i}}\"}" \
    --cli-binary-format raw-in-base64-out
done- 各コマンドの出力に
RecordIdが表示されることを確認します
- 60 秒(バッファ間隔)以上待ってから、以下のコマンドでバケット内のオブジェクトを一覧表示します
BUCKET=handson-firehose-$(aws sts get-caller-identity --query Account --output text)
aws s3 ls s3://${BUCKET}/ --recursive- 一覧の最後(最新)のオブジェクトのキーを指定して、中身を表示します。
<オブジェクトキー>は一覧に表示されたキーに置き換えます。オブジェクトの末尾には改行が入らず、次のプロンプトが最後の行に重なって見えてしまうため、末尾に; echoを付けて改行を出力します
aws s3 cp s3://${BUCKET}/<オブジェクトキー> - ; echo- 以下のように、送信した 3 件のレコードが 1 行ずつ改行で区切られて、1 つのオブジェクトにまとまっていることを確認します
{"tree":"banana-01","ripe":1}
{"tree":"banana-02","ripe":2}
{"tree":"banana-03","ripe":3}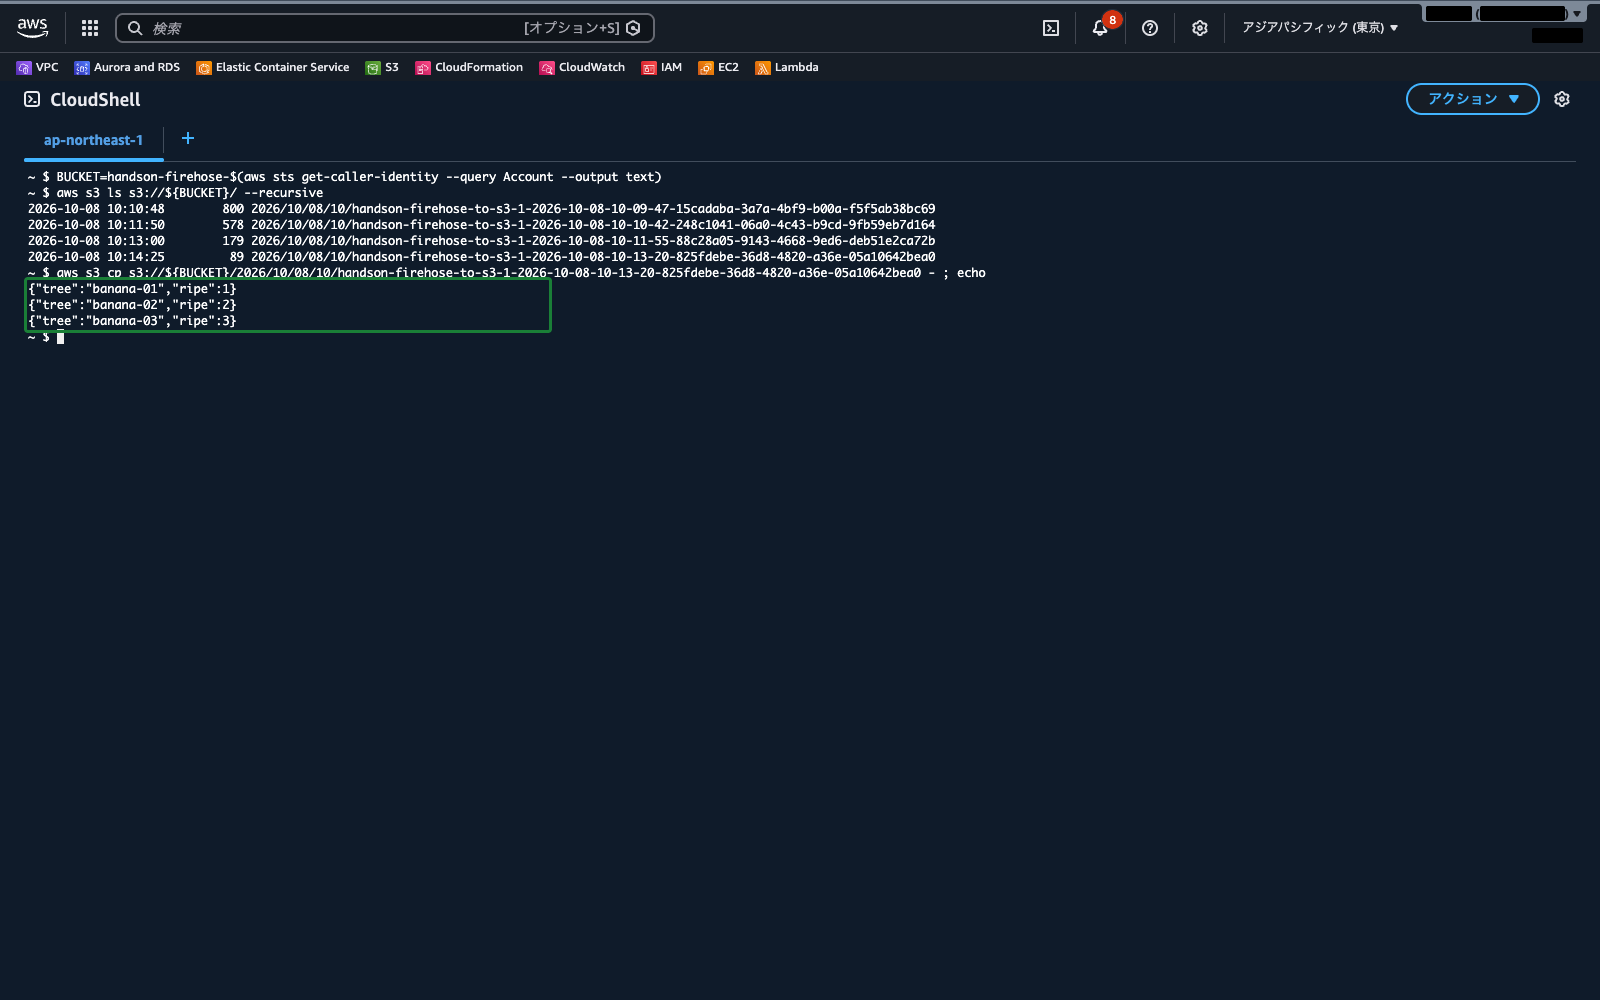
1 件ずつ送ったレコードが、バッファ間隔のあいだにまとめられ、改行区切りの 1 つのオブジェクトとして S3 に配信されたことが確認できます。
クラウドおさる1 本ずつ届けたバナナの報告が、60 秒ごとのカゴにまとめられて倉庫に積まれたでござる。改行で区切っておいたから、あとで Athena で数えるのも楽ちんでござるな。
まとめ
- ストリーミングデータは、ログ・クリックストリーム・センサー値のように発生し続けるデータで、届いたそばから取り込んで処理・保存する
- Kinesis Data Streams はデータを取り込んで自分のアプリで読むサービス、Data Firehose は宛先へ自動で配信するサービス、Kinesis Video Streams は動画、Managed Service for Apache Flink はストリームのリアルタイム処理・分析を担う。Kinesis Data Firehose は Amazon Data Firehose に改名されている
- Kinesis Data Streams はシャード単位で容量が決まり(書き込み 1 MB/秒・1,000 レコード/秒、読み取り 2 MB/秒)、レコードは保持期間(既定 24 時間、最大 365 日)のあいだ残るため、複数のアプリケーションが同じデータを読める
- 容量モードは、自動で管理されデータ量で課金されるオンデマンドと、シャード数を指定しシャード数に時間料金がかかるプロビジョンドがある
- Data Firehose はバッファサイズ(S3 宛先は 1〜128 MB、既定 5 MB)とバッファ間隔(0〜900 秒、既定 300 秒)のどちらか先に満たされた時点で配信する。S3 のオブジェクトには既定で UTC の
YYYY/MM/dd/HHプレフィックスが付く - Firehose は Lambda による変換や、JSON から Parquet / ORC への形式変換を配信前に行える。ソースには Direct PUT のほか Kinesis Data Streams や Amazon MSK を選べる
- SQS は処理後にコンシューマーが削除するメッセージキュー、Kinesis Data Streams は保持期間のあいだ複数のアプリが読めるストリーム、Firehose はストリームを宛先まで運ぶ配信サービスとして使い分ける
参照先
- Amazon Data Firehose とは何ですか? – Amazon Data Firehose
- チュートリアル: コンソールから Firehose ストリームを作成する – Amazon Data Firehose
- Firehose ストリームのソースと宛先を選択する – Amazon Data Firehose
- Amazon Kinesis Data Streams のソース設定を構成する – Amazon Data Firehose
- 宛先の設定を構成する – Amazon Data Firehose
- バックアップの設定を構成する – Amazon Data Firehose
- 詳細設定の設定 – Amazon Data Firehose
- サンプルデータを使用した Firehose ストリームのテスト – Amazon Data Firehose
- Amazon Data Firehose でのデータ配信を理解する – Amazon Data Firehose
- Amazon S3 オブジェクト名の形式を設定する – Amazon Data Firehose
- Amazon Data Firehose でソースデータを変換する – Amazon Data Firehose
- Amazon Data Firehose で入力データ形式を変換する – Amazon Data Firehose
- Amazon Kinesis Data Streams とは – Amazon Kinesis Data Streams
- Amazon Kinesis Data Streams の用語と概念 – Amazon Kinesis Data Streams
- 適切なストリームモードを選ぶ – Amazon Kinesis Data Streams
- クォータと制限 – Amazon Kinesis Data Streams
- Amazon Kinesis Video Streams とは – Amazon Kinesis Video Streams
- Amazon Managed Service for Apache Flink とは? – Managed Service for Apache Flink
- Amazon Simple Queue Serviceとは? – Amazon Simple Queue Service
- Amazon SQS でのメッセージの受信と削除 – Amazon Simple Queue Service
- Amazon SQS コンソールを使用したキューのパラメータの設定 – Amazon Simple Queue Service
- とは AWS CloudShell – AWS CloudShell
- Configuration and credential file settings in the AWS CLI – AWS Command Line Interface
- put-record – AWS CLI Command Reference