概要
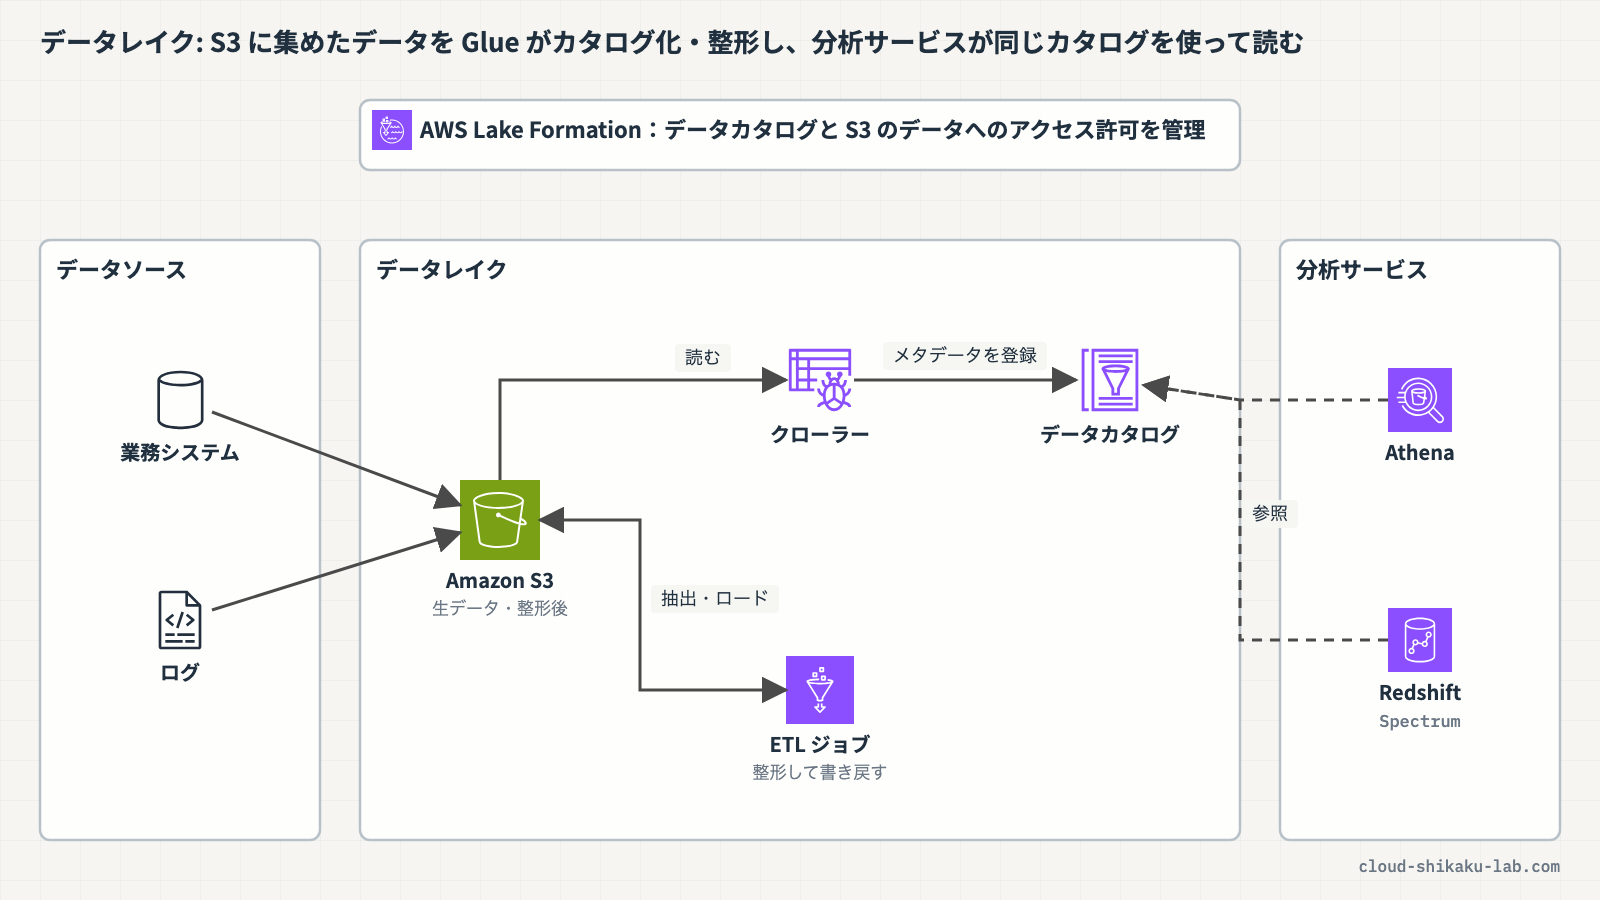
売上・ログ・センサーの値など、業務のデータは形式も置き場所もばらばらに生まれます。これらをまず Amazon S3 に集めて一元的に保存し、必要に応じて変換しながら分析する考え方を「データレイク」と呼びます。データレイクで最初に困るのが「S3 に何が置いてあって、どんな列があるのか」が分からないことです。
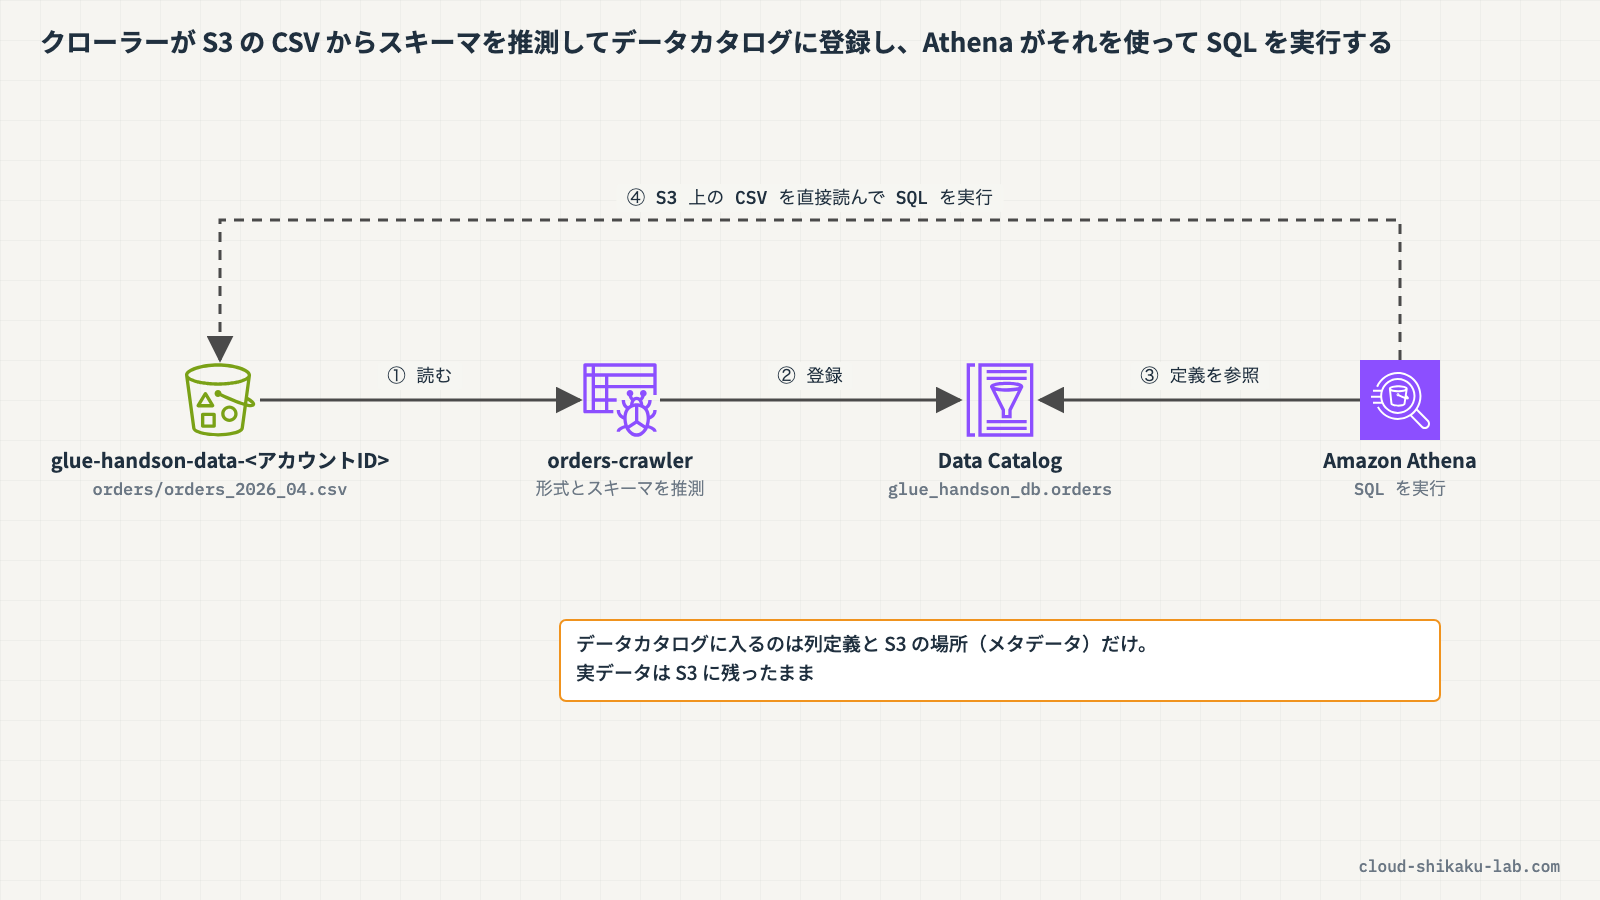
AWS Glue は、複数のソースからのデータを検出・準備・移動・統合するためのサーバーレスのデータ統合サービスです。Glue のクローラーは S3 上のファイルを調べて列名や型(スキーマ)を推測し、AWS Glue Data Catalog(データカタログ)にテーブルとして登録します。登録されたテーブルは Amazon Athena からそのまま SQL で参照できるため、「置く → カタログに載せる → クエリする」というデータレイクの基本の流れを、サーバーを用意せずに組み立てられます。Athena そのものの使い方は Amazon Athena で S3 上のデータをSQLクエリで分析する、S3 の基本操作は Amazon S3 でバケットを作成しオブジェクトを管理する で扱っています。
本記事では、データレイクと ETL の考え方、Glue の構成要素(データカタログ・クローラー・ETL ジョブ・Glue Studio・DataBrew)、Athena・Lake Formation・Redshift との関係を解説したうえで、S3 に置いた小さな CSV をクローラーでデータカタログに登録し、スキーマを確認して Athena でクエリするまでを体験します。
 クラウドおさる
猿山のバナナ倉庫も、どの棚に何が入っているかの台帳がないと、探すだけで日が暮れるでござる。この記事では、Glue のクローラーに台帳を作らせて、Athena でその台帳を頼りにデータを引くところまで確かめるのでござる!
この記事のメリット
- データレイクと ETL(抽出・変換・ロード)の考え方を説明できる
- AWS Glue の構成要素(データカタログ・クローラー・ETL ジョブ・Glue Studio・DataBrew)の役割を把握できる
- Glue のデータカタログを中心に、Athena・Lake Formation・Redshift Spectrum がどうつながるかを理解できる
- クローラーと ETL ジョブがどのような単位で課金されるかを把握できる
- S3 の CSV をクローラーでテーブル化し、Athena でクエリするまでを一通り体験できる
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
 クラウドおさる
はじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
クラウドおさる基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
データレイクと ETL
クラウドおさるとひさん、「データレイク」という言葉をよく聞くでござる。データの湖とは何でござるか?
 土肥
データレイクは、いろんなデータを 1 か所の保管庫にまとめて置いて、分類したりカタログ化したり保護したりしながら、いろんな人やツールで分析できるようにする「設計の考え方」なんだ。表形式の構造化データだけじゃなくて、JSON みたいな半構造化データや、画像のような非構造化データもそのまま取り込めるのが特徴だよ。
 クラウドおさる
何でも放り込める湖でござるか。では、その湖はどこに作るのでござる?
土肥AWS だと、保管庫の中心になるのは Amazon S3 だね。容量を気にせず置けて、可用性も高いから、データレイクの置き場所として定番なんだ。
クラウドおさる猿山でいえば、どの群れが採ってきたバナナもまず大倉庫に入れてしまう、ということでござるな!
土肥そうそう。で、倉庫に入れたままだと使いにくいデータもあるよね。そこで出てくるのが ETL。Extract(抽出)、Transform(変換)、Load(ロード)の頭文字で、元のデータを取り出して、分析しやすい形に整えて、別の場所に入れ直す処理のことだよ。たとえば日付の書き方をそろえたり、不要な列を落としたり、分析向けのファイル形式に変えたりするんだ。
| 用語 | 意味 |
|---|---|
| データレイク | 構造化・半構造化・非構造化データを一元的に保存し、カタログ化・保護しながら多様なツールで分析する考え方。AWS では S3 が保存先の中心 |
| ETL | データを抽出(Extract)し、変換(Transform)して、分析用の保存先へロード(Load)する処理 |
| メタデータ | データそのものではなく「どこに・どんな列が・どの形式で」あるかという情報 |
AWS Glue の構成要素
クラウドおさるその流れの中で、AWS Glue はどこを受け持つのでござるか?
土肥Glue はサーバーレスのデータ統合サービスで、「データを見つけて、整理して、整えて、運ぶ」ところを広く受け持つんだ。部品がいくつかあるから、まとめておくね。
| 構成要素 | 役割 |
|---|---|
| データカタログ(AWS Glue Data Catalog) | データの場所・スキーマなどのメタデータを保存する永続的なストア。テーブルを束ねる「データベース」と、データの集合を表す「テーブル」で構成する |
| クローラー | データストアを調べてデータの形式とスキーマを推測し、データカタログのテーブルを作成・更新する |
| 分類子 | クローラーがデータの形式を判定する仕組み。CSV・JSON・Avro などの組み込み分類子があり、独自の分類子も追加できる |
| ETL ジョブ | データの抽出・変換・ロードを行う処理。スケジュール・オンデマンド・イベントをきっかけに実行できる |
| AWS Glue Studio | ETL ジョブを画面上で組み立て、実行・監視できるグラフィカルなインターフェイス。ジョブのコードを自動生成する |
| AWS Glue DataBrew | コードを書かずにデータのクリーニングや正規化ができるビジュアルなデータ準備ツール。250 を超える既製の変換を用意している |
クラウドおさるデータカタログには、データそのものは入っていないのでござるか?
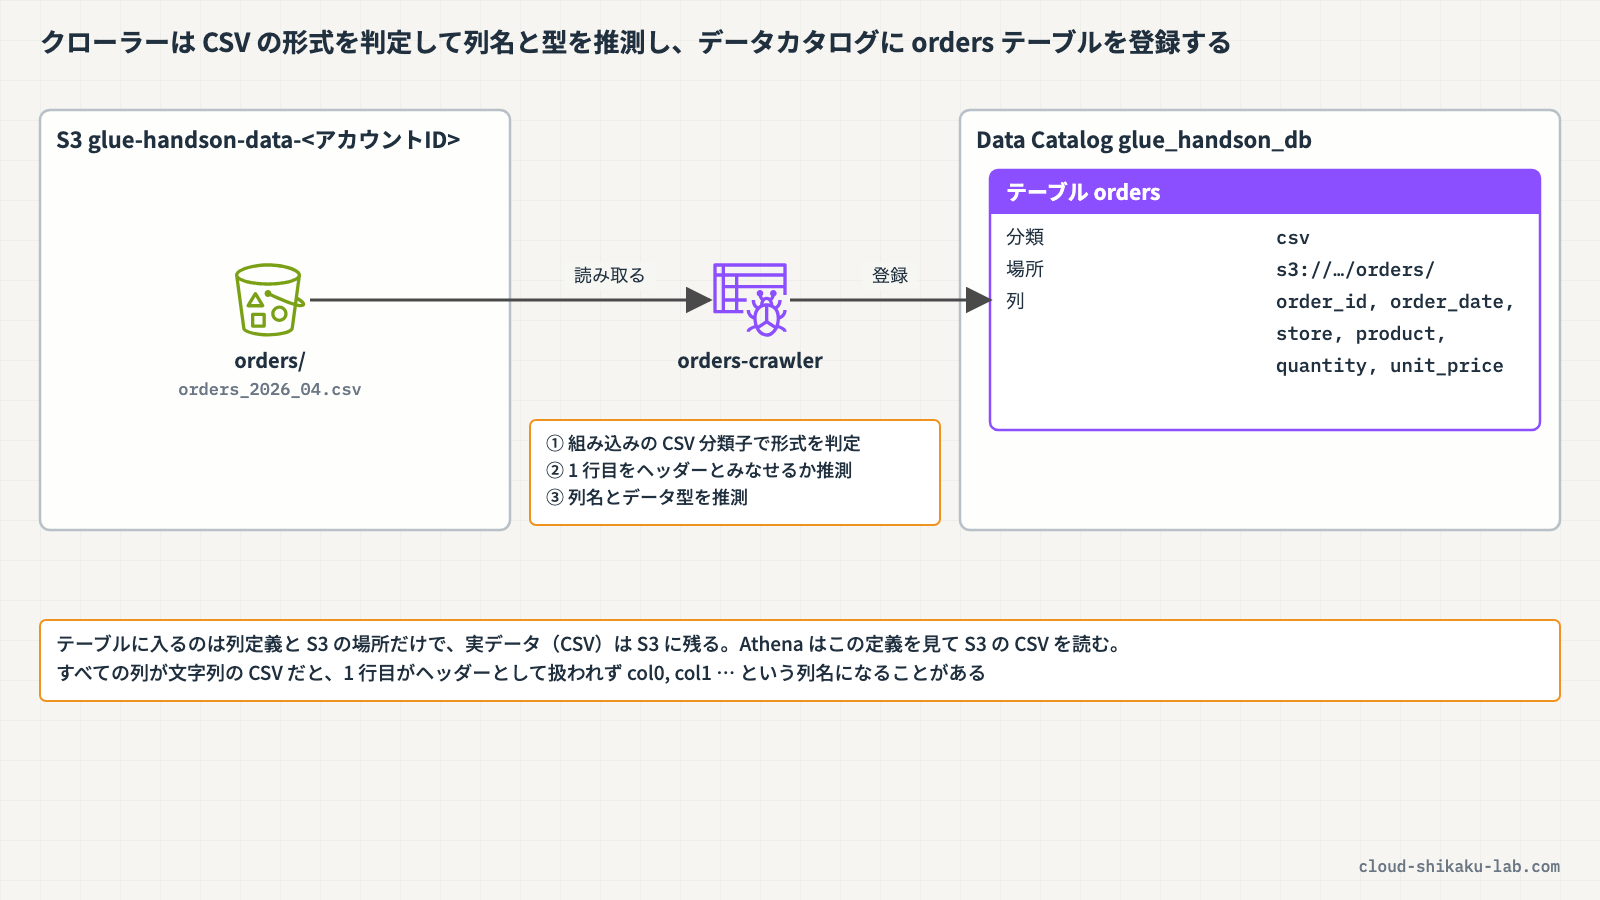
土肥いいところに気づいたね! データカタログが持つのはメタデータだけで、実データは S3 に置いたままなんだ。図書館の目録カードみたいなもので、本(データ)は棚(S3)にあって、カードには「どの棚に、どんな本があるか」が書いてあるイメージかな。
クラウドおさる倉庫の台帳でござるな! 台帳だけ見れば、どの棚のバナナが何房かが分かるのでござる。
土肥そうそう。それで、その台帳を自動で書いてくれるのがクローラーなんだ。クローラーは実行されると、まず分類子でデータの形式を判定して、ファイルをテーブルにまとめて、列名や型をデータカタログに書き込むよ。CSV の場合は、カンマ・パイプ・タブなどの区切り文字や、1 行目がヘッダーかどうかも推測するんだ。
 クラウドおさる
推測ということは、外れることもあるのでござるか?
土肥あるよ。たとえば CSV のすべての列が文字列だと、1 行目のヘッダーとデータ行の見分けがつかなくて、ヘッダーとして扱われないんだ。だからクローラーを流したあとは、データカタログでスキーマを確認する習慣をつけておくと安心だね。今回の実践でも確認するよ。
Athena・Lake Formation・Redshift との関係
クラウドおさるデータカタログにテーブルができたあと、それを使うのは誰でござるか?
土肥代表は Amazon Athena だね。Athena は Glue のデータカタログを使ってテーブル定義を保存・取得していて、クエリを実行するときはその定義を見て S3 のデータを読みにいくんだ。Athena のクエリエディタでは、このカタログは AwsDataCatalog という名前で見えるよ。
クラウドおさる台帳を Glue が書いて、Athena がその台帳を見て倉庫に取りにいくのでござるな! ほかにも台帳を見る者はおるのでござるか?
土肥Amazon Redshift の Redshift Spectrum も、S3 のデータを Redshift のテーブルにロードせずにクエリできる機能で、外部スキーマを通じてデータカタログのテーブルを参照できるよ。同じ台帳を、Athena でも Redshift でも使い回せるのがポイントなんだ。
クラウドおさるみんなが同じ台帳を見るとなると、見せてよい者と見せてはいけない者を分けたくなるでござる……。
土肥そこで出てくるのが AWS Lake Formation。S3 上のデータレイクのデータと、データカタログのメタデータに対するきめ細かなアクセス制御を管理するサービスなんだ。列・行・セルの単位で権限を絞れて、その権限が Athena・Redshift Spectrum・Amazon EMR・Glue などで共通に効くよ。
| サービス | データカタログとの関係 |
|---|---|
| Amazon Athena | データカタログのテーブル定義を使って、S3 のデータにサーバーレスで SQL を実行する |
| Amazon Redshift Spectrum | 外部スキーマを通じてデータカタログを参照し、S3 のデータを Redshift にロードせずにクエリする |
| AWS Lake Formation | データカタログと S3 上のデータへのアクセス許可を、列・行・セルの単位で一元管理する |
クローラーと ETL ジョブの料金の考え方
クラウドおさるGlue はサーバーレスとのことでござるが、お代はどう決まるのでござるか?
土肥クローラーも ETL ジョブも、動いていた時間に対して時間単価で課金されて、秒単位で計算されるんだ。ただし 1 回の実行ごとに最低料金があって、クローラーは最低 10 分、ETL ジョブは最低 1 分ぶんかかるよ。ETL ジョブの場合は、使った DPU(データ処理ユニット)の数に基づいて時間あたりの料金がかかるよ。DPU は処理能力の単位で、1 DPU が 4 vCPU と 16 GB のメモリに当たるんだ。
クラウドおさるDPU の数はどうやって決まるのでござる?
土肥Spark のジョブなら、ワーカータイプとワーカー数で決まるよ。たとえばワーカータイプ G.1X は 1 ワーカーあたり 1 DPU、G.2X は 2 DPU なんだ。ワーカーを大きく・多くするほど速く処理できるけど、そのぶん DPU が増えるから、「DPU の数 × 実行時間」で料金が膨らむって覚えておくといいね。今回の実践では ETL ジョブは動かさず、クローラーと Athena だけを使うよ。
| 対象 | 課金の単位 |
|---|---|
| クローラー | 実行時間に対する時間単価(秒単位で計算。1 回の実行あたり最低 10 分) |
| ETL ジョブ | 使用した DPU の数に基づく時間単価(秒単位で計算。1 回の実行あたり最低 1 分)。1 DPU = 4 vCPU・16 GB メモリ |
| データカタログ | 保存しているメタデータとアクセスに対する月額。最初の 100 万オブジェクトの保存と 100 万回のアクセスは無料 |
クラウドおさるETL ジョブは「DPU の数 × 動いた時間」でござるな。猿手を何匹、何時間雇ったかでバナナの支払いが決まる、と覚えておくでござる。
実践

ここでは、S3 に小さな CSV を置き、Glue のクローラーでデータカタログにテーブルを登録してスキーマを確認したあと、Athena からクエリします。最後に、同じフォルダへファイルを追加して、クローラーを再実行しなくても Athena の結果に反映されることを確かめます。
前提条件
- リージョン:
ap-northeast-1(東京) - AWS マネジメントコンソールにログイン済みで、S3・AWS Glue・Athena を操作できる権限があること
- クローラー用の IAM ロールをコンソールから作成するため、IAM ロールとポリシーを作成できる権限(
iam:CreateRole、iam:CreatePolicy、iam:AttachRolePolicy)があること
AWS Glue のコンソールは、言語設定を日本語にしていても英語で表示されることがあります。本記事の Glue の手順は、画面の英語表記のまま記載しています。
作成するリソース一覧
| リソース種別 | リソース名 | 用途 |
|---|---|---|
| S3 バケット | glue-handson-data-<アカウントID> | CSV データの格納先 |
| S3 バケット | glue-handson-athena-results-<アカウントID> | Athena のクエリ結果の保存先 |
| Glue データベース | glue_handson_db | クローラーが作るテーブルの登録先 |
| IAM ロール | AWSGlueServiceRole-glue-handson | クローラーが S3 を読み、データカタログに書き込むためのロール |
| Glue クローラー | orders-crawler | orders/ フォルダの CSV をクロールする |
| Glue テーブル | orders(クローラーが自動作成) | CSV のスキーマ定義 |
S3 バケット名はグローバルで一意にする必要があるため、
<アカウントID>の部分をご自身の AWS アカウント ID に置き換えてください。
サンプルデータを用意する
ローカルマシンで、以下の内容を orders_2026_04.csv として保存します。数値の列を含めておくと、クローラーが 1 行目をヘッダーと判定しやすくなります。
order_id,order_date,store,product,quantity,unit_price
1001,2026-04-01,tokyo,banana,12,150
1002,2026-04-01,osaka,apple,5,220
1003,2026-04-02,tokyo,orange,8,180
1004,2026-04-03,fukuoka,banana,20,150
1005,2026-04-03,osaka,banana,7,150
1006,2026-04-04,tokyo,apple,3,220
1007,2026-04-05,fukuoka,orange,10,180
1008,2026-04-05,tokyo,banana,15,150あわせて、後半で追加するファイルとして、以下の内容を orders_2026_05.csv として保存しておきます。
order_id,order_date,store,product,quantity,unit_price
1009,2026-05-01,osaka,orange,6,180
1010,2026-05-02,tokyo,banana,25,150
1011,2026-05-02,fukuoka,apple,4,220S3 バケットを作成して CSV をアップロードする
- AWS マネジメントコンソールにログインし、リージョンが
ap-northeast-1(東京)であることを確認します - 上部の検索バーに
S3と入力し、表示された「S3」を選択します - 左側ナビゲーションの「汎用バケット」を選択し、「バケットを作成」をクリックします
- バケット名に
glue-handson-data-<アカウントID>と入力します - その他の項目はデフォルトのままにし、ページ下部の「バケットを作成」をクリックします
- 同じ手順で、クエリ結果の保存先として
glue-handson-athena-results-<アカウントID>も作成します - バケット一覧から
glue-handson-data-<アカウントID>をクリックして開きます - 「フォルダの作成」をクリックし、フォルダ名に
ordersと入力して「フォルダの作成」をクリックします ordersフォルダを開き、「アップロード」をクリックします- 「ファイルを追加」をクリックして
orders_2026_04.csvを選択し、「アップロード」をクリックします
orders/ フォルダに orders_2026_04.csv が表示されればアップロード完了です。orders_2026_05.csv はこの時点ではアップロードしません。
Glue のデータベースを作成する
- 上部の検索バーに
Glueと入力し、表示された「AWS Glue」を選択します - 左側ナビゲーションの「Data Catalog」を展開し、「Databases」を選択します
- 「Add database」をクリックします
- 名前(Name)に
glue_handson_dbと入力します - その他の項目はデフォルトのままにし、「Create database」をクリックします
データベース一覧に glue_handson_db が表示されることを確認します。
クローラーを作成する
- 左側ナビゲーションの「Data Catalog」を展開し、「Crawlers」を選択します
- 「Create crawler」をクリックします
- 「Step 1: Set crawler properties」で、名前(Name)に
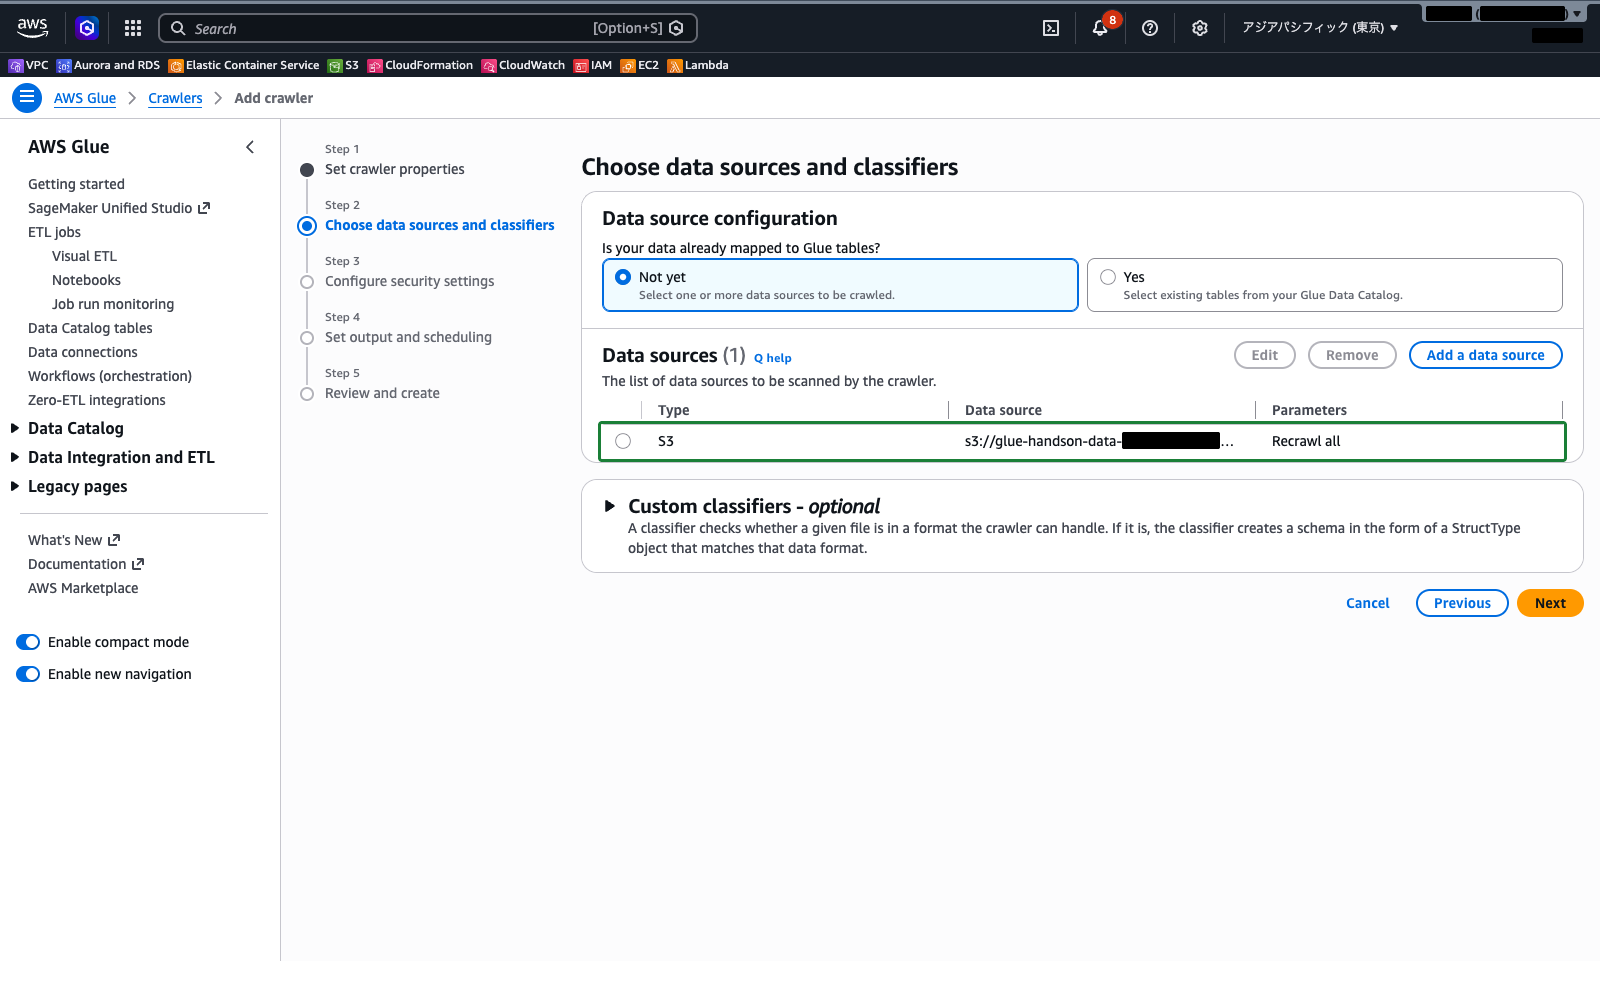
orders-crawlerと入力し、「Next」をクリックします - 「Step 2: Choose data sources and classifiers」の「Data source configuration」で、「Is your data already mapped to Glue tables?」に「Not yet」が選択されていることを確認します(デフォルトです)
- 「Add a data source」をクリックし、表示されたダイアログで以下を設定します
- Data source:
S3(デフォルト) - Location of S3 data:
In this account(デフォルト) - S3 path:
s3://glue-handson-data-<アカウントID>/orders/(「Browse S3」からordersフォルダを選んでも構いません) - Subsequent crawler runs:
Crawl all sub-folders(デフォルト) - 「Add an S3 data source」をクリックします
- 「Data sources」の一覧に S3 パスが追加されたことを確認し、「Next」をクリックします
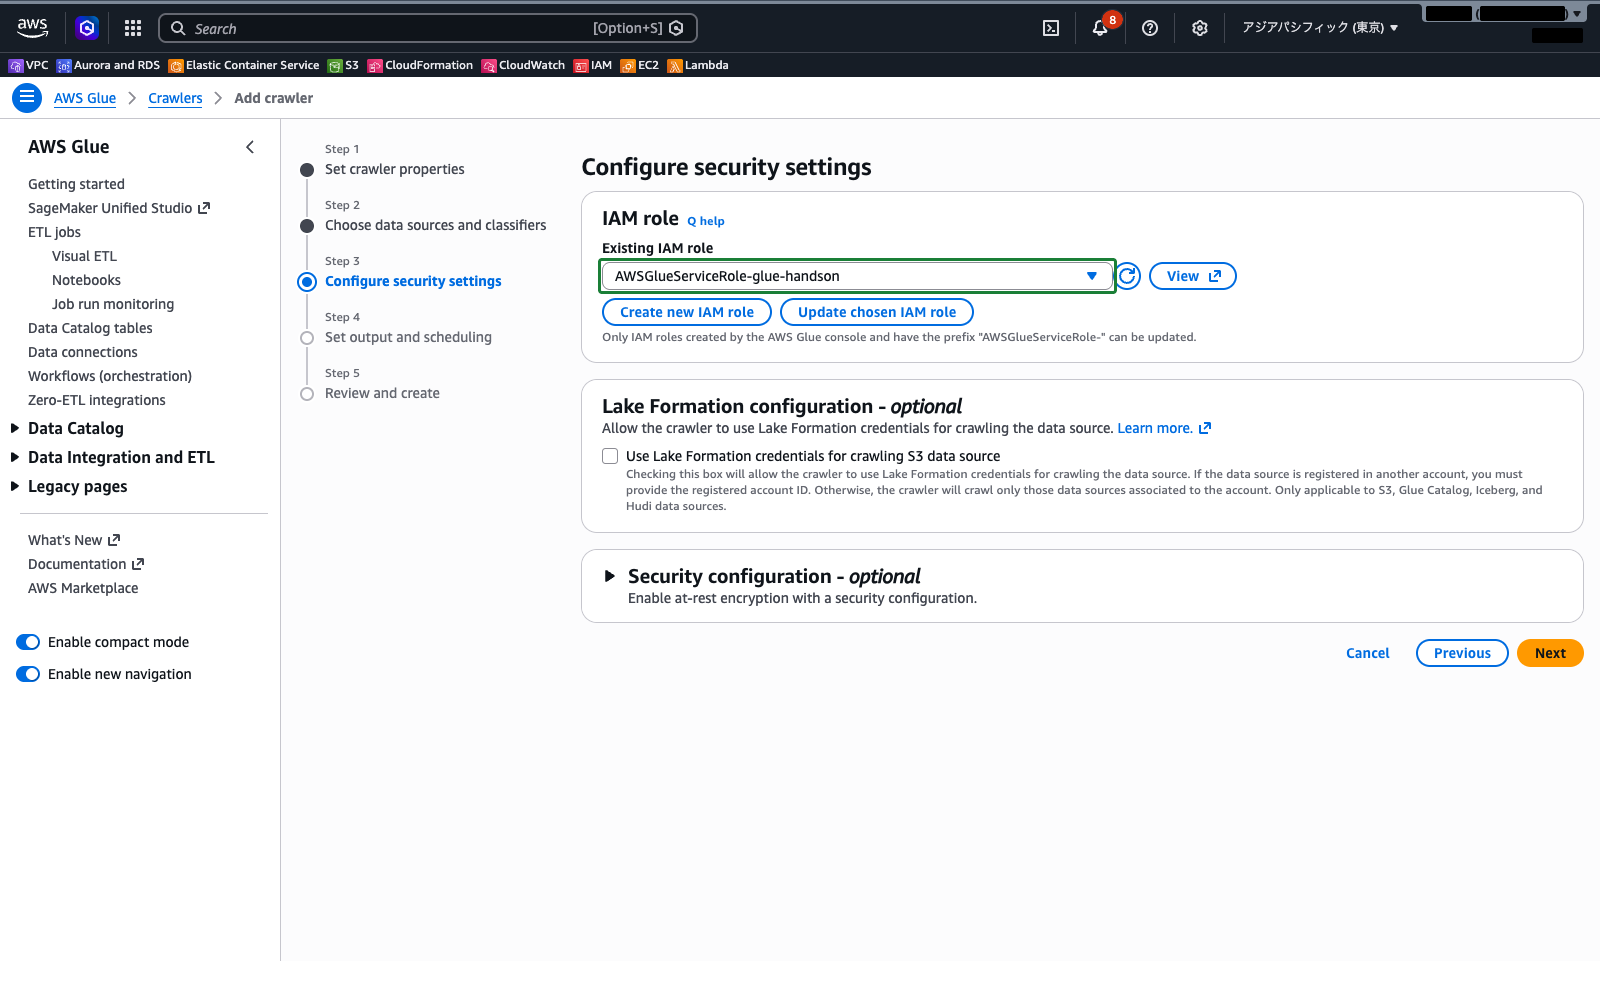
- 「Step 3: Configure security settings」の「IAM role」で、「Create new IAM role」をクリックします
- 表示されたダイアログのロール名の入力欄には
AWSGlueServiceRole-が入っています。その続きにglue-handsonを入力してAWSGlueServiceRole-glue-handsonにし、「Create」をクリックします - 「Existing IAM role」に
AWSGlueServiceRole-glue-handsonが選択されたことを確認し、「Next」をクリックします
コンソールから作成したロールには、AWS 管理ポリシー AWSGlueServiceRole と、指定した S3 パスを読み取るためのカスタマー管理ポリシー(AWSGlueServiceRole-glue-handson-<英数字>-s3Policy)が付与されます。
- 「Step 4: Set output and scheduling」で以下を設定します
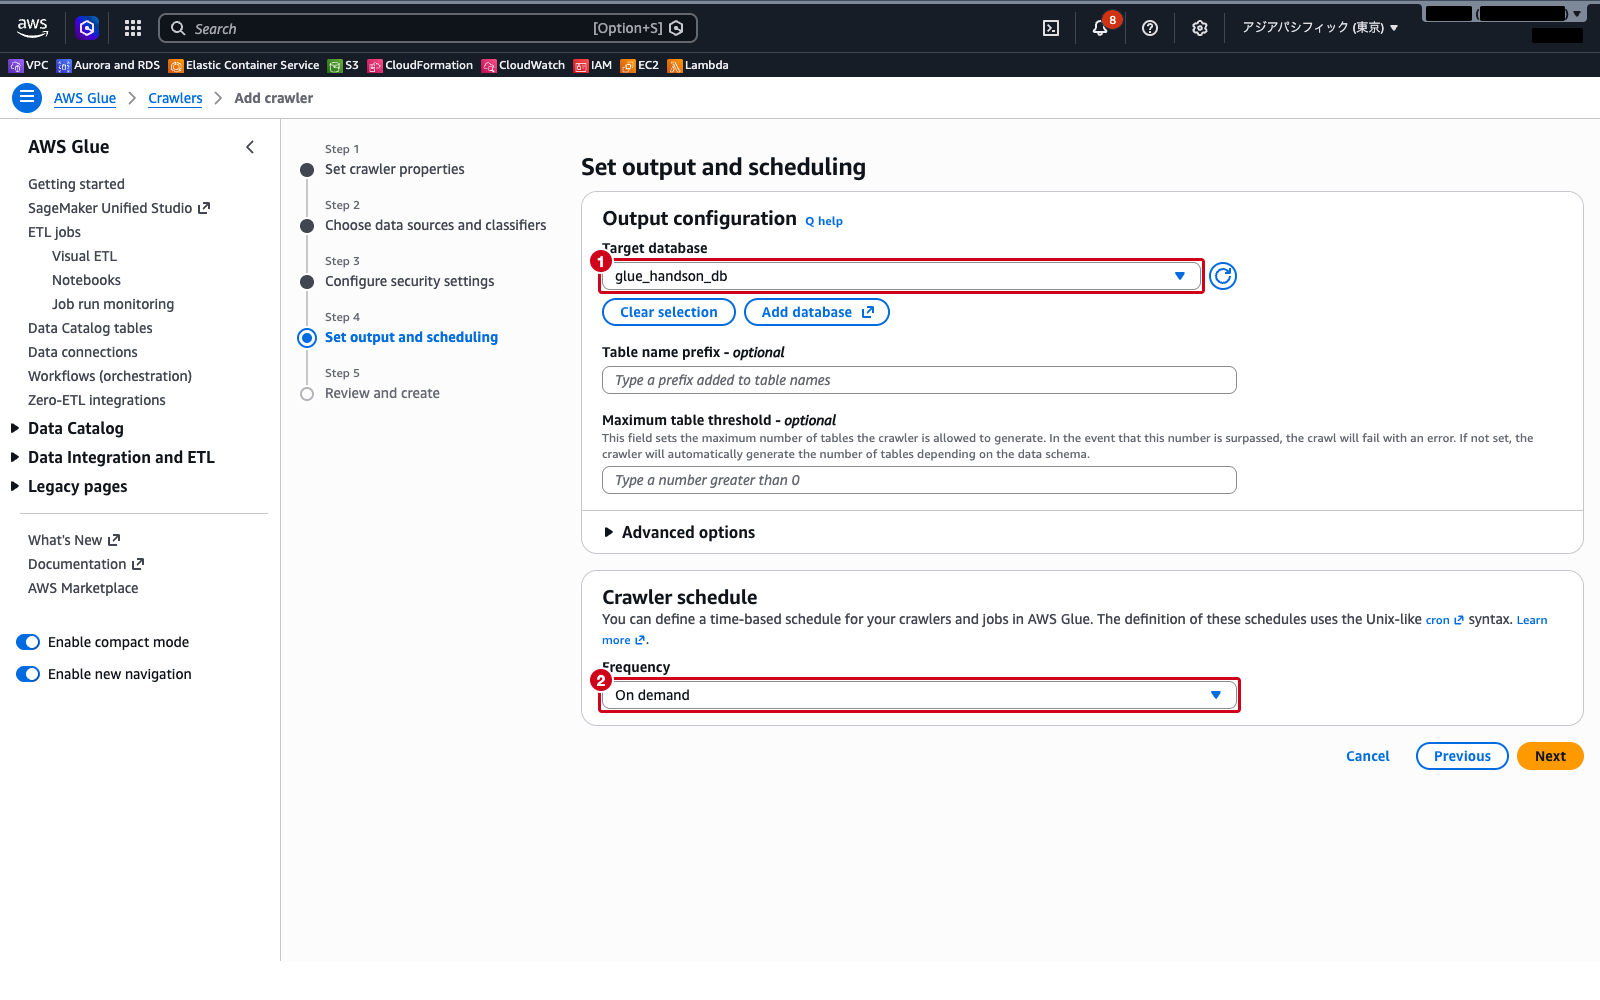
- Target database:
glue_handson_db - Crawler schedule の Frequency:
On demand(デフォルト) - その他の項目はデフォルトのままにし、「Next」をクリックします
- 「Step 5: Review and create」で設定内容を確認し、「Create crawler」をクリックします
クラウドおさるクローラーは動いている時間に対してお代がかかるのでござる。今回はスケジュールを「オンデマンド」にしたので、自分で実行したときだけ動くでござる。頻度を短い間隔の定期実行にしたまま放っておくと、そのたびにバナナが減っていくので気をつけるでござるぞ。
クローラーを実行する
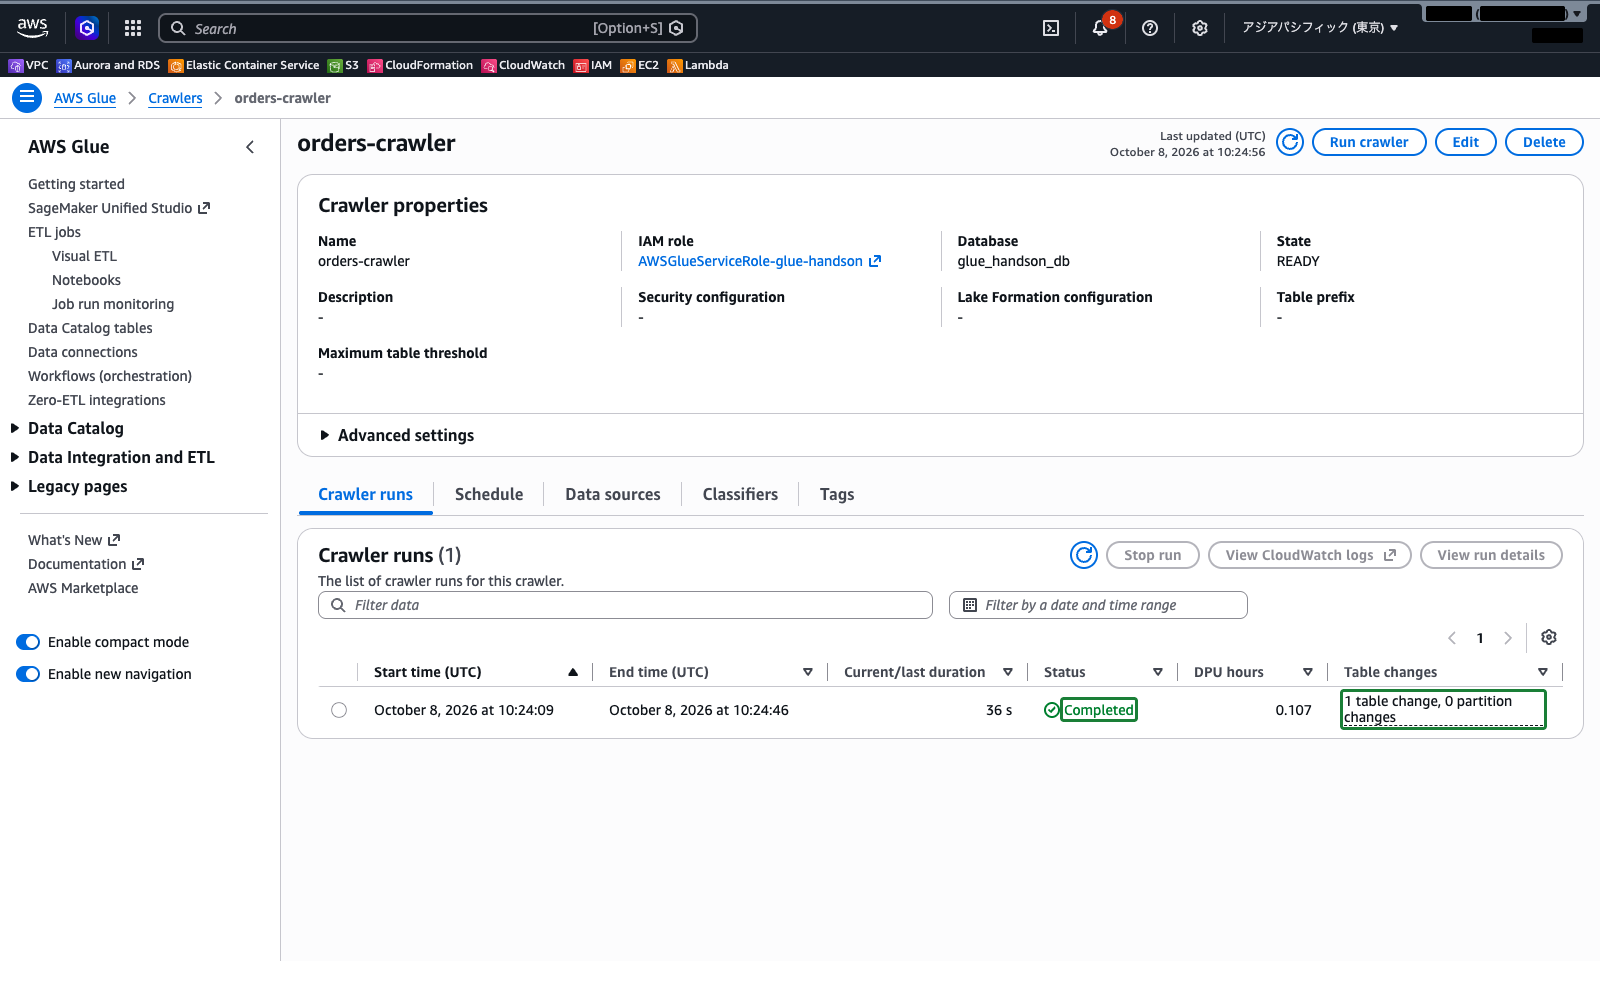
- 作成したクローラー
orders-crawlerの詳細画面で、右上の「Run crawler」をクリックします - 下部の「Crawler runs」タブで、Status が「Completed」になるまで待ちます(今回は 1 分弱でした。料金は最低 10 分ぶんで計算されます。画面右上の更新アイコンで表示を更新できます)
- 実行結果の「Table changes」に「1 table change, 0 partition changes」と表示され、テーブルが 1 つ追加されたことを確認します
データカタログでスキーマを確認する
- 左側ナビゲーションの「Data Catalog」を展開し、「Tables」を選択します
- テーブル一覧に
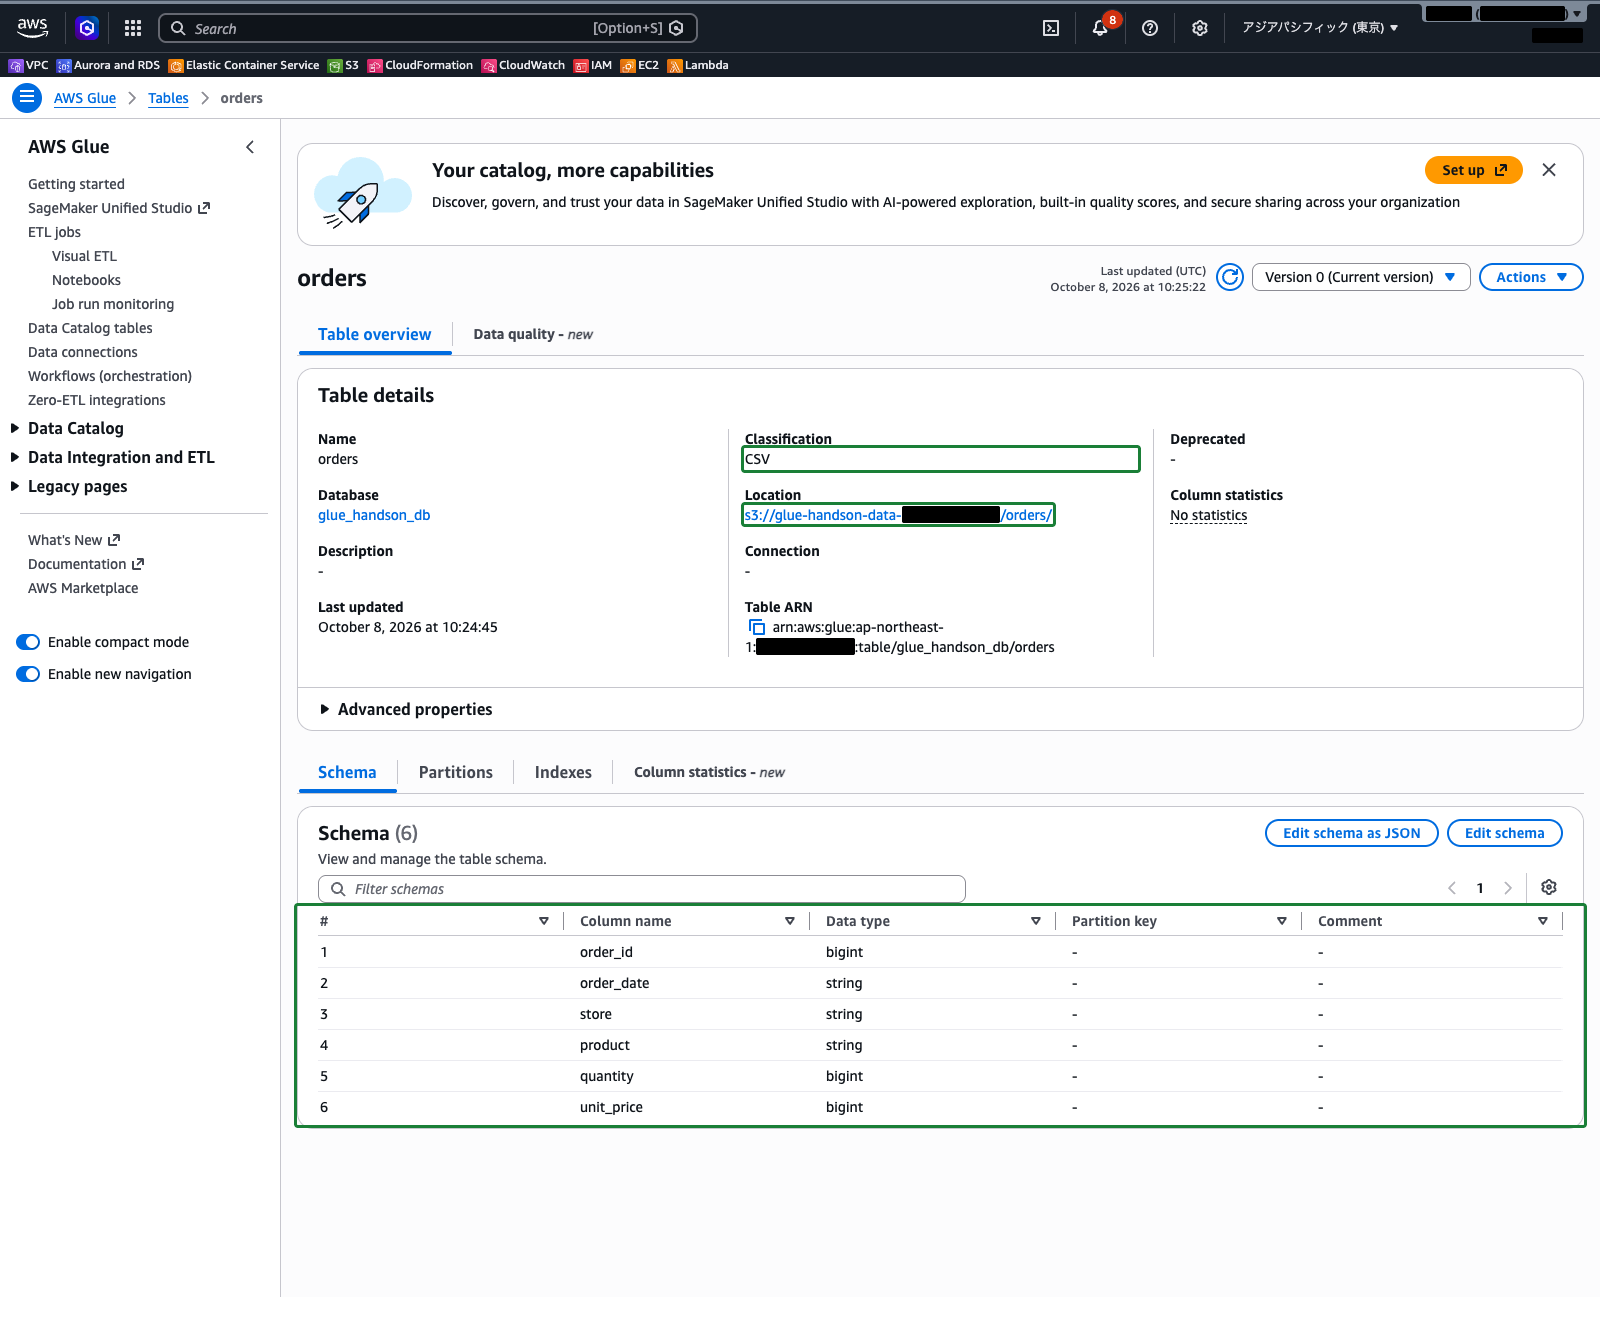
ordersが表示されていることを確認し、ordersをクリックします - 「Table details」で、Database が
glue_handson_db、Location がs3://glue-handson-data-<アカウントID>/orders/、Classification がCSVになっていることを確認します - 下部の「Schema」タブで、CSV の 1 行目の列名(
order_id、order_date、store、product、quantity、unit_price)が列名として登録され、それぞれにデータ型が推測されていることを確認します(今回はorder_id・quantity・unit_priceがbigint、order_date・store・productがstringでした。order_dateは日付に見えますが、date型ではなくstringになります)
テーブル名は、クロール対象にしたフォルダ名 orders から付けられています。列名が col0、col1 のようになっている場合は、1 行目がヘッダーとして判定されていません。CSV の内容を見直してください。
Athena のクエリ結果の保存先を設定する
- 上部の検索バーに
Athenaと入力し、表示された「Athena」を選択します - 初回アクセス時は「クエリエディタを起動」をクリックします
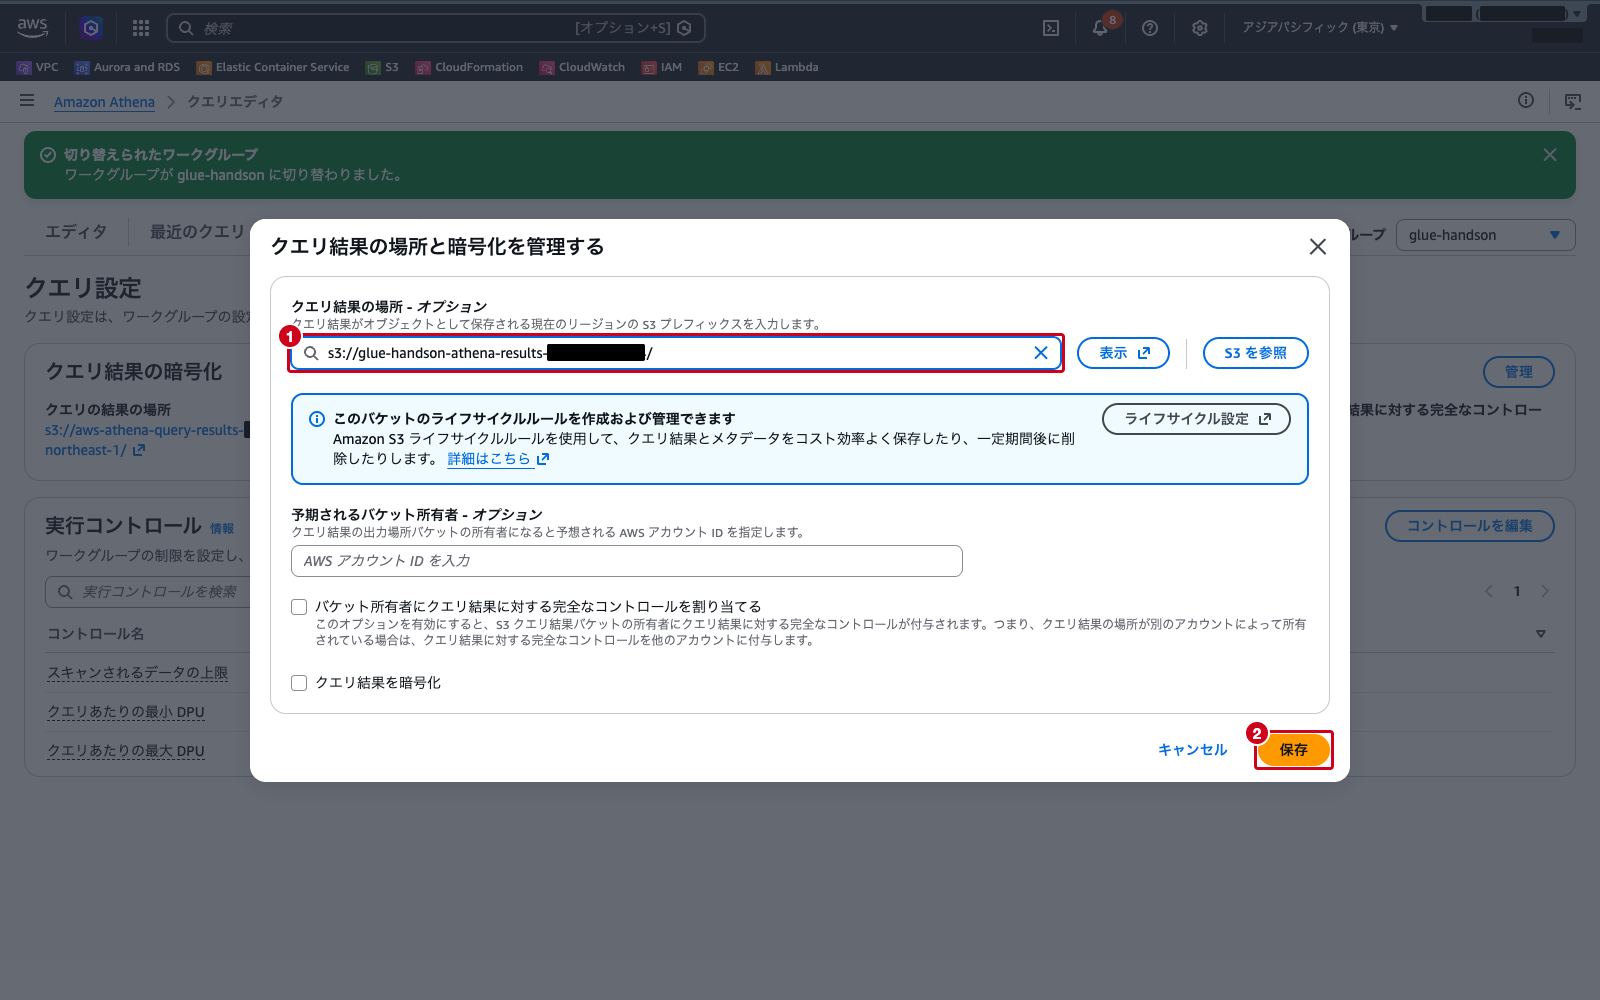
- 上部の「クエリ設定」タブを選択し、「クエリ結果の暗号化」の右にある「管理」をクリックします
- 「クエリ結果の場所」に
s3://glue-handson-athena-results-<アカウントID>/と入力します(「S3 を参照」からバケットを選んでも構いません) - その他の項目はデフォルトのままにし、「保存」をクリックします
Athena でクエリする
- 上部の「エディタ」タブを選択します
- 左側パネルの「データソース」が
AwsDataCatalog、「データベース」がglue_handson_dbになっていることを確認します(違う場合はドロップダウンから選択します) - 「テーブル」に
ordersが表示されていることを確認します
Athena 側で CREATE TABLE を書いていないのに、クローラーが登録したテーブルがそのまま見えています。
- クエリエディタに以下の SQL を入力し、「実行」をクリックします(2 回目以降は同じボタンが「もう一度実行する」と表示されます)
SELECT * FROM orders LIMIT 10;- 結果タブに 8 件のデータが表示され、1 行目のヘッダーがデータとして混ざっていないことを確認します
続けて、店舗別の売上を集計します。
- クエリエディタに以下の SQL を入力し、「実行」をクリックします
SELECT
  store,
  COUNT(*) AS order_count,
  SUM(quantity * unit_price) AS total_sales
FROM orders
GROUP BY store
ORDER BY total_sales DESC;- 結果タブに店舗ごとの注文件数と売上合計が表示されることを確認します
- 「クエリ結果」タブの上部に表示される「スキャンしたデータ」で、このクエリが読み取ったデータ量を確認します
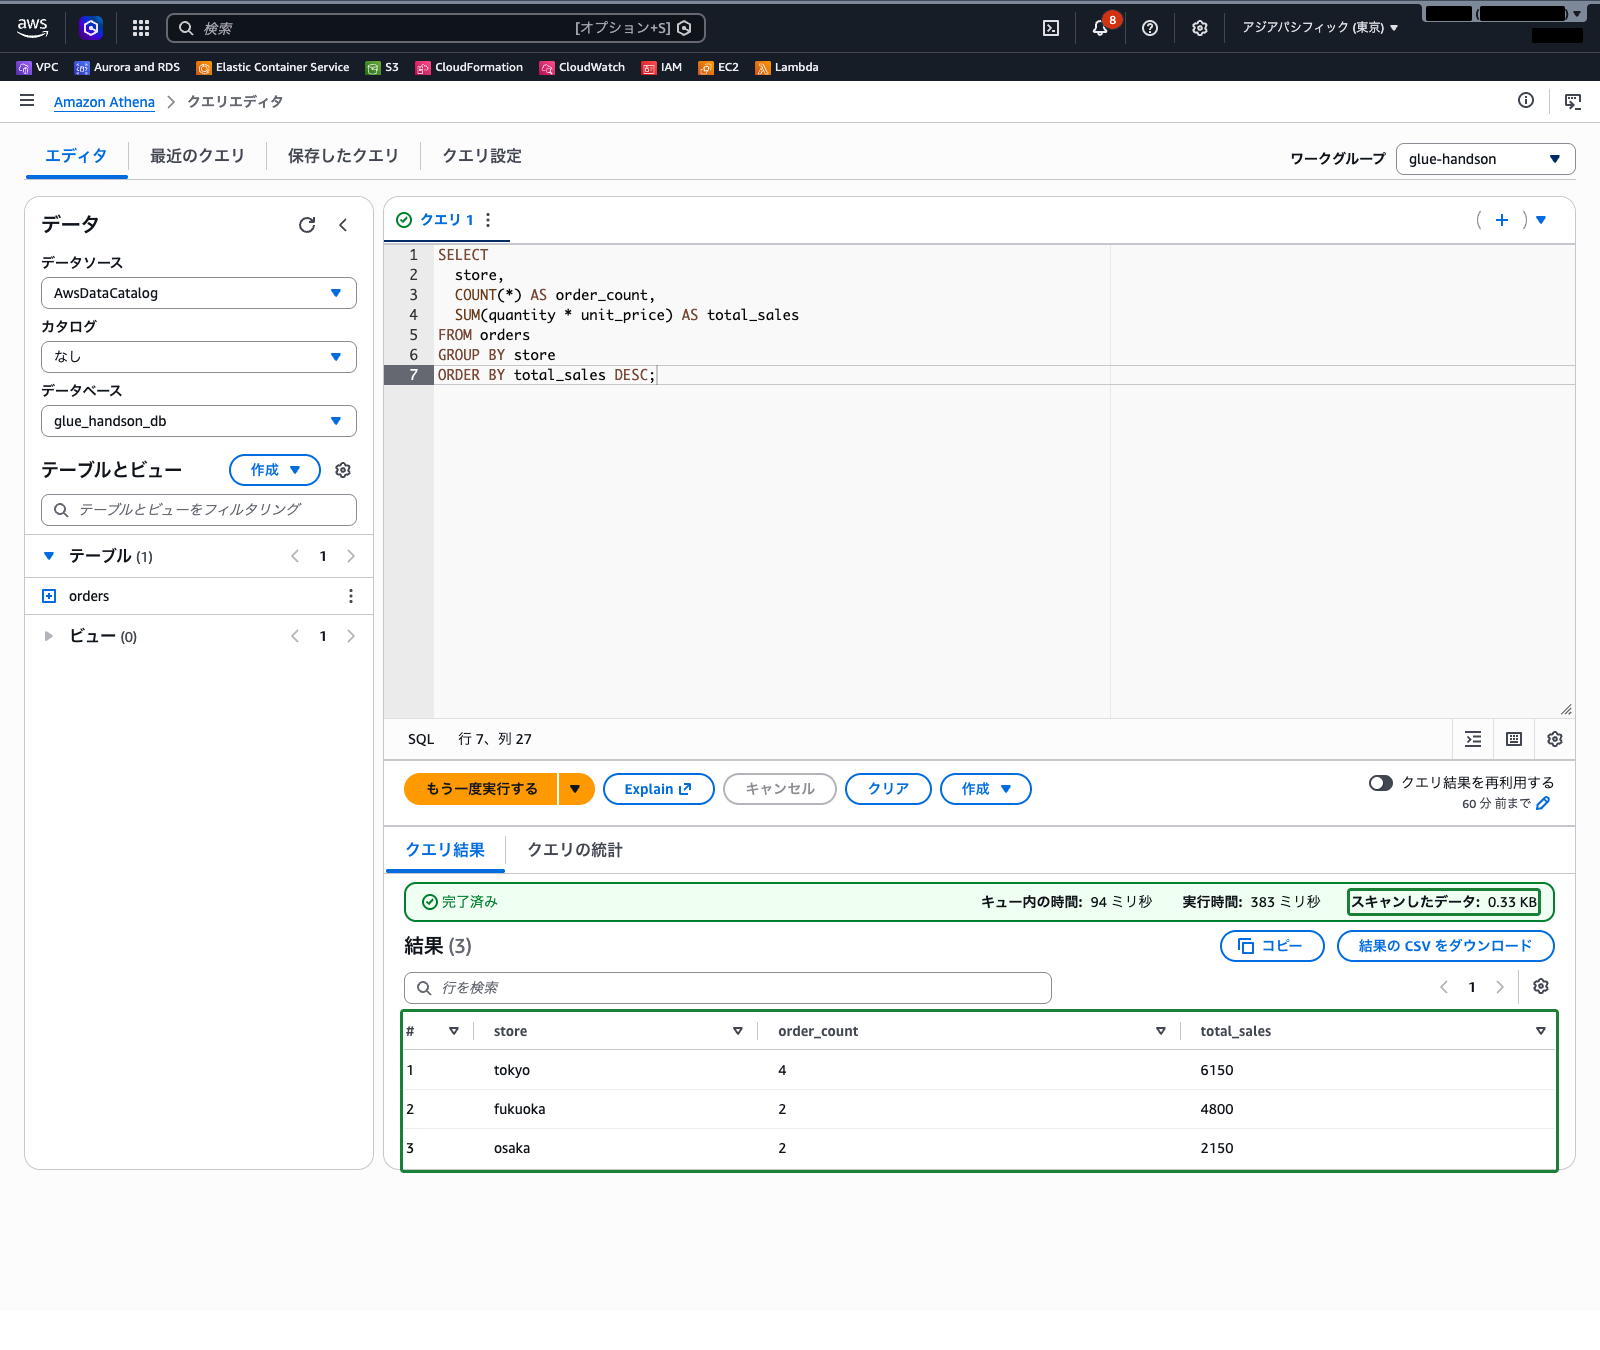
Athena の料金は、クエリがスキャンしたデータ量に応じて決まります。スキャン量はメガバイト単位に切り上げられ、1 クエリあたり最小 10 MB として計算されます。なお、CREATE TABLE などの DDL や失敗したクエリには課金されません。
クラウドおさるAthena はスキャンした量でお代が決まるのでござる。今回の CSV は小さいので気にならぬでござるが、大きなデータに SELECT * を気軽に投げると、倉庫じゅうのバナナを数えさせることになるでござるぞ。
ファイルを追加して再度クエリする
データカタログのテーブルは「orders/ フォルダのデータ」を指しているため、同じ形式のファイルを同じフォルダに追加すれば、クローラーを再実行しなくても Athena の結果に反映されます。
- S3 コンソールで
glue-handson-data-<アカウントID>のordersフォルダを開き、「アップロード」からorders_2026_05.csvをアップロードします - Athena のクエリエディタに戻り、以下の SQL を入力して「実行」(または「もう一度実行する」)をクリックします
SELECT
  substr(CAST(order_date AS varchar), 1, 7) AS order_month,
  COUNT(*) AS order_count
FROM orders
GROUP BY 1
ORDER BY 1;- 結果タブに
2026-04が 8 件、2026-05が 3 件と表示され、追加したファイルの行も集計されていることを確認します
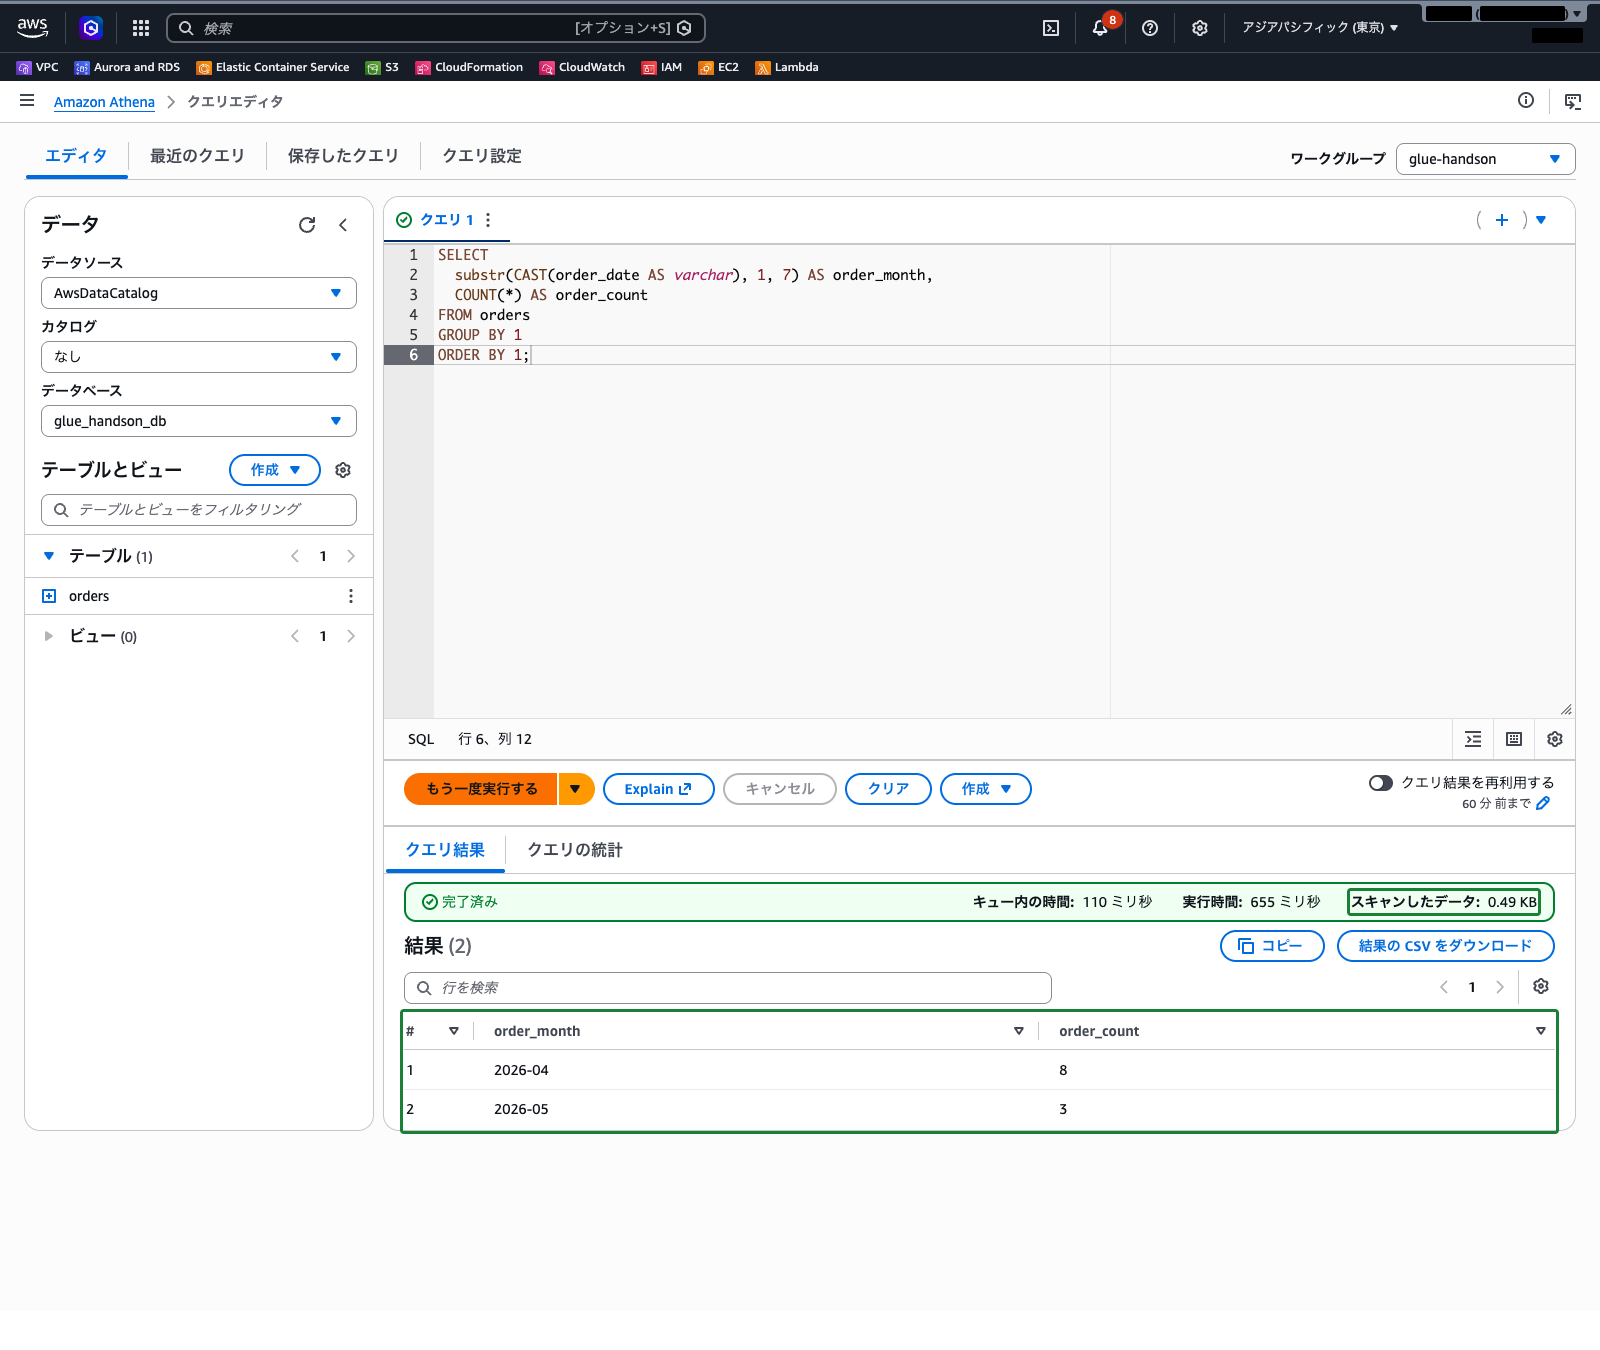
列を増やすなどスキーマが変わる場合や、パーティション(year=2026/ のようなフォルダ分け)を新しく追加した場合は、クローラーを再実行してデータカタログを更新します。
まとめ
- データレイクは、さまざまな形式のデータを S3 に一元的に保存し、カタログ化・保護しながら多様なツールで分析する考え方です
- AWS Glue はサーバーレスのデータ統合サービスで、データカタログ・クローラー・ETL ジョブ・Glue Studio・DataBrew などで構成されます
- データカタログはデータの場所とスキーマというメタデータだけを持ち、実データは S3 に置いたままです
- クローラーは分類子でデータ形式を判定し、スキーマを推測してデータカタログのテーブルを作成・更新します。推測結果はスキーマで確認します
- Athena はデータカタログのテーブル定義を使って S3 のデータにクエリし、Redshift Spectrum も同じカタログを参照できます。アクセス許可を細かく管理するのは Lake Formation です
- クローラーと ETL ジョブは実行時間に対して秒単位で課金され(1 回あたりクローラーは最低 10 分、ETL ジョブは最低 1 分)、ETL ジョブは使用した DPU(1 DPU = 4 vCPU・16 GB メモリ)の数に基づきます。Athena はスキャンしたデータ量で課金されます
参照先
- AWS Glue とは – AWS Glue
- AWS Glue コンポーネント – AWS Glue
- クローラーを使用したデータカタログへの入力 – AWS Glue
- クローラーの設定 – AWS Glue
- ステップ 2: データソースと分類子を選択する – AWS Glue
- ステップ 3: セキュリティ設定を構成する – AWS Glue
- ステップ 4: 出力とスケジュールを設定する – AWS Glue
- チュートリアル: AWS Glue クローラの追加 – AWS Glue
- 分類子の定義と管理 – AWS Glue
- AWS Glue で Spark ジョブに関するジョブプロパティの構成 – AWS Glue
- AWS Glue DataBrew とは – AWS Glue DataBrew
- AWS Lake Formation とは – AWS Lake Formation
- Athena でのテーブル、データベース、およびデータカタログの理解 – Amazon Athena
- Athena コンソールを使用してクエリ結果の場所を指定する – Amazon Athena
- クエリごとおよびワークグループごとのデータ使用量の制御を設定する – Amazon Athena
- Amazon Redshift Spectrum – Amazon Redshift
- Amazon Redshift Spectrum 用の外部スキーマ – Amazon Redshift
- AWS Glue – Big Data Analytics Options on AWS
- Cost optimization in analytics services – Cost Modeling Data Lakes for Beginners
- Amazon Athena – Big Data Analytics Options on AWS
- Storage Best Practices for Data and Analytics Applications