概要
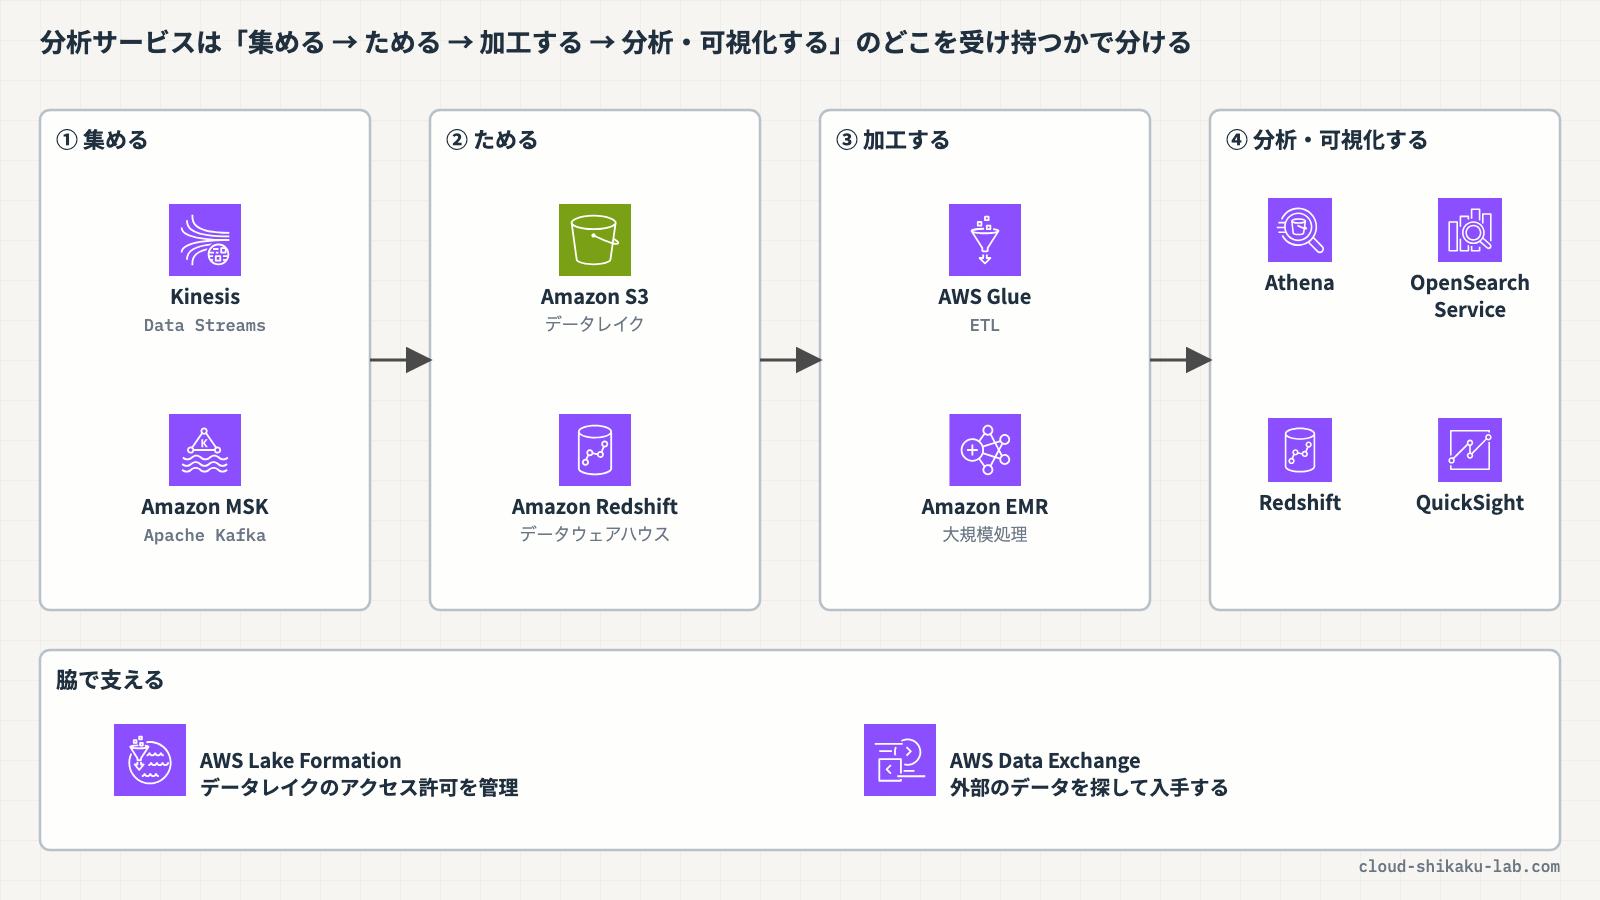
AWS の分析サービスは、Athena・Glue・Kinesis・EMR・OpenSearch Service・Redshift・QuickSight と数が多く、名前だけを並べて覚えようとすると「どれが何をするのか」が混ざりがちです。整理の手がかりになるのは、データが 集める → ためる → 加工する → 分析・可視化する と流れていく中で、そのサービスがどこを受け持つかです。
この記事では、その流れに沿って分析サービスを並べ、特に手を動かしにくいサービスを比較表中心にまとめます。データウェアハウス(Amazon Redshift、Redshift Serverless)とデータレイク(Amazon S3 + AWS Glue + Amazon Athena + AWS Lake Formation)の違い、ストリーミングの Amazon Kinesis と Amazon MSK の使い分け、BI の Amazon QuickSight(現在の名称は Amazon Quick)、データの購入・共有に使う AWS Data Exchange を扱います。
AWS Certified Cloud Practitioner(CLF)の第 3 分野「クラウドテクノロジーとサービス」の分析サービスに当たる内容です。Lake Formation・MSK・Data Exchange は CLF の範囲外ですが、AWS Certified Solutions Architect – Associate(SAA)の範囲に入っているため、名前と役割をあわせて押さえます。
 クラウドおさる
猿山でも、バナナの収穫記録を集めて、倉庫の帳面にためて、長老会向けにグラフにするまでには何匹もの係が関わっているでござる。どの係がどのサービスに当たるのかを確かめるでござる。
—
この記事のメリット
- 分析サービスを「集める・ためる・加工する・分析・可視化する」のどこを受け持つかで整理できます
- データウェアハウス(Redshift)とデータレイク(S3 + Glue + Athena + Lake Formation)の違いを説明できます
- Redshift のプロビジョニングされたクラスターと Redshift Serverless の違いを説明できます
- Kinesis と MSK を、どんな条件で選び分けるかが分かります
- QuickSight と Amazon Quick の名称の関係と、BI サービスの役割を把握できます
- 外部のデータを入手する手段として Data Exchange を挙げられるようになります
—
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
クラウドおさるはじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
 クラウドおさる
基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
分析の流れで分ける
クラウドおさるとひさん、分析のサービスは名前がたくさんあって、どれも「データを分析する」と書いてあるように見えるでござる。何から整理すればよいのでござるか?
 土肥
データが流れていく順番で並べるのがおすすめだよ。まずデータを「集める」、それを「ためる」、使いやすい形に「加工する」、最後に「分析・可視化する」。それぞれのサービスが、この流れのどこを受け持つかを見ていくと混ざりにくくなるんだ。
 クラウドおさる
流れのどこか、でござるか。1 つのサービスが何か所も受け持つことはないのでござる?
土肥いいところに気づいたね! Redshift みたいに「ためる」と「分析する」の両方を受け持つサービスもあるよ。だから「主にどこを担当するか」で見るといいかな。まとめるとこんな感じだよ。
| 流れ | 主なサービス | 役割 |
|---|---|---|
| 集める | Amazon Kinesis Data Streams / Amazon MSK | ストリーミングデータをリアルタイムに取り込む |
| 集める(届ける) | Amazon Data Firehose | ストリーミングデータを S3・Redshift・OpenSearch Service などへ届ける |
| ためる | Amazon S3(データレイク) / Amazon Redshift(データウェアハウス) | 分析の対象になるデータを保存する |
| 加工する | AWS Glue / Amazon EMR | ETL(抽出・変換・ロード)や、Apache Spark などでの大規模処理 |
| 分析する | Amazon Athena / Amazon Redshift / Amazon OpenSearch Service | SQL で集計する、ログを検索・分析する |
| 可視化する | Amazon QuickSight(Amazon Quick) | ダッシュボードを作って共有する |
| 管理・入手する | AWS Lake Formation / AWS Data Exchange | データレイクのアクセス許可を管理する、外部のデータを入手する |
クラウドおさる収穫係が Kinesis、倉庫番が S3 と Redshift、仕分け係が Glue、報告係が QuickSight、ということでござるな!
土肥そうそう、その通り! この記事では、このうち手を動かして試しにくい Redshift・Lake Formation・MSK・QuickSight・Data Exchange を中心に見ていくよ。
データウェアハウスとデータレイクの違い
クラウドおさる「ためる」のところに、Redshift と S3 が並んでいるでござる。どちらもデータをためるなら、同じものではないのでござるか?
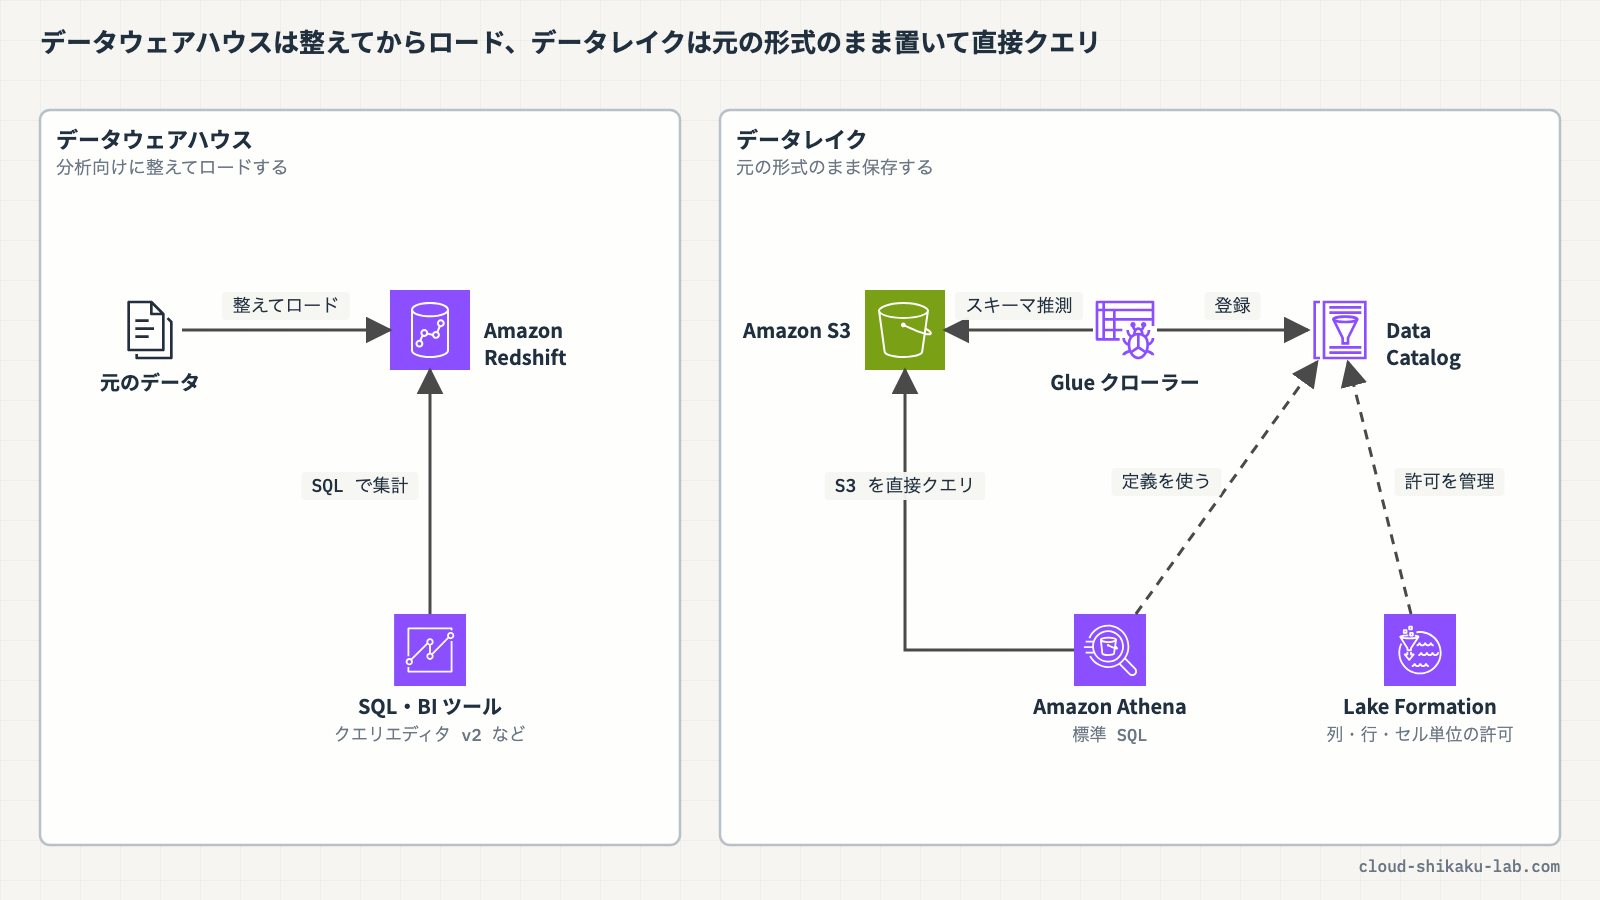
土肥ためる場所という点では同じだけど、ため方が違うんだ。Redshift はデータウェアハウスで、分析しやすいように整えたデータをロードして、SQL で高速に集計する場所。ドキュメントでは「フルマネージド型、ペタバイトスケールのデータウェアハウスサービス」と説明されているよ。
クラウドおさるでは S3 の方は、何と呼ぶのでござる?
土肥S3 を土台にしたものはデータレイクと呼ばれるよ。すべてのデータを元の形式のまま保存しておくリポジトリなんだ。CSV でも JSON でも、まずはそのまま置いておける。そこに AWS Glue のクローラーがスキーマを推測して Data Catalog に登録し、Athena がそのカタログを使って S3 のデータを標準 SQL で直接分析する、という組み合わせになるんだ。
クラウドおさる倉庫に入れる前に箱詰めし直すのが Redshift、収穫したままのカゴを並べておいて、帳面を見て必要なカゴを探すのが S3 と Glue と Athena、でござるか。
土肥うまい例えだね。そのカゴを「誰が開けてよいか」を決めるのが Lake Formation なんだ。S3 上のデータと Glue Data Catalog のメタデータに対して、データベース・テーブル・列のような単位でアクセス許可を付けたり取り消したりできる。列や行、セルの単位まで細かく制御できて、Athena や EMR、Redshift Spectrum から読むときにその許可が効くんだよ。
| 観点 | データウェアハウス | データレイク |
|---|---|---|
| 代表サービス | Amazon Redshift(プロビジョニングされたクラスター / Redshift Serverless) | Amazon S3 + AWS Glue + Amazon Athena + AWS Lake Formation |
| データの持ち方 | 分析向けに整えてロードする | 元の形式のまま保存する |
| 分析の仕方 | Redshift に対して SQL を実行する。クエリエディタ v2 や BI ツールから使う | Glue Data Catalog のテーブル定義を使い、Athena などで S3 のデータを直接クエリする |
| アクセス管理 | Redshift のユーザーと権限 | Lake Formation で Data Catalog のリソースに列・行・セル単位の許可を付ける |
| 料金の考え方 | クラスターの稼働、または Serverless の使用量 | Athena は実行したクエリの分だけ。保存は S3 の料金 |
 クラウドおさる
Redshift の名前の後ろに「Serverless」と付いているのは、何が違うのでござるか?
土肥Redshift には 2 つの使い方があるんだ。ひとつはノードの種類や数を自分で決めるプロビジョニングされたクラスター。もうひとつが Redshift Serverless で、データウェアハウスの容量を自動でプロビジョニングして、負荷に応じて自動でスケーリングしてくれるんだよ。
| 観点 | プロビジョニングされたクラスター | Redshift Serverless |
|---|---|---|
| 容量の管理 | 自分で設定・調整する | 自動でプロビジョニング・スケーリングされる |
| 課金 | クラスターの稼働に対して | 使用したコンピューティング性能(RPU 時間)に対して。アイドル時は課金されない |
| リソースのまとまり | クラスター | 名前空間(データベース・ユーザーなど)とワークグループ(コンピューティングリソース) |
 クラウドおさる
「アイドル時は課金されない」と聞くと、置いておくだけならタダに思えるでござる。でも、開いたままのトランザクションや、接続プールのヘルスチェックのような自動のクエリがあると、使用中とみなされて料金が出るのでござるな。
土肥その通り! Serverless でも「何かが動いている間」は課金の対象になる、というのは押さえておこう。
ストリーミング:Kinesis と MSK
クラウドおさる「集める」のところの Kinesis と MSK は、どちらもストリーミングでござるな。どう選べばよいのでござる?
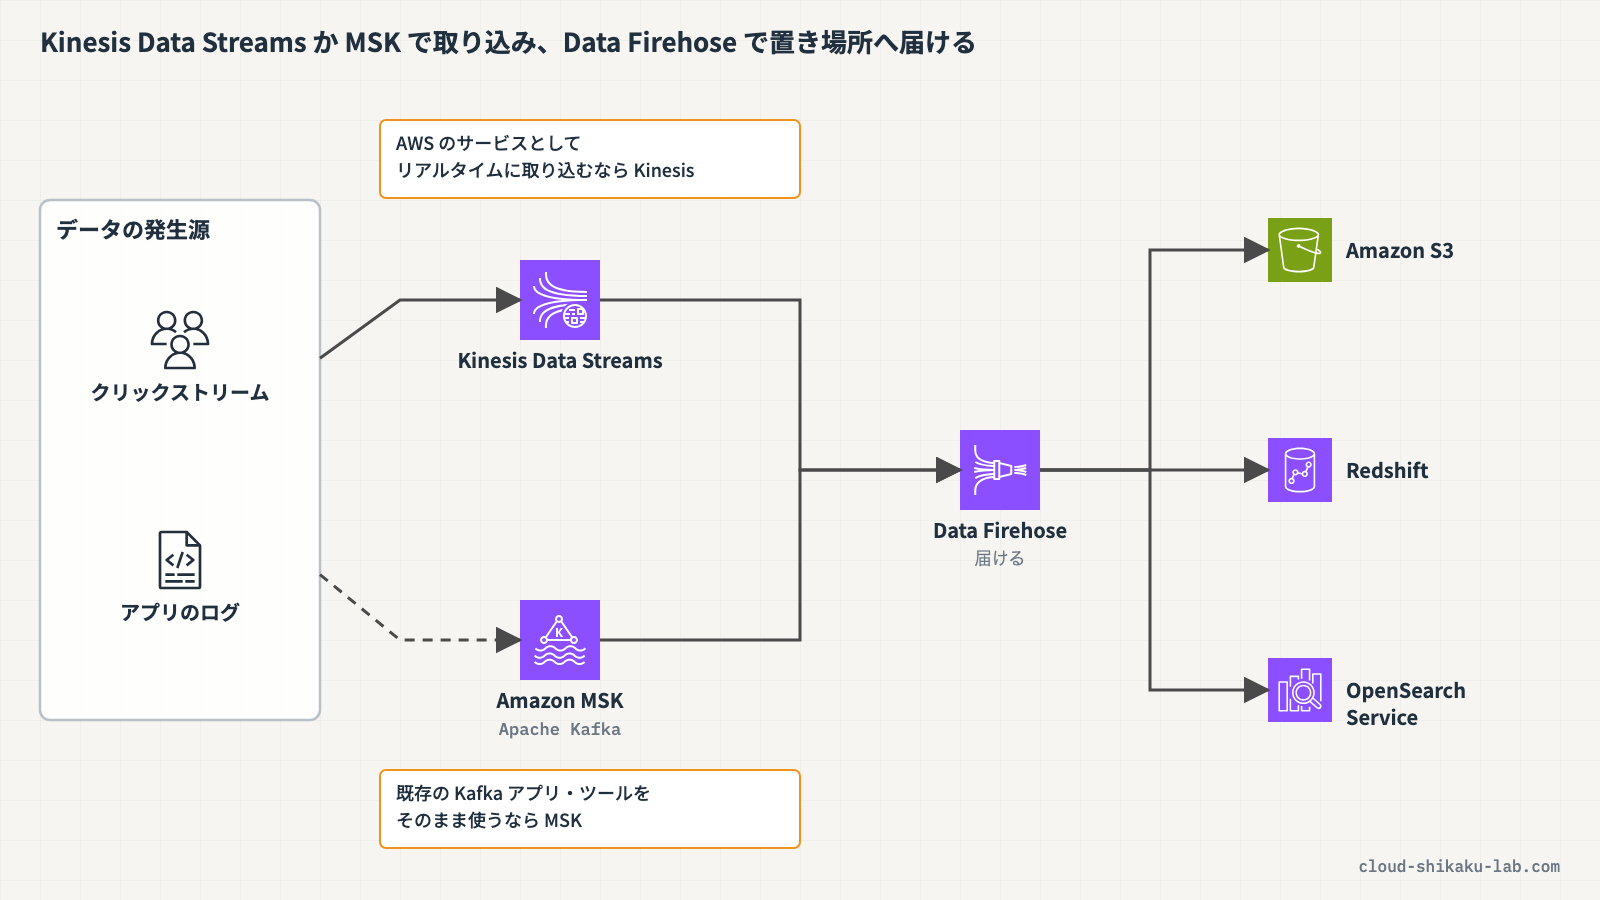
土肥どちらもデータを流れのまま取り込むサービスだけど、出自が違うんだ。Kinesis Data Streams は AWS のサービスで、Web サイトのクリックストリームやログ、金融取引のような大量のデータをリアルタイムに取り込む。入ってから取り出せるまでの遅延は通常 1 秒未満なんだ。
クラウドおさるでは MSK はどうでござるか?
土肥MSK は Amazon Managed Streaming for Apache Kafka の略で、オープンソースの Apache Kafka を AWS がマネージドで動かしてくれるサービスだよ。クラスターの作成・更新・削除といった操作を AWS が受け持ってくれて、中で動いているのはオープンソース版の Kafka だから、既存の Kafka のアプリケーションやツールをコードを変えずに使えるんだ。容量の管理がいらない MSK Serverless もあるよ。
| 観点 | Amazon Kinesis Data Streams | Amazon MSK |
|---|---|---|
| 中身 | AWS 独自のストリーミングサービス | オープンソースの Apache Kafka をマネージドで提供 |
| 選ぶ場面 | AWS のサービスとしてリアルタイムのデータ取り込みを始めたい | すでに Kafka を使っている、Kafka のアプリやツールをそのまま動かしたい |
| 運用 | マネージドサービス | クラスターの作成・更新・削除を AWS が担う。MSK Serverless なら容量管理も不要 |
土肥もうひとつ、名前が似ている Amazon Data Firehose も押さえておこう。こちらは受け取ったストリーミングデータを S3・Redshift・OpenSearch Service などへ届けるのが役目なんだ。
 クラウドおさる
「Kafka」と書いてあれば MSK、AWS で素直にリアルタイム取り込みなら Kinesis、取り込んだものを置き場所まで運ぶなら Firehose、でござるな!
BI:QuickSight と Amazon Quick
クラウドおさる最後の「可視化する」の QuickSight でござるが、SAA の範囲表には「Amazon Quick」と書いてあったでござる。別のサービスでござるか?
土肥そこはややこしいところだね。Amazon Quick は Amazon QuickSight から進化したサービスなんだ。QuickSight の BI 機能は、Quick の中の Amazon Quick Sight という機能として続いているよ。既存の QuickSight の API や SDK、連携も、変更しないでそのまま使えるとドキュメントに書かれているんだ。
クラウドおさる名前が変わっただけで、やることは同じなのでござるか?
土肥BI の部分はそうだね。データソースにつないでダッシュボードを作り、ブラウザやモバイルから見られるように公開する。分析をアプリケーションに埋め込むこともできるよ。CLF の試験ガイドでは「Amazon QuickSight」、SAA の範囲表では「Amazon Quick」と書かれているけど、どちらも同じ BI サービスを指していると考えていい。
| 名称 | 指しているもの |
|---|---|
| Amazon QuickSight | 従来のサービス名。CLF の試験ガイドの表記 |
| Amazon Quick | QuickSight から進化した現在のサービス名。SAA の範囲表の表記 |
| Amazon Quick Sight | Quick の中で、データ可視化と BI を受け持つ機能(従来の QuickSight) |
クラウドおさるQuickSight はサインアップすると 30 日間の無料トライアルが始まるそうでござるが、トライアルが終われば料金の対象でござる。試しに覗くつもりでサインアップしてはいかんでござるな。
土肥そうだね。この記事の実践でも Quick にはサインアップしないよ。
データの購入・共有:Data Exchange
クラウドおさるData Exchange は、流れのどこにも入っていなかったでござる。何をするサービスでござるか?
土肥自分の会社の外にあるデータを手に入れるためのサービスだよ。AWS Marketplace のデータ製品カタログから、サードパーティのデータセットを探してサブスクライブできるんだ。データを売る側(プロバイダー)は、配信や使用権限の仕組みを自前で作らなくても、データを製品として出せる。
クラウドおさる手に入れたデータは、どんな形で届くのでござる?
土肥データセットの種類は、ファイル、API、Amazon Redshift、Amazon S3、AWS Lake Formation(プレビュー)があるよ。たとえばファイルなら S3 にロードして、Athena や Redshift で自分のデータと組み合わせて分析できるんだ。
クラウドおさる隣の山の天気の記録を買ってきて、うちのバナナの収穫量と並べて見るようなものでござるな!
土肥そうそう! ただし有料の製品をサブスクライブすると AWS の請求に載るから、カタログを見るのと、サブスクライブするのは分けて考えよう。
| サービス | 一言でいうと | CLF | SAA |
|---|---|---|---|
| Amazon Redshift | データウェアハウス | 範囲内 | 範囲内 |
| Amazon QuickSight(Amazon Quick) | BI・ダッシュボード | 範囲内 | 範囲内 |
| AWS Lake Formation | データレイクのアクセス許可の一元管理 | ― | 範囲内 |
| Amazon MSK | マネージドな Apache Kafka | 範囲外 | 範囲内 |
| AWS Data Exchange | サードパーティのデータの検索・サブスクライブ | 範囲外 | 範囲内 |
—
実践

課金が発生しない範囲で、Redshift Serverless の作成画面と Data Exchange のカタログを開き、技術解説で整理した内容が画面のどこに表れているかを確認します。この実践ではリソースを作成しません。 Amazon Quick(QuickSight)はサインアップすると無料トライアルが始まり、その後は料金の対象になるため、この実践では開きません。
前提条件
- AWS マネジメントコンソールにログイン済みであること(Amazon Redshift と AWS Data Exchange のコンソールを閲覧できる権限)
- リージョンは
ap-northeast-1(東京)を使用します - 作成するリソースはありません。Redshift Serverless の作成画面の「次へ」、Data Exchange のサブスクリプションなど、作成・購入に進むボタンは押さないでください
手順 1: Redshift Serverless の作成画面を確認する
AWS マネジメントコンソールにログインし、リージョンが ap-northeast-1(東京)であることを確認します。
上部の検索バーに Redshift と入力し、表示された「Amazon Redshift」を選択します。
左側ナビゲーションで「Redshift Serverless」を選択し、サーバーレスダッシュボードの「ワークグループを作成」をクリックします。無料トライアルの対象のアカウントでは、代わりに「Redshift Serverless の無料トライアルをお試しください」の案内が表示されることがあります。
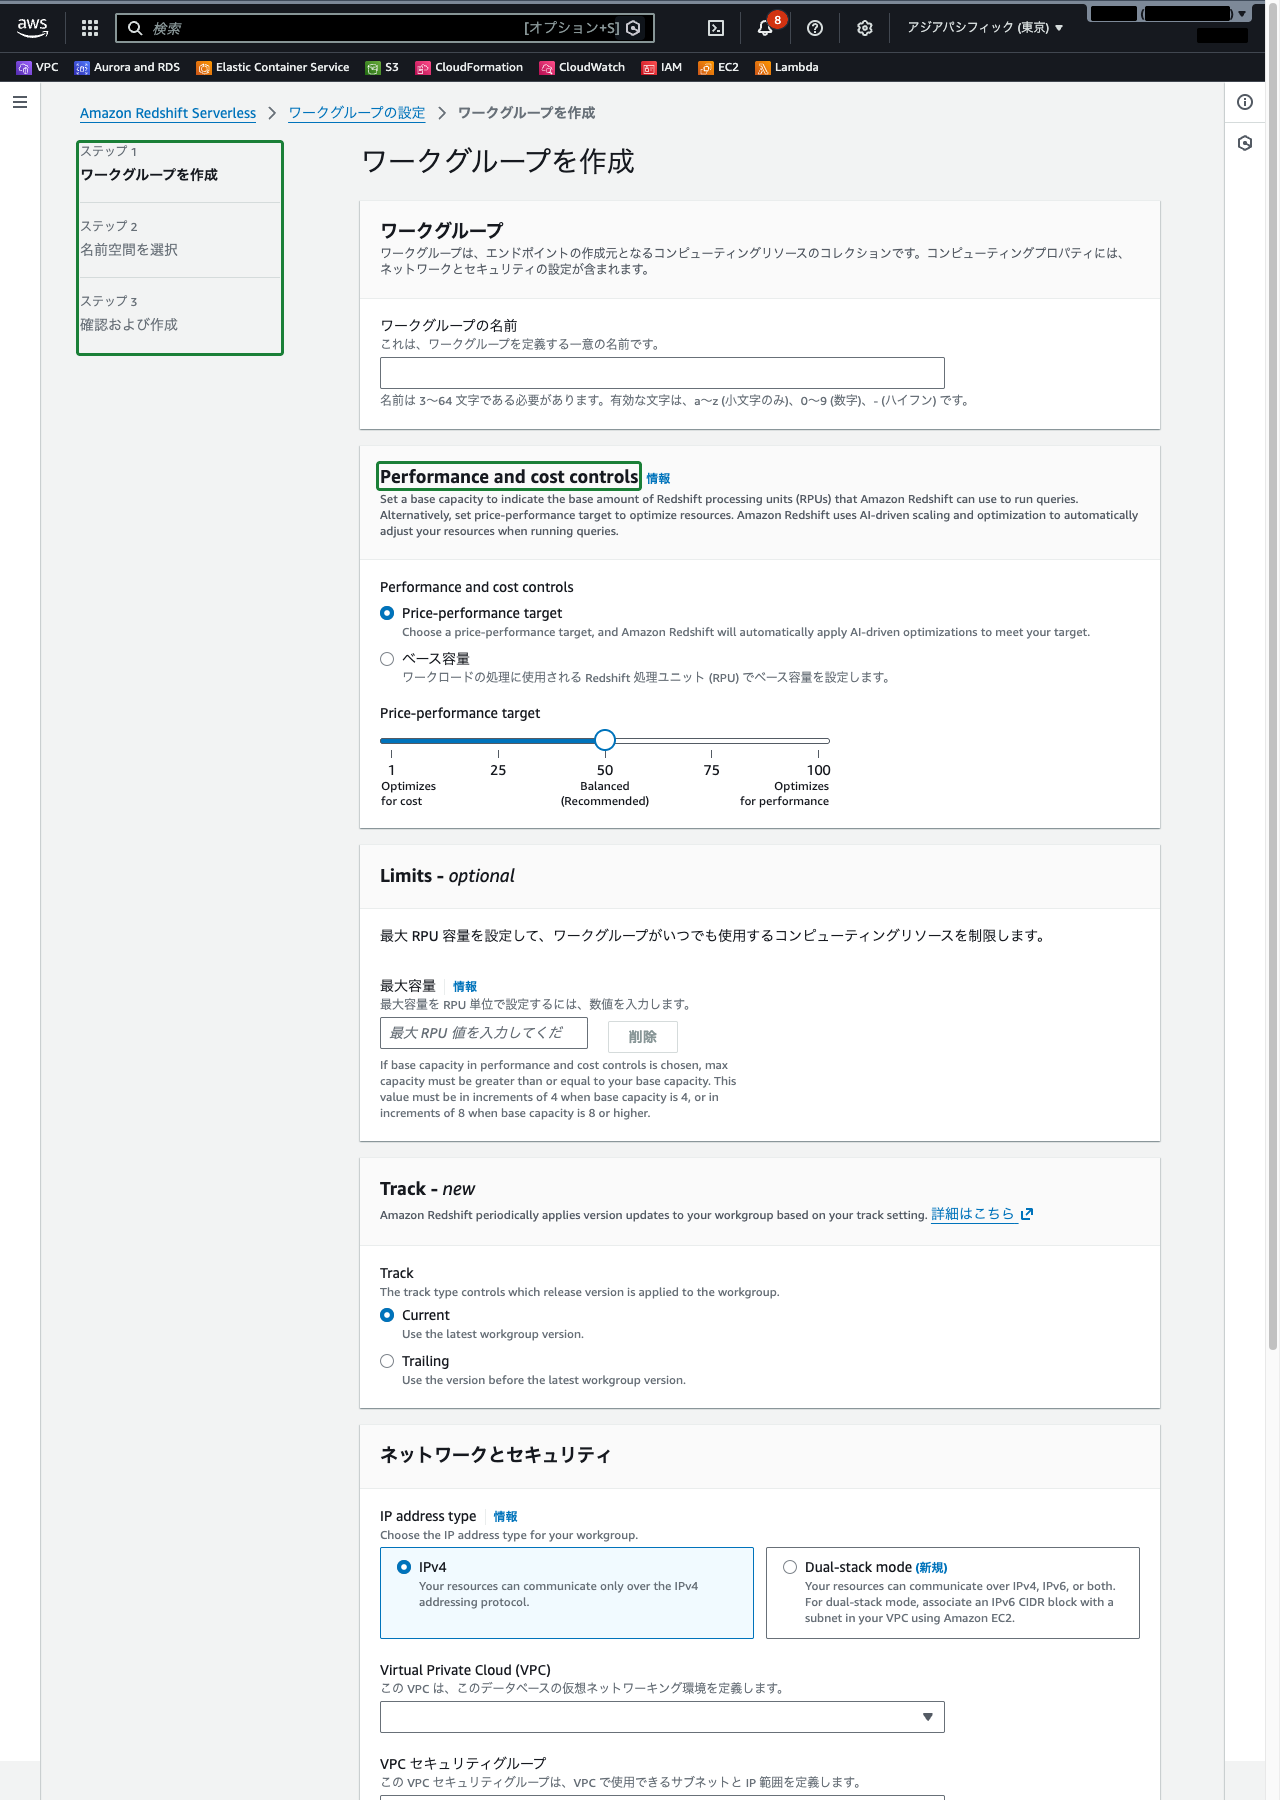
作成画面は「ワークグループを作成」→「名前空間を選択」→「確認および作成」の 3 ステップです。ワークグループ(コンピューティングリソースのまとまり)を決めてから、名前空間(データベースやユーザーのまとまり)を選ぶ流れになっています。
ステップ 1 の「Performance and cost controls」では、Price-performance target(コスト重視から性能重視までのスライダー)か ベース容量(Redshift 処理ユニット=RPU の量)のどちらかを選びます。ノードの種類や台数を選ぶ欄がないことが、「容量を自動でプロビジョニングする」という Serverless の特徴に対応しています。
確認が済んだら、ワークグループの名前などは入力せず、「次へ」も押さずに、ブラウザでこのページを離れます。
クラウドおさる作成画面にはノードを選ぶ欄がなく、決めるのはワークグループと名前空間、それにコストと性能のどちらに寄せるかだけでござった。容量の心配を AWS に預けるのが Serverless でござるな。
手順 2: Data Exchange のカタログを眺める
上部の検索バーに Data Exchange と入力し、表示された「AWS Data Exchange」を選択します。
左側ナビゲーションの「AWS Marketplace でサブスクライブ済み」→「製品カタログ」を選択します。
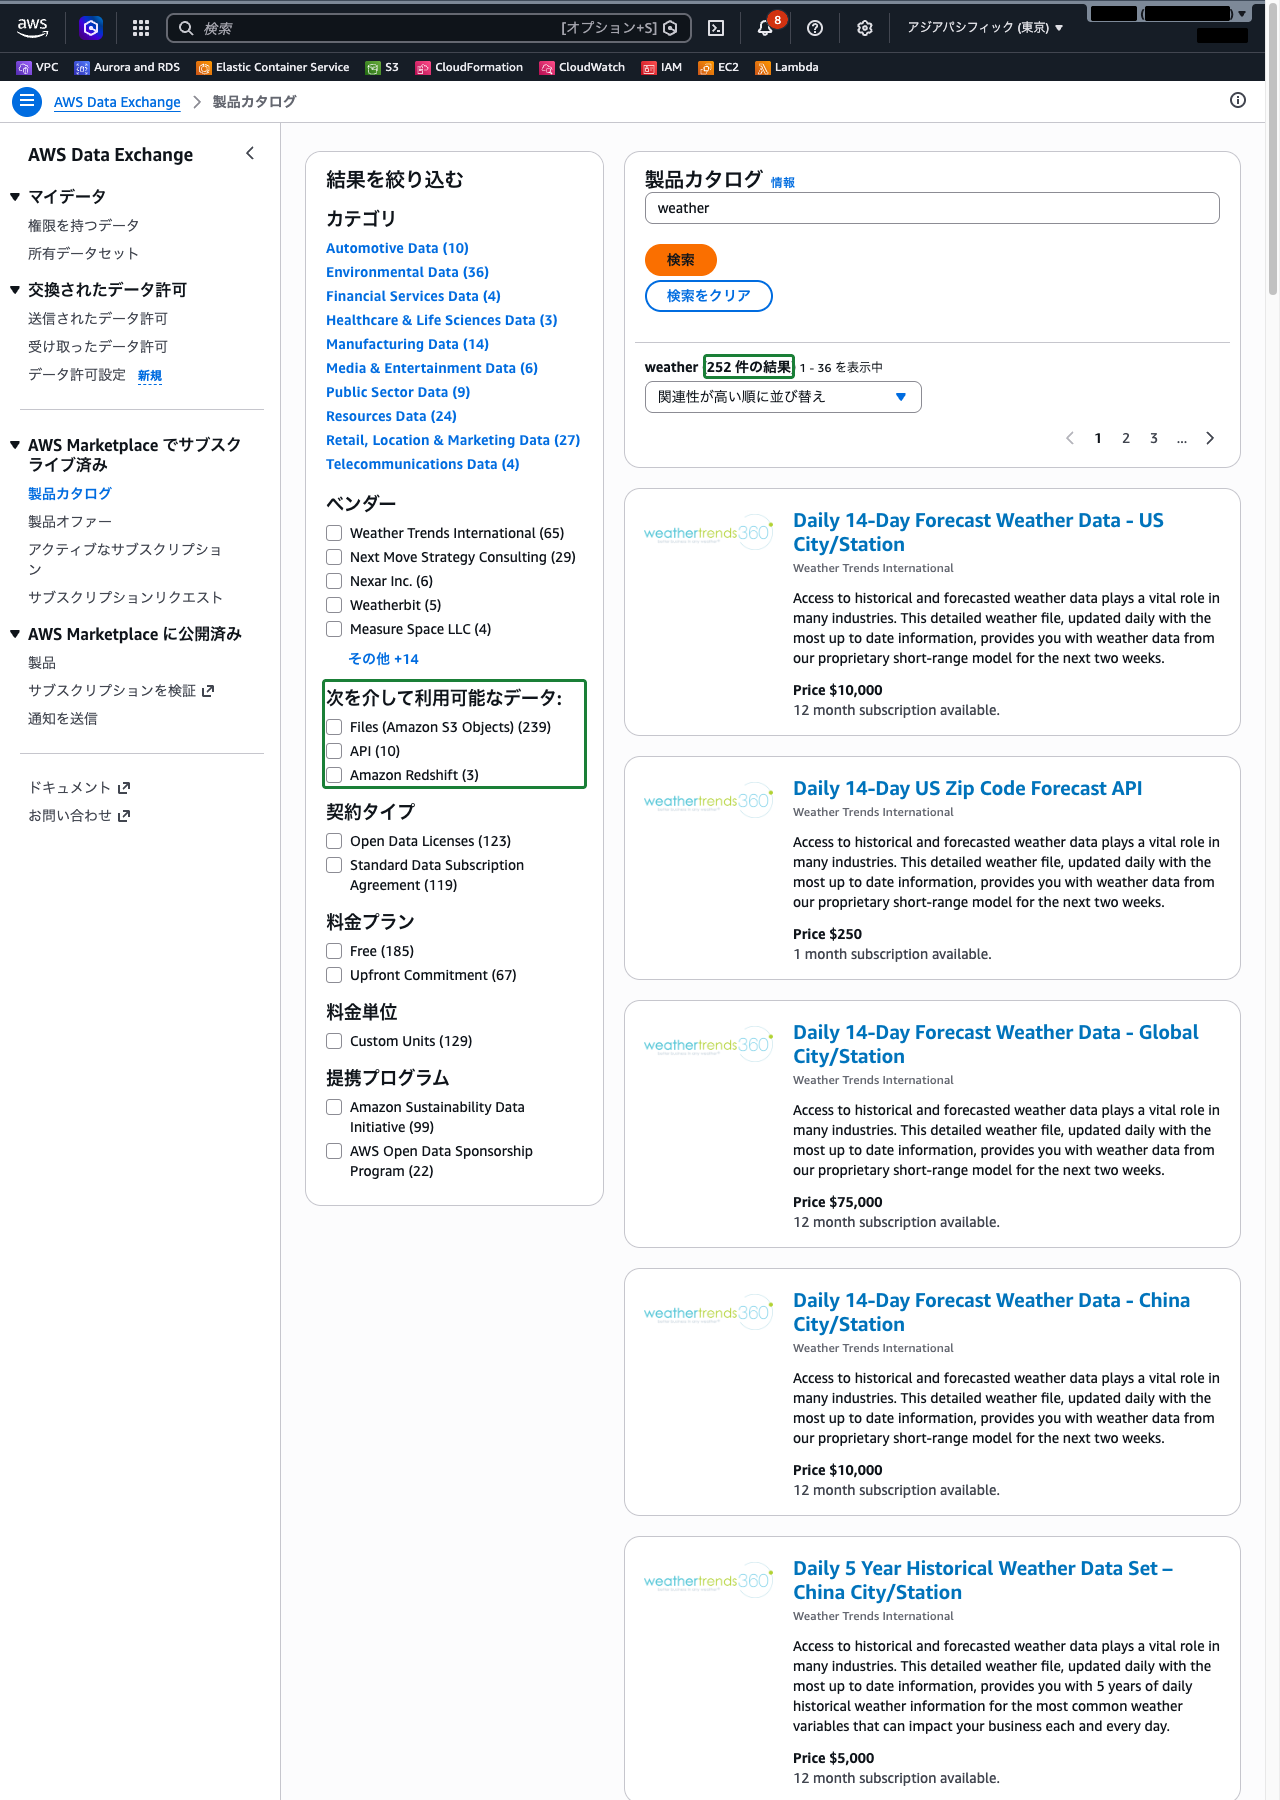
「製品カタログ」の検索欄に weather と入力し、「検索」をクリックします(Enter キーでは検索されません)。
左側の「結果を絞り込む」で「次を介して利用可能なデータ」の項目を確認します。技術解説で触れたデータセットの種類のうち、検索結果に含まれるもの(Files (Amazon S3 Objects)、API、Amazon Redshift など)が件数とともに並びます。検索語によっては、Amazon S3 へのアクセスや AWS Lake Formation も表示されます。
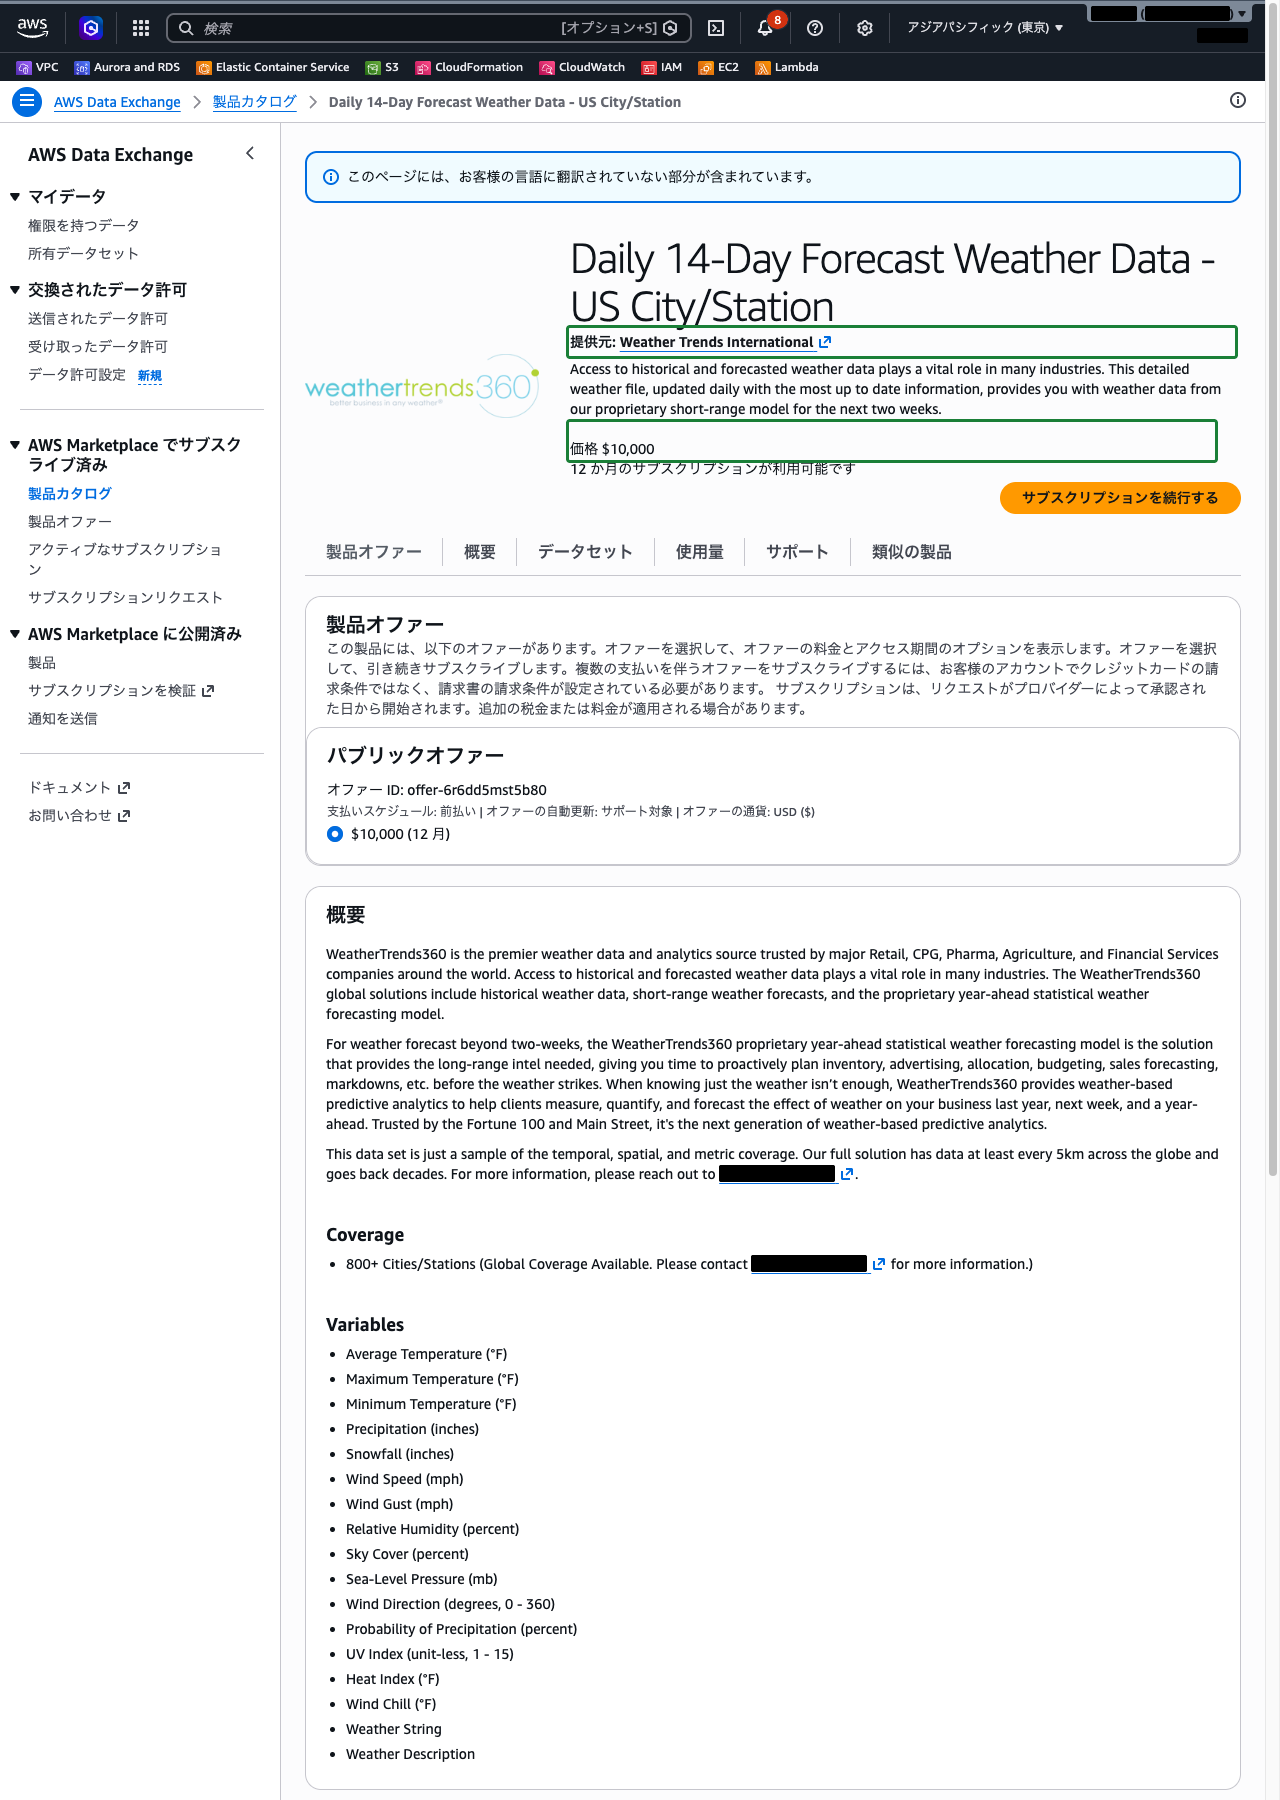
一覧から任意の製品を 1 つ選択し、製品の詳細ページを開きます。提供元、価格、データの説明を確認します。詳細ページには「製品オファー」「概要」「データセット」などのタブがあり、製品によってはサブスクリプションの前にデータの項目やサンプルを確認できます。
確認が済んだら、「サブスクリプションを続行する」は押さずに、ブラウザでこのページを離れます。
クラウドおさるカタログを眺めるだけなら弊猿のバナナは減らないでござる。サブスクライブのボタンを押したところから請求に載るのでござるな。
クラウドおさる試験では「生のまま S3 にためて SQL で直接分析したい」「既存の Kafka をそのまま動かしたい」「外部のデータを買って分析に使いたい」のように、要件の言葉からサービスを選ばせる観点が多いでござる。Kinesis と MSK、Redshift と Athena の取り違えには気をつけるでござる。
—
まとめ
| 要件の手がかり | 選ぶサービス |
|---|---|
| ストリーミングデータをリアルタイムに取り込みたい | Amazon Kinesis Data Streams |
| 既存の Apache Kafka のアプリやツールをそのまま動かしたい | Amazon MSK |
| ストリーミングデータを S3・Redshift などへ届けたい | Amazon Data Firehose |
| 整えたデータを SQL で高速に集計したい(データウェアハウス) | Amazon Redshift |
| データウェアハウスの容量管理をしたくない | Amazon Redshift Serverless |
| S3 のデータを元の形式のまま SQL で分析したい | Amazon Athena(+ AWS Glue Data Catalog) |
| データレイクのアクセス許可を列・行・セル単位で一元管理したい | AWS Lake Formation |
| ダッシュボードを作って共有したい(BI) | Amazon QuickSight(Amazon Quick) |
| サードパーティのデータを探して使いたい | AWS Data Exchange |
- 分析サービスは「集める → ためる → 加工する → 分析・可視化する」のどこを受け持つかで整理する
- データウェアハウス(Redshift)は整えたデータをロードして集計し、データレイク(S3)は元の形式のまま保存して Glue と Athena で直接クエリする。データレイクのアクセス許可は Lake Formation で管理する
- Redshift Serverless は容量を自動で調整し、使用した RPU 時間に対して課金される
- Kinesis は AWS 独自のストリーミング、MSK はマネージドな Apache Kafka
- Amazon Quick は QuickSight から進化した名称で、BI の機能は Amazon Quick Sight として続いている
手を動かして試せるサービスは、Amazon Athena で S3 上のデータをSQLクエリで分析する と Amazon OpenSearch Service で全文検索とログ分析を体験する で扱っています。
—
参照先
- 分析 – Amazon Web Services の概要
- Amazon Redshift とは – Amazon Redshift
- Amazon Redshift Serverless とは – Amazon Redshift
- Amazon Redshift Serverless での請求 – Amazon Redshift
- Amazon Redshift Serverless データウェアハウスの使用を開始 – Amazon Redshift
- Amazon Athena とは – Amazon Athena
- AWS Glue とは – AWS Glue
- AWS Lake Formation とは – AWS Lake Formation
- AWS Lake Formation: 仕組み – AWS Lake Formation
- Amazon Kinesis Data Streams とは – Amazon Kinesis Data Streams
- Amazon MSK デベロッパーガイドへようこそ – Amazon Managed Streaming for Apache Kafka
- Amazon Quick とは – Amazon Quick
- AWS コンソールからサインアップする – Amazon Quick
- AWS Data Exchange とは – AWS Data Exchange ユーザーガイド
- AWS Data Exchange でのサブスクライバーとしての開始方法 – AWS Data Exchange ユーザーガイド
- AWS Data Exchange のデータ製品のサブスクライブ – AWS Data Exchange ユーザーガイド