概要
AWS X-Ray は、アプリケーションが処理するリクエストのデータを収集し、そのデータを表示・フィルタリングして、問題や最適化の機会を見つけるためのサービスです。トレースされたリクエストについては、リクエストとレスポンスだけでなく、アプリケーションが呼び出した AWS リソースやマイクロサービス、データベース、Web API の呼び出しの詳細まで確認できます。
Lambda 関数が「遅い」と分かっても、CloudWatch のメトリクスで見えるのは関数全体の実行時間です。関数の中で時間がかかっているのが自分のコードなのか、S3 などの別サービスの呼び出しなのかは、メトリクスだけでは切り分けられません。X-Ray のトレースを使うと、1 回のリクエストの中身を区間ごとのタイムラインで確認でき、どこで時間を使っているかが一目で分かります。
本記事では、分散トレーシングの考え方と、X-Ray の基本概念(トレース・セグメント・サブセグメント・トレースマップ・サンプリング)、CloudWatch のメトリクス・ログとの違い、X-Ray SDK のメンテナンスモードと OpenTelemetry への移行の案内を整理します。そのうえで、わざと遅い処理と S3 への書き込みを入れた Lambda 関数(Python)でトレースを有効にし、CloudWatch コンソールのトレースのタイムラインから遅い区間を特定します。
 クラウドおさる
今回は、猿山の伝令が遅いときに「どこで道草を食っているか」を突き止める道具を試すのでござる。全体の所要時間ではなく、区間ごとの時間を見られるのが X-Ray の持ち味らしいでござるな。
この記事のメリット
- 分散トレーシングとは何か、なぜメトリクスやログだけでは足りないのかを理解できる
- X-Ray のトレース・セグメント・サブセグメント・トレースマップ・サンプリングの関係を把握できる
- CloudWatch のメトリクス・ログと X-Ray のトレースの使い分けを整理できる
- X-Ray SDK のメンテナンスモードと、OpenTelemetry への移行が推奨されていることを把握できる
- Lambda 関数でトレースを有効にし、CloudWatch コンソールのセグメントのタイムラインから遅い区間を特定する手順を体験できる
執筆者とキャラクター紹介
執筆者:土肥(とひ)
株式会社ジェニュインの代表であり元エンジニア。これまでオンプレミスと AWS 環境のインフラ業務を担当。AWS 認定資格の学習で得た知識を、ハンズオンとともに解説するのが得意。直近では新人の教育も行っており、これから技術を学ぶ方が納得できる解説を心がけています。基礎編・Cloud Practitioner の記事では、解説役としても登場します。

クラウドおさる
 クラウドおさる
はじめましてでござる。弊猿はクラウドおさる。IT インフラが異常に発達した猿山から、雲に乗って地上の AWS を学びに降りてきたのでござる。
クラウドおさる基礎編や Cloud Practitioner の記事では、とひさんに素朴な疑問をぶつける役でござるな。Security - Specialty などの記事では、要所でワンポイントや注意点をひとこと添えるでござる。
 クラウドおさる
猿山にもデータセンターや監視当番があって、地上で起きることはだいたい猿山にも同じ仕組みがあるのでござる。例え話がつい猿山に寄るのは、弊猿の癖でござる。
技術解説
分散トレーシングと AWS X-Ray
クラウドおさるとひさん、X-Ray は「分散トレーシング」のサービスと聞いたでござるが、分散トレーシングとは何でござるか?
 土肥
1 つのリクエストが、いくつものサービスをまたいで処理される様子を、最初から最後まで追いかける仕組みのことだよ。たとえば「API Gateway が Lambda を呼んで、Lambda が S3 や DynamoDB を呼ぶ」みたいな構成だと、1 回のリクエストの中で何か所も処理が走るよね。
 クラウドおさる
たしかに、どこか 1 か所が遅いだけで全体が遅くなりそうでござる。
土肥そうなんだ。X-Ray はアプリケーションが処理するリクエストのデータを集めて、リクエストとレスポンスだけでなく、途中で呼び出した AWS リソースやデータベース、Web API の呼び出しの詳細まで見せてくれるんだ。どの区間でどれだけ時間がかかったか、どこでエラーが出たかを 1 本の流れとして確認できるよ。
クラウドおさる猿山の伝令で言えば、見張り台から長老の家まで手紙が届くあいだに、どの中継所で何分かかったかを全部記録しておくようなものでござるな!
土肥いい例えだね!中継所ごとの記録をつなぎ合わせて、1 通の手紙の旅として見られるのが分散トレーシングなんだ。
トレース・セグメント・サブセグメント
クラウドおさるその「中継所ごとの記録」は、X-Ray ではどう呼ぶのでござるか?
土肥3 つの用語を押さえよう。
| 用語 | 説明 | 伝令の例えでいうと |
|---|---|---|
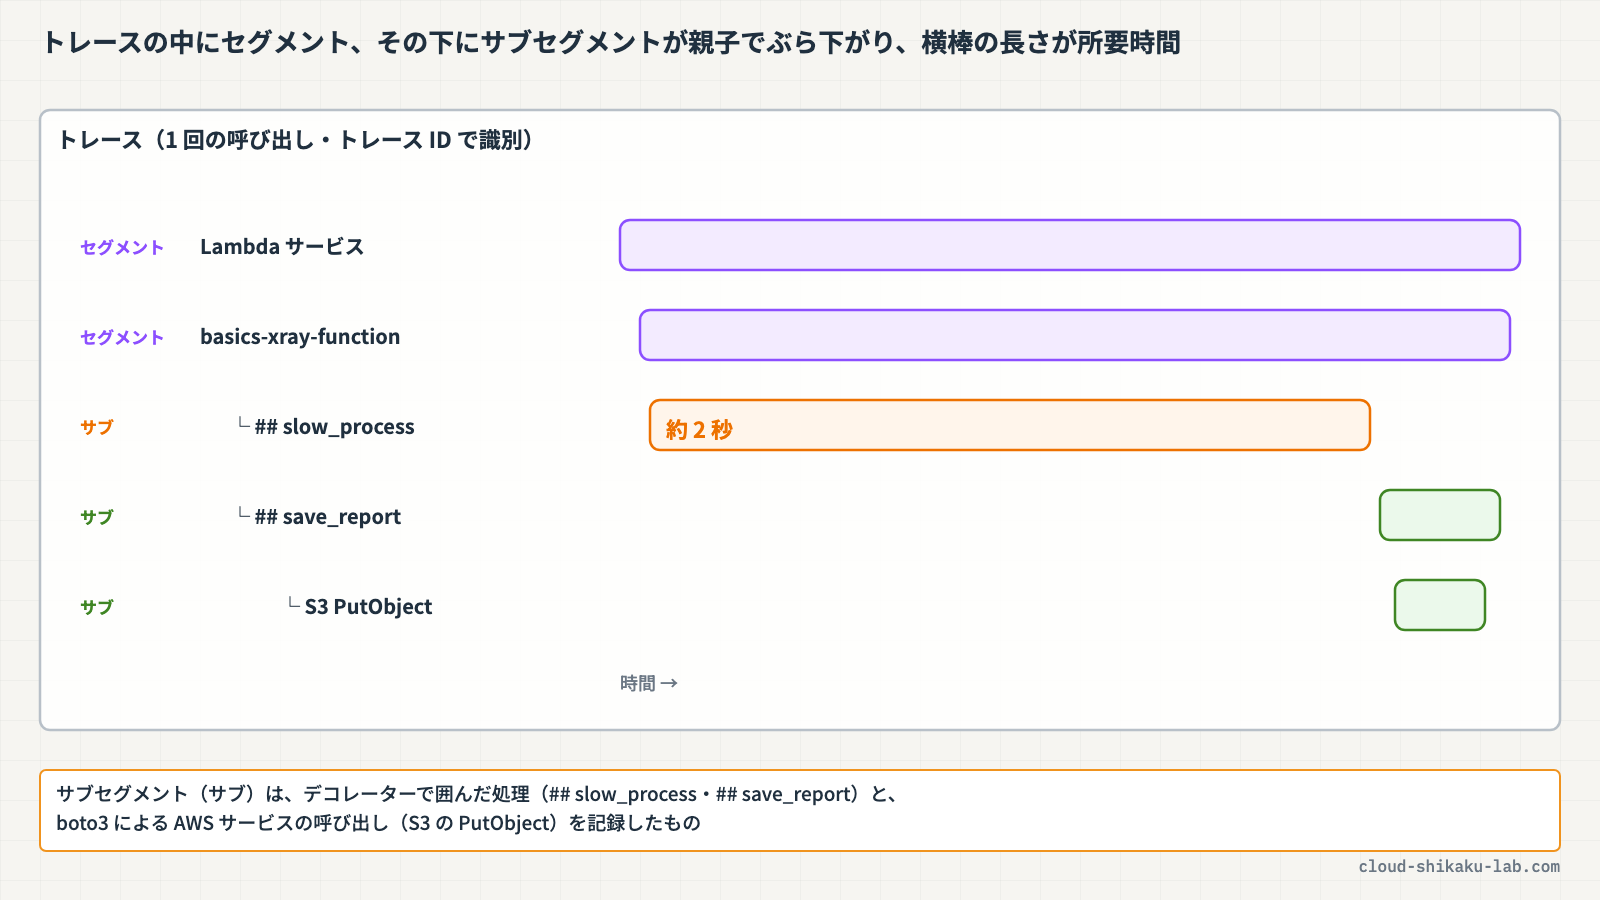
| トレース | 1 つのリクエストで生成されたすべてのセグメントをまとめたもの。トレース ID で識別する | 1 通の手紙の旅の全記録 |
| セグメント | リソース(Lambda 関数や EC2 上のアプリなど)が送る作業の記録。リソース名、リクエストの詳細、行った作業の詳細を含む | 中継所 1 か所の記録 |
| サブセグメント | セグメントの中の作業をさらに細かく分けた記録。AWS サービスや外部 API、SQL データベースの呼び出しや、コード内の特定の処理を記録できる | 中継所の中での「仕分け」「休憩」などの内訳 |
クラウドおさるサービスをまたいだとき、別々のセグメントが同じトレースだと、どうやって分かるのでござる?
土肥リクエストに付く X-Amzn-Trace-Id というトレースヘッダーで受け渡しているんだ。最初に X-Ray と統合されたサービスがこのヘッダーを付けて、そこにトレース ID とサンプリングの判定が入っているよ。後ろのサービスは同じトレース ID でセグメントを送るから、1 本のトレースにまとまるんだね。
クラウドおさる手紙に通し番号の札を付けておけば、どの中継所の記録も同じ手紙の分だと分かるのでござるな。
土肥その通り!ちなみにセグメントやサブセグメントには、検索に使える「注釈」(インデックスされるキーと値)と、検索には使わない「メタデータ」(オブジェクトやリストも入れられる)を付けられるよ。トレースデータは 30 日間保持されるんだ。
トレースマップとセグメントのタイムライン
クラウドおさる集めたトレースは、どのように見るのでござるか?
土肥よく使う見方は 2 つあるよ。全体の地図にあたる「トレースマップ」と、1 本のトレースを時間軸で見る「セグメントのタイムライン」だね。
| 見方 | 何が分かるか |
|---|---|
| トレースマップ | X-Ray にデータを送るリソースを「ノード」、サービス間の呼び出しを「エッジ」として描いた構成図。どのサービスがどこを呼んでいるか、どこでエラーが出ているかを俯瞰できる |
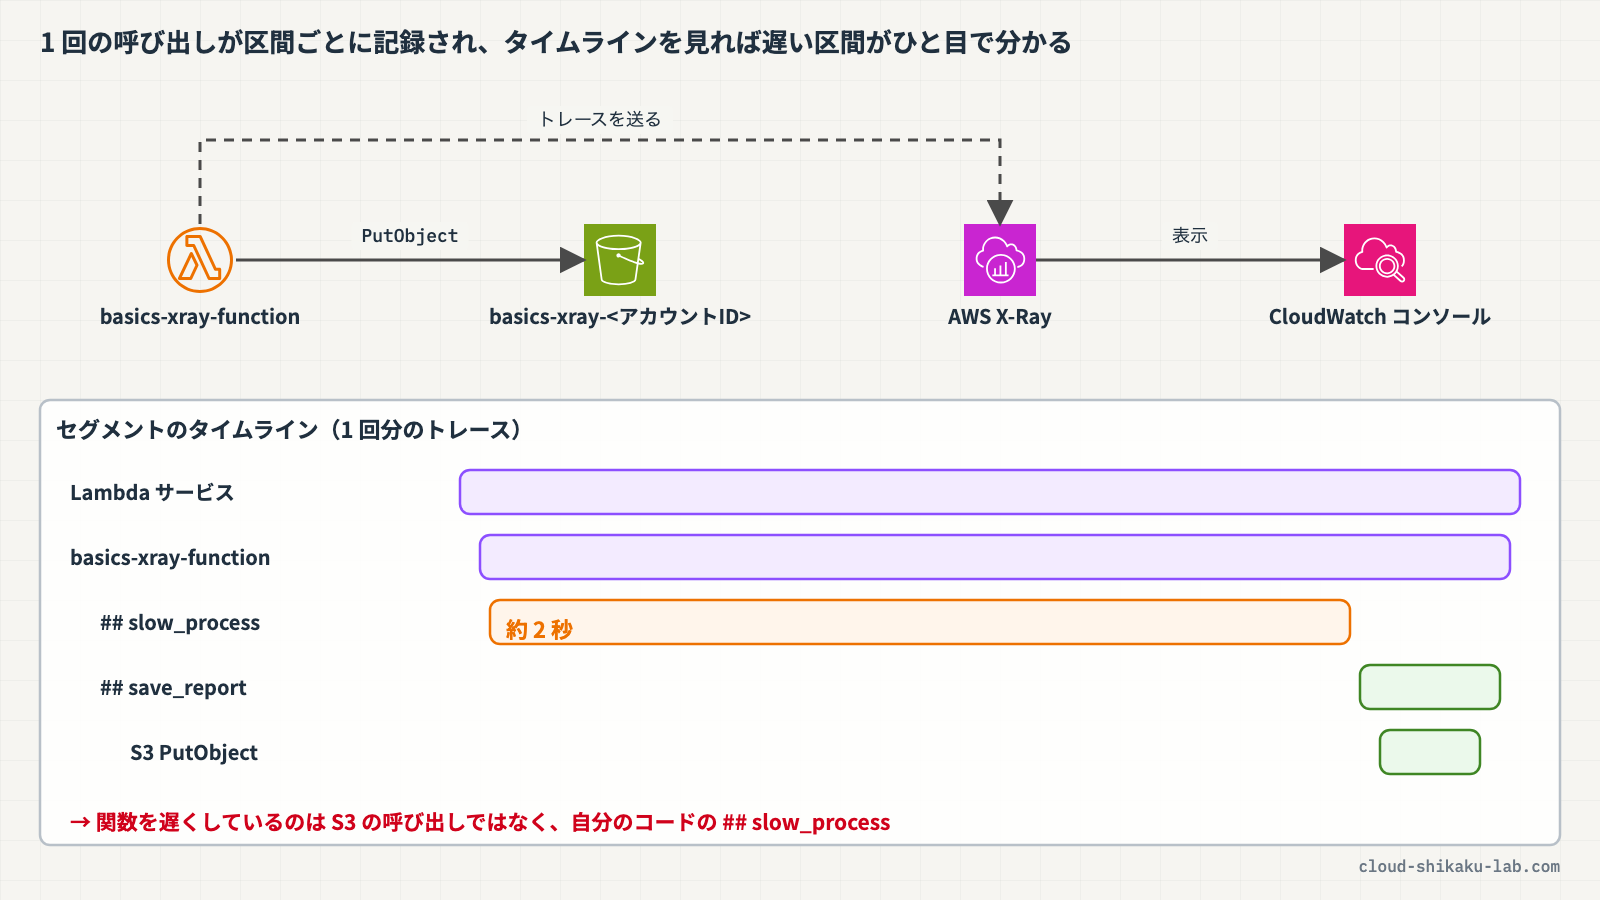
| セグメントのタイムライン | 1 本のトレースに含まれるセグメントとサブセグメントを、所要時間の横棒で並べた表示。どの区間が長いかがひと目で分かる |
土肥遅い箇所を探すときは、まずタイムラインで一番長い横棒を探して、その区間の詳細を開くのが基本の流れなんだ。サブセグメントの詳細には、呼び出したオペレーションやリソースの情報、注釈、例外などが表示されるよ。
クラウドおさる以前は X-Ray 専用のコンソールがあったと聞いたでござるが、今はどこで見るのでござる?
土肥X-Ray コンソールは CloudWatch コンソールに統合されていて、X-Ray コンソールの開発は終わっているんだ。今は CloudWatch コンソールの左側ナビゲーションの「Application Signals (APM)」の下にある「トレース」や「トレースマップ」を開いて見るよ。メトリクスやログと同じ画面の流れで行き来できるのが便利だね。
サンプリング
クラウドおさるすべてのリクエストを記録するのでござるか?それだと記録が山のように積み上がりそうでござる。
土肥いいところに気づいたね!X-Ray は「サンプリング」で記録するリクエストを絞っているんだ。デフォルトのルールはこうだよ。
| 項目 | デフォルト | 意味 |
|---|---|---|
| リザーバ | 1 秒あたり 1 リクエスト | 毎秒、最初の 1 件は必ず記録する。リクエストが来ている限り、少なくとも毎秒 1 トレースは残る |
| レート | 5% | リザーバを超えた追加のリクエストのうち、記録する割合 |
土肥EC2 などで動かすアプリは、サンプリングルールを自分で設定できるんだ。ただし Lambda 関数のサンプリングレートは「1 秒あたり 1 リクエストと、追加リクエストの 5%」で、関数側では変更できないよ。
クラウドおさる伝令が 1 秒に何十通も走る日でも、全部ではなく「毎秒 1 通 + 残りの 5%」だけ記録係が付いていくのでござるな。今回の実践のように数秒おきに 1 回ずつ試すなら、毎回記録されるはずでござる。
CloudWatch のメトリクス・ログとの違い
クラウドおさるLambda には CloudWatch のメトリクスやログもあるでござる。X-Ray と何が違うのでござるか?
土肥見ている「単位」が違うんだ。並べるとこんな感じだよ。
| 観点 | CloudWatch メトリクス | CloudWatch Logs | X-Ray のトレース |
|---|---|---|---|
| 単位 | 時系列の数値(例: Duration、Invocations、Errors) | コードやサービスが出力したログの行 | 1 リクエストの処理の流れ |
| 分かること | 平均や最大の実行時間、呼び出し回数、エラー数の推移 | print などで書き出した内容 | リクエストの中の区間ごとの所要時間、呼び出し先、エラーの発生箇所 |
| 向いている問い | 「最近遅くなっていないか」「エラーが増えていないか」 | 「この処理で何が起きたか」 | 「この遅いリクエストは、どこで時間を使ったか」 |
土肥たとえば Lambda の Duration メトリクスは、関数コードがイベントの処理に費やした時間なんだ。関数全体で 2 秒かかったことは分かるけど、その 2 秒の内訳までは分からない。ログに時刻を書き出せば推測はできるけど、サービスをまたぐとつなぎ合わせるのが大変なんだよね。
クラウドおさるメトリクスは「今日の伝令は平均何分かかったか」の帳簿、ログは「中継所の日誌」、トレースは「1 通の手紙の旅程表」でござるな。異常に気づくのはメトリクス、原因の区間を絞るのはトレース、という役割分担でござる。
土肥そうそう、その使い分けがばっちりだよ。実際の運用では、メトリクスのアラームで異常に気づいて、トレースで遅い区間を特定して、ログで詳細を確認する、という順番で組み合わせることが多いんだ。
Lambda で X-Ray を使うには
クラウドおさるLambda 関数でトレースを取るには、何をすればよいのでござるか?
土肥関数の設定で「Lambda サービストレース」を有効にするんだ。これがいわゆるアクティブトレースだね。Lambda コンソールで有効にすると、X-Ray にデータを送るのに必要な権限も実行ロールに自動で追加されるよ。
クラウドおさる有効にするだけで、関数の中の S3 呼び出しまで見えるのでござるか?
土肥そこが大事なポイント。Lambda が自動で記録するのは、Lambda サービスのセグメントと関数のセグメント、それに初期化(コールドスタート)や呼び出しのフェーズまでなんだ。関数の中でどの処理に時間がかかったか、S3 をどう呼んだかまで見るには、コード側で計測(計装)してサブセグメントを足す必要があるよ。
| 方法 | 記録されるもの |
|---|---|
| Lambda サービストレースを有効にするだけ | Lambda サービスのセグメント、関数のセグメント、初期化などのフェーズ |
| + X-Ray SDK for Python で計装する | 上記に加えて、boto3 による AWS サービス呼び出しのサブセグメントや、デコレーターで囲んだ処理のサブセグメント・注釈 |
土肥今回は X-Ray SDK for Python を使うよ。patch_all() を呼ぶと boto3 の呼び出しが自動でサブセグメントになって、@xray_recorder.capture('名前') を付けた関数も 1 つのサブセグメントとして記録されるんだ。ただし、Lambda の実行環境に X-Ray SDK は入っていないから、レイヤーにして関数に追加するよ。
クラウドおさる中継所の入口と出口の記録は Lambda が付けてくれて、中での「仕分け」「休憩」の内訳は自分で記録係を置く、ということでござるな!
X-Ray SDK のメンテナンスモードと OpenTelemetry
クラウドおさるX-Ray SDK について、ほかに知っておくべきことはあるでござるか?
土肥うん、大事な話があるよ。X-Ray SDK と X-Ray デーモンは 2026 年 2 月 25 日にメンテナンスモードに入っていて、今後のリリースはセキュリティの問題への対応に限られて、新機能は追加されないんだ。AWS は、アプリケーションの計装を OpenTelemetry ベースのソリューションに移行することを勧めているよ。
 クラウドおさる
これから本番のアプリに組み込むなら、X-Ray SDK ではなく OpenTelemetry を選ぶのがよいのでござるな。今回の SDK は、トレースの仕組みを体験するための道具として使うのでござる。
土肥そういうこと。Lambda の場合は、AWS Lambda Layer for OpenTelemetry を使う自動計装が推奨オプションとして案内されているよ。Lambda コンソールで CloudWatch Application Signals を有効にすると、このレイヤーの追加や環境変数・権限の設定が自動で行われるんだ。それから、OpenTelemetry に移行しても、CloudWatch コンソールの「トレース」や「トレースマップ」の見え方は変わらないって案内されているよ。だから今回覚える「タイムラインで長い横棒を探す」見方は、そのまま使えるんだ。
| 項目 | X-Ray SDK | OpenTelemetry ベース(ADOT など) |
|---|---|---|
| 位置づけ | 2026 年 2 月 25 日からメンテナンスモード(セキュリティ対応のみ) | AWS が移行を推奨する計装の標準 |
| Lambda での使い方 | SDK をパッケージやレイヤーに含める | AWS Lambda Layer for OpenTelemetry(推奨)など |
| トレースの見え方 | CloudWatch コンソールの「トレース」「トレースマップ」 | 同じ(コンソールでの見え方は変わらない) |
実践

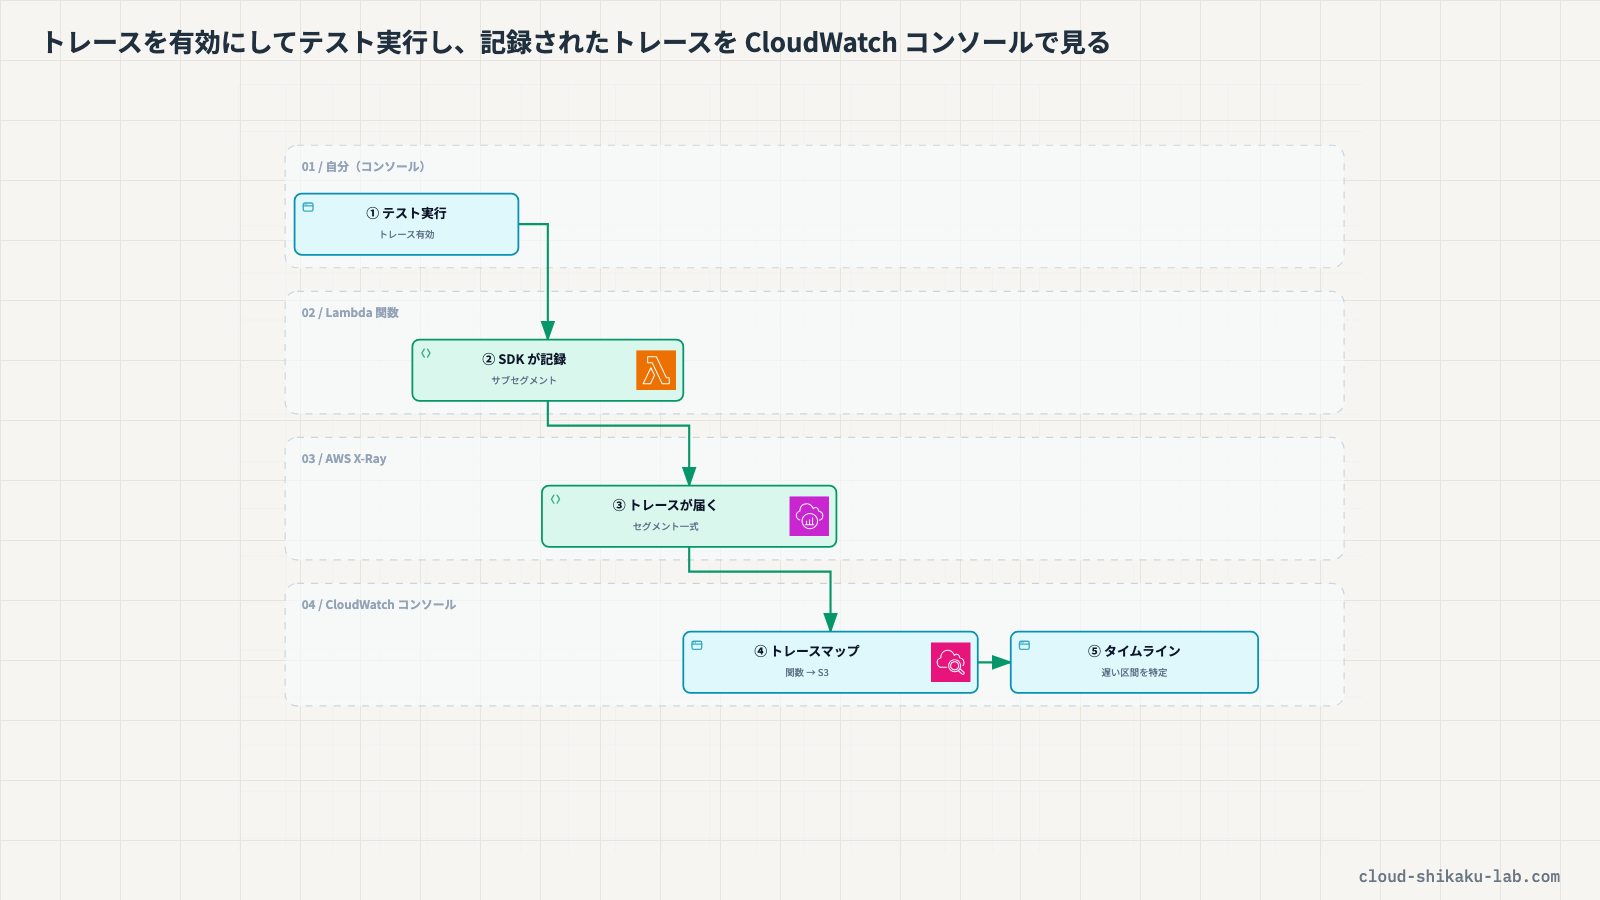
ここでは、2 秒の sleep と S3 への書き込みを行う Lambda 関数(Python)を作成し、X-Ray SDK をレイヤーとして追加したうえで Lambda サービストレースを有効にします。テスト実行したあと、CloudWatch コンソールでトレースのタイムラインを開き、時間がかかっている区間を特定します。
前提条件
- リージョン:
ap-northeast-1(東京) - AWS マネジメントコンソールにログイン済みで、Lambda・S3・IAM・CloudWatch・AWS CloudShell を操作できる権限があること
- 事前に作成しておくリソースはありません
| リソース種別 | リソース名 | 用途 |
|---|---|---|
| S3 バケット | basics-xray-<アカウントID> | Lambda 関数がレポートを書き込むバケット |
| Lambda レイヤー | basics-xray-sdk | X-Ray SDK for Python と boto3 をまとめたレイヤー |
| Lambda 関数 | basics-xray-function | 2 秒の sleep と S3 への書き込みを行う関数(Python 3.14) |
| IAM ロール | (Lambda が自動作成) | Lambda 実行ロール |
| IAM インラインポリシー | basics-xray-s3-put | 実行ロールに付ける、バケットの reports/ への書き込み権限 |
S3 バケットを作成する
- AWS マネジメントコンソールにログインし、リージョンが
ap-northeast-1(東京)であることを確認します - 上部の検索バーに
S3と入力し、表示された「S3」を選択します - 左側ナビゲーションの「汎用バケット」を選択し、「バケットを作成」をクリックします
- バケット名に
basics-xray-<アカウントID>(例:basics-xray-123456789012)を入力します - その他の項目はデフォルトのままにし、ページ下部の「バケットを作成」をクリックします
CloudShell で X-Ray SDK のレイヤーを作成する
Lambda の Python ランタイムには X-Ray SDK が含まれていないため、AWS CloudShell でパッケージをまとめてレイヤーとして登録します。X-Ray SDK をインストールすると依存関係として botocore も入ります。レイヤーの依存関係はランタイムに含まれるライブラリより優先して読み込まれるため、boto3 も一緒にレイヤーに入れてバージョンをそろえておきます。
- コンソール上部の CloudShell アイコンをクリックして(または検索バーに
CloudShellと入力して)CloudShell を開きます - CloudShell のリージョンが
ap-northeast-1であることを確認し、以下のコマンドを実行します
mkdir xray-layer && cd xray-layer
pip3 install aws-xray-sdk boto3 \
  --platform manylinux2014_x86_64 --only-binary=:all: --python-version 3.14 \
  -t python/
zip -r -q layer.zip python
aws lambda publish-layer-version \
  --layer-name basics-xray-sdk \
  --zip-file fileb://layer.zip \
  --compatible-runtimes python3.14 \
  --compatible-architectures x86_64 \
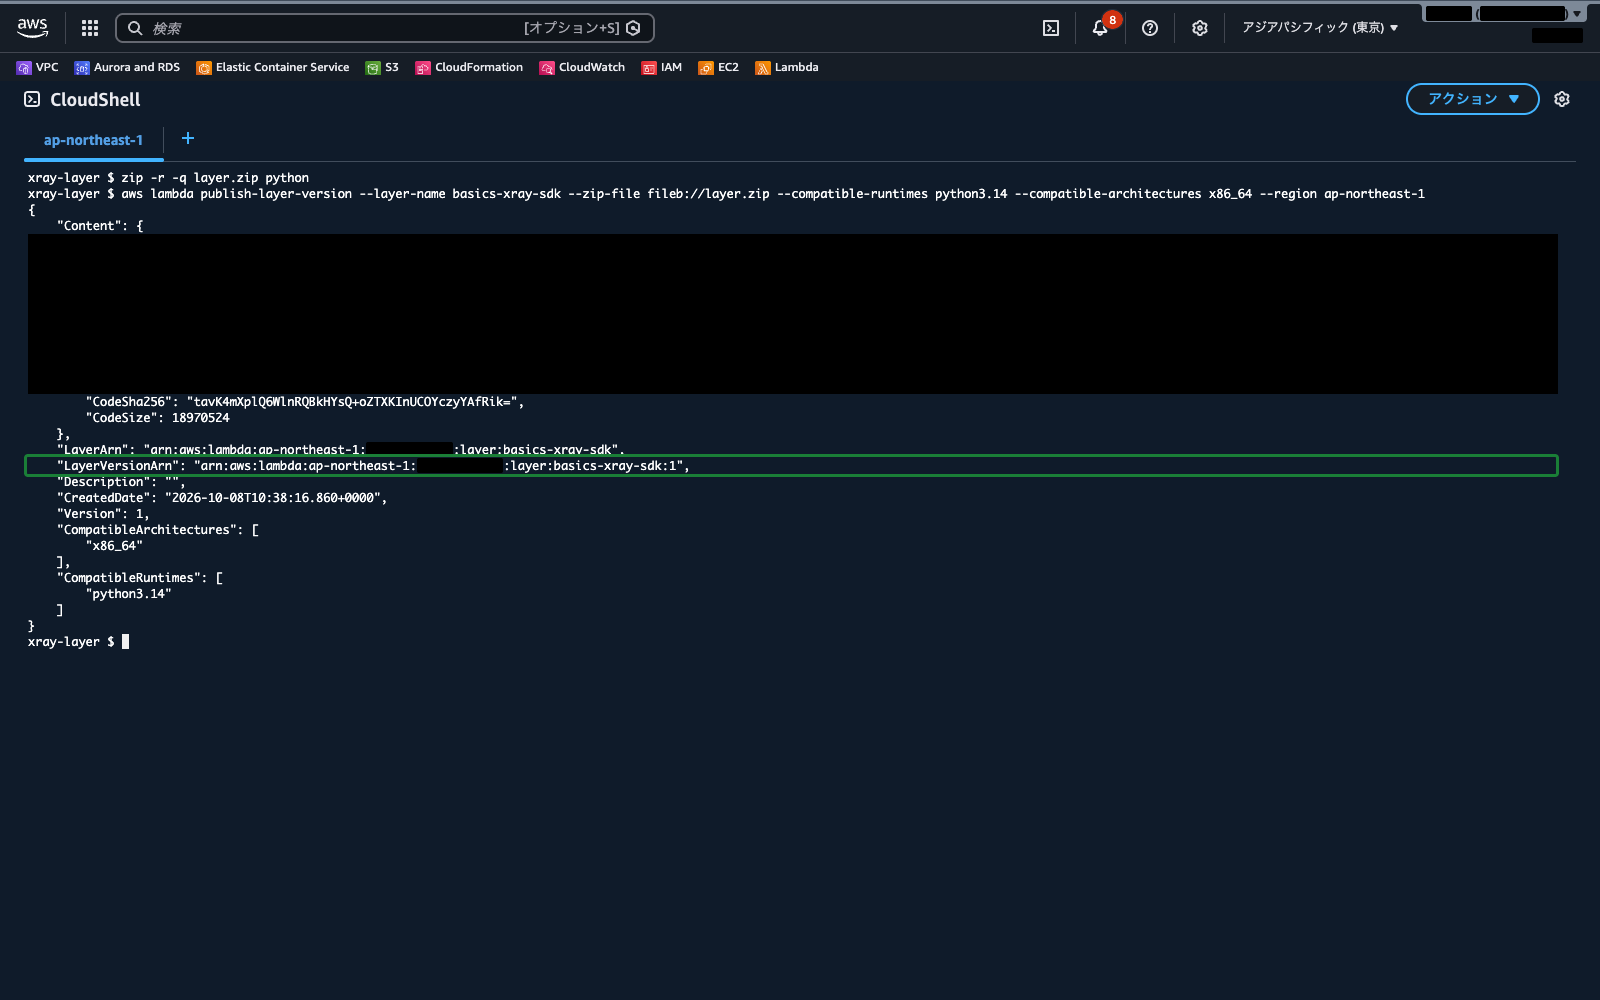
--region ap-northeast-1pip3 installの最後に、CloudShell にあらかじめ入っているaws-sam-cliとboto3のバージョンが合わないというERROR: pip's dependency resolver ...が表示されることがありますが、Successfully installed ...と出ていればpython/への配置は完了しています(-t python/で別ディレクトリに入れているため、CloudShell 側の環境には影響しません)- 出力された JSON の
LayerVersionArnがarn:aws:lambda:ap-northeast-1:<アカウントID>:layer:basics-xray-sdk:1になっていることを確認します
Lambda 関数を作成する
- 上部の検索バーに
Lambdaと入力し、表示された「Lambda」を選択します - 左側ナビゲーションの「関数」を選択し、「関数の作成」をクリックします
- 「一から作成」が選択されていることを確認し、以下を入力します
- 関数名:
basics-xray-function - ランタイム:
Python 3.14 - 「アクセス許可」に、基本的な Lambda アクセス許可を持つ新しい実行ロールが作成されると表示されていることを確認します(アーキテクチャは
x86_64がデフォルトです) - その他の項目はデフォルトのままにし、「関数の作成」をクリックします
タイムアウトと環境変数を設定する
関数は 2 秒の sleep を含むため、デフォルトの 3 秒のタイムアウトでは足りなくなるおそれがあります。タイムアウトを延ばし、書き込み先のバケット名を環境変数で渡します。
- 「設定」タブ →「一般設定」を選択し、「編集」をクリックします
- タイムアウトを
0分10秒に変更し、「保存」をクリックします - 「設定」タブ →「環境変数」を選択し、「編集」をクリックします
- 「環境変数を追加」をクリックし、キー
BUCKET_NAME、値basics-xray-<アカウントID>を入力して「保存」をクリックします
レイヤーを追加してコードをデプロイする
- 「コード」タブを選択し、ページ下部の「レイヤー」セクションで「編集」をクリックします
- 「レイヤーを編集」画面で「レイヤーの追加」をクリックします
- 「レイヤーを選択」で、「レイヤーソース」の「カスタムレイヤー」を選択し、カスタムレイヤーに
basics-xray-sdk、バージョンに1を選択して「追加」をクリックします - 「レイヤーを編集」画面に戻ったら「保存」をクリックします
- 「コード」タブに戻り、
lambda_function.pyの内容を以下に書き換えます
import os
import time

import boto3
from aws_xray_sdk.core import patch_all, xray_recorder

# boto3 などのライブラリにパッチを当て、AWS サービスの呼び出しをサブセグメントとして記録する
patch_all()

s3 = boto3.client('s3')
BUCKET_NAME = os.environ['BUCKET_NAME']


@xray_recorder.capture('## slow_process')
def slow_process():
    # わざと 2 秒待って、遅い処理を再現する
    time.sleep(2)


@xray_recorder.capture('## save_report')
def save_report(order_id):
    # 検索に使える注釈として注文 ID を記録する
    xray_recorder.current_subsegment().put_annotation('order_id', order_id)
    s3.put_object(
        Bucket=BUCKET_NAME,
        Key=f'reports/{order_id}.txt',
        Body=f'order {order_id} processed'.encode('utf-8'),
    )


def lambda_handler(event, context):
    order_id = event.get('order_id', 'unknown')
    slow_process()
    save_report(order_id)
    print(f'processed order {order_id}')
return {'statusCode': 200, 'body': f'processed order {order_id}'}- コードエディタ左側の「DEPLOY」セクションにある「Deploy」をクリックし、関数が更新されたことを確認します
## slow_process と ## save_report は @xray_recorder.capture でそれぞれ 1 つのサブセグメントになり、save_report の中の put_object は patch_all() によって S3 のサブセグメントとして記録されます。
実行ロールにバケットへの書き込み権限を付ける
- 「設定」タブ →「アクセス権限」を選択し、「実行ロール」のロール名のリンクをクリックして IAM コンソールでロールを開きます
- 「許可」タブで「許可を追加」→「インラインポリシーを作成」をクリックします
- ポリシーエディタで「JSON」を選択し、以下の内容に書き換えます(
<アカウントID>は自分のアカウント ID に置き換えます)
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "BasicsXrayReportsPut",
      "Effect": "Allow",
      "Action": "s3:PutObject",
      "Resource": "arn:aws:s3:::basics-xray-<アカウントID>/reports/*"
    }
  ]
}- 「次へ」をクリックし、ポリシー名に
basics-xray-s3-putを入力して「ポリシーの作成」をクリックします
Lambda サービストレースを有効にする
- Lambda コンソールの
basics-xray-functionに戻り、「設定」タブ →「モニタリングおよび運用ツール」を選択します - 「その他の監視ツール」の「編集」をクリックします
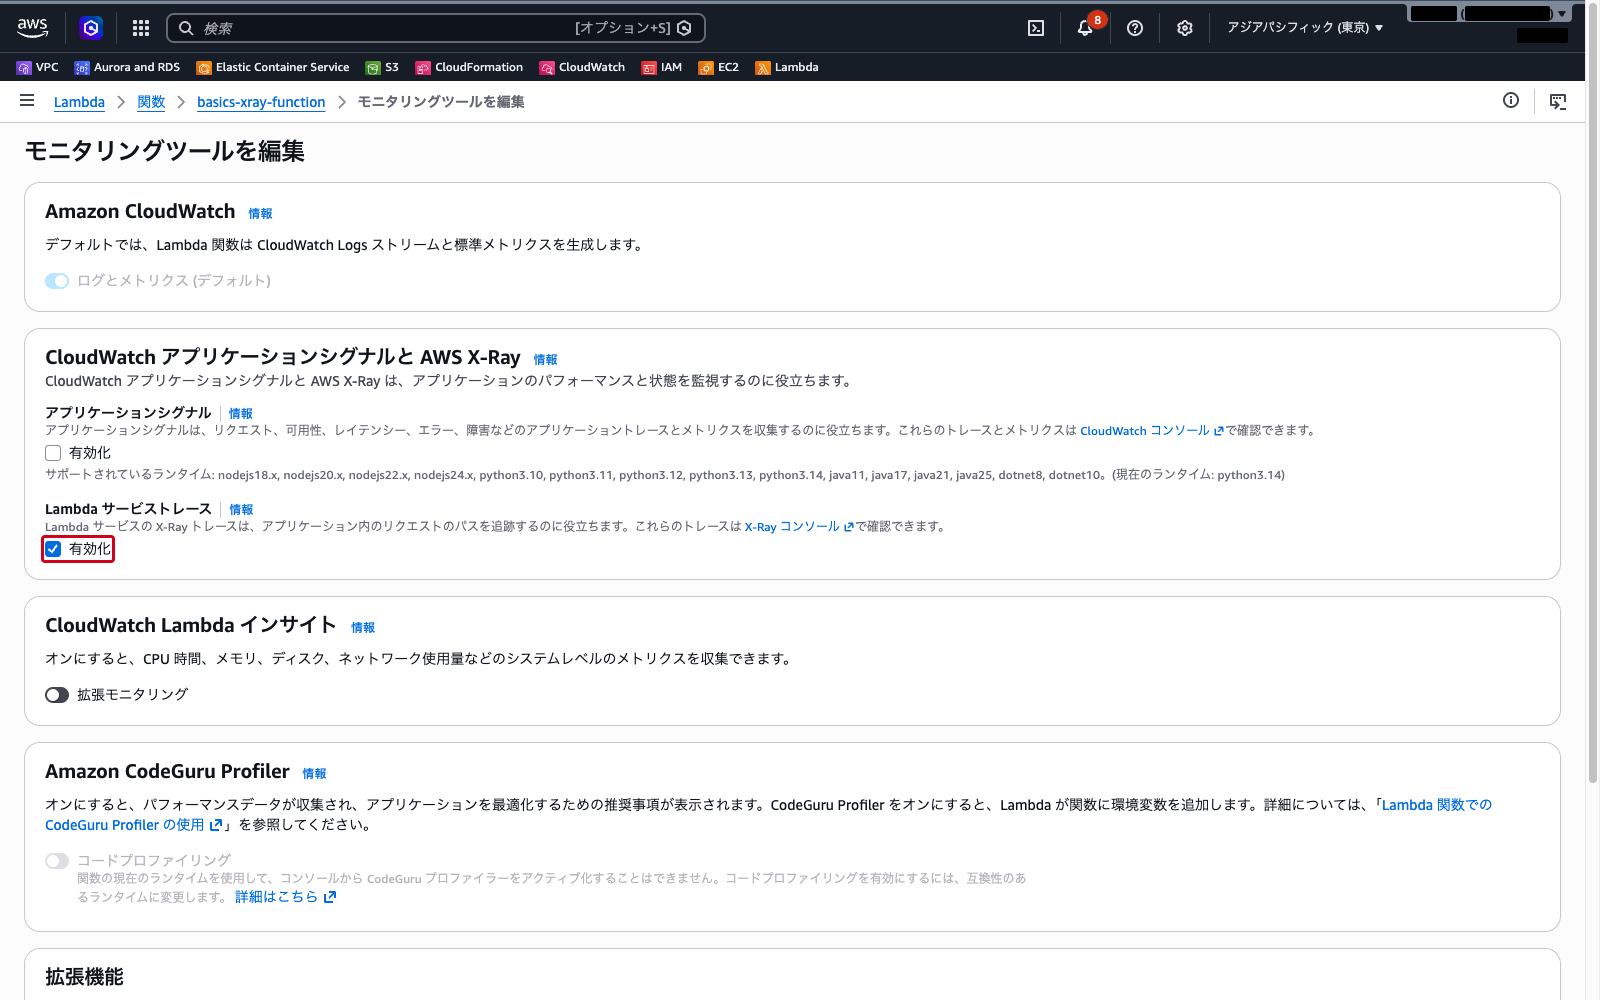
- 「CloudWatch アプリケーションシグナルと AWS X-Ray」の「Lambda サービストレース」で「有効化」にチェックを入れます(「アプリケーションシグナル」はオフのままにします)
- 「保存」をクリックします
Lambda コンソールでトレースを有効にすると、X-Ray にトレースデータを送るための権限(xray:PutTraceSegments と xray:PutTelemetryRecords)を許可する AWSLambdaTracerAccessExecutionRole-… というポリシーが実行ロールに自動でアタッチされます。
クラウドおさるX-Ray のトレースは毎月の無料利用枠の範囲までは無料でござるが、上限を超えるとトレースの保存と取得に料金がかかるのでござる。今回のように数回試すだけならよいが、トレースを有効にした関数に大量のリクエストを流し続けると、バナナが少しずつ減っていくので注意でござるぞ。
テスト実行する
- 「テスト」タブを選択し、「新しいイベントを作成」が選択されていることを確認します
- イベント名に
order001を入力し、イベント JSON を以下に書き換えます
{
  "order_id": "A001"
}- 「保存」をクリックしてから「テスト」をクリックします
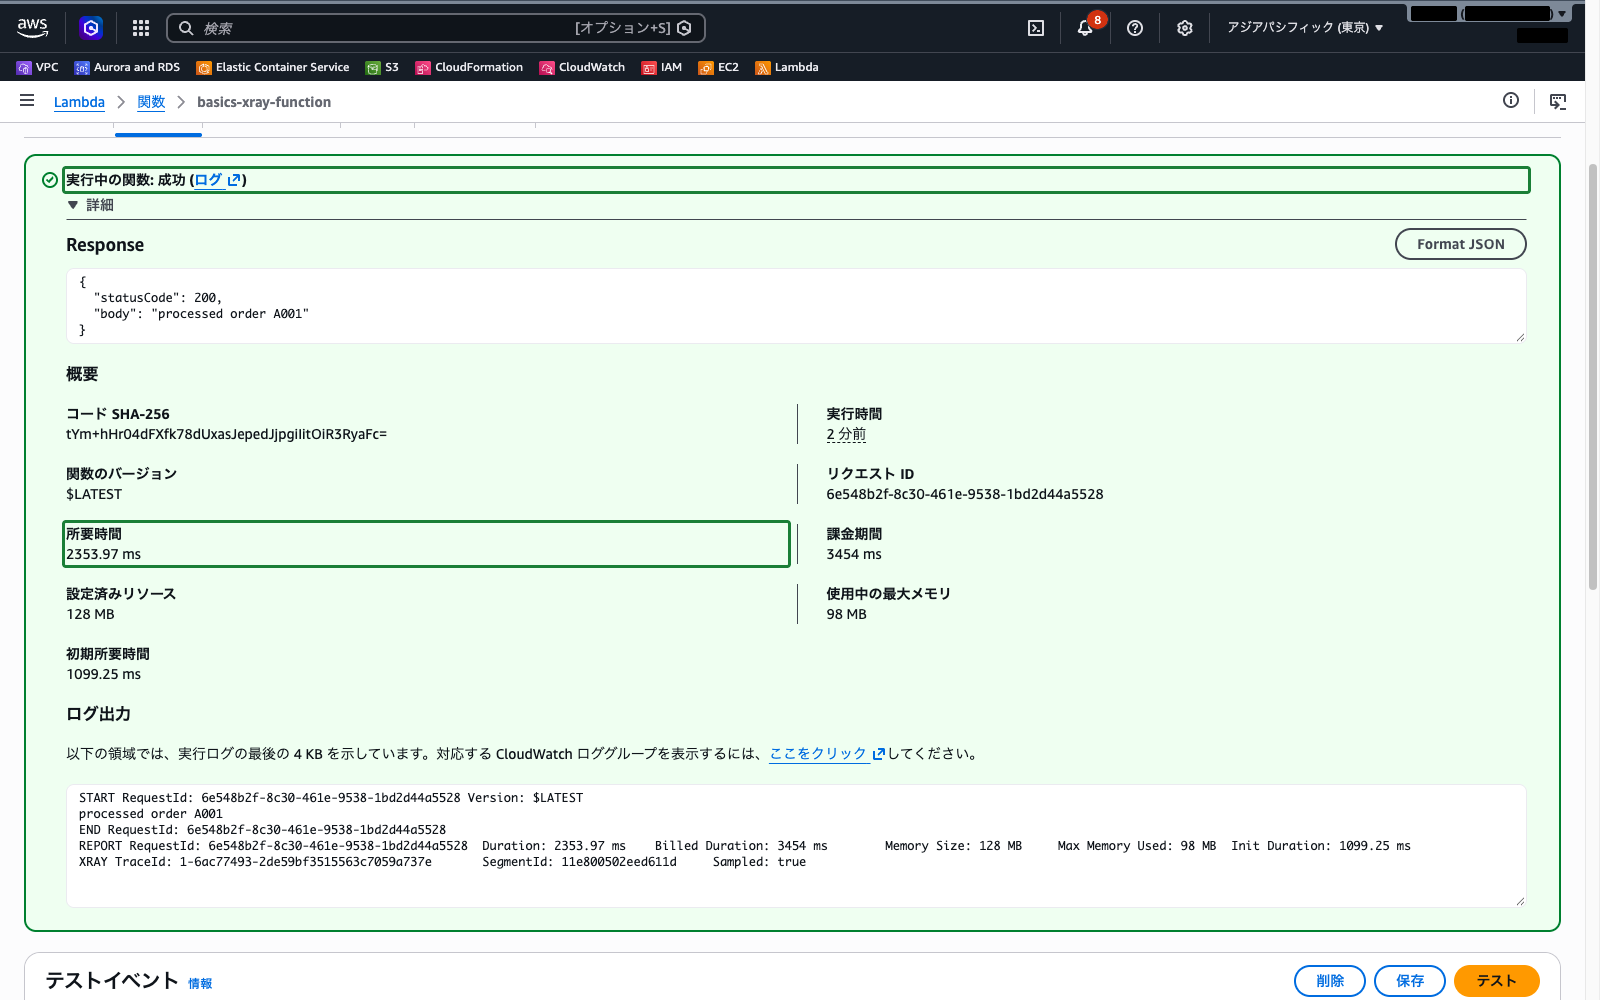
- 「実行中の関数: 成功」と表示されることを確認し、「詳細」を展開して、
processed order A001のレスポンスと、2 秒を超える「所要時間」が表示されていることを確認します
- 数秒待ってから、もう一度「テスト」をクリックします(2 回目は実行環境が再利用され、初期化のフェーズを含まないトレースになります)
CloudWatch コンソールでトレースを探す
- 上部の検索バーに
CloudWatchと入力し、表示された「CloudWatch」を選択します - 左側ナビゲーションの「Application Signals (APM)」→「トレース」を選択します
- 時間範囲を「15分」にします
- 「クエリリファイナー」の「ノード」の一覧で、
basics-xray-function(種類は「Lambda Function」)にチェックを入れ、「クエリに追加」をクリックして、basics-xray-functionだけに絞り込みます - 「クエリの実行」をクリックします
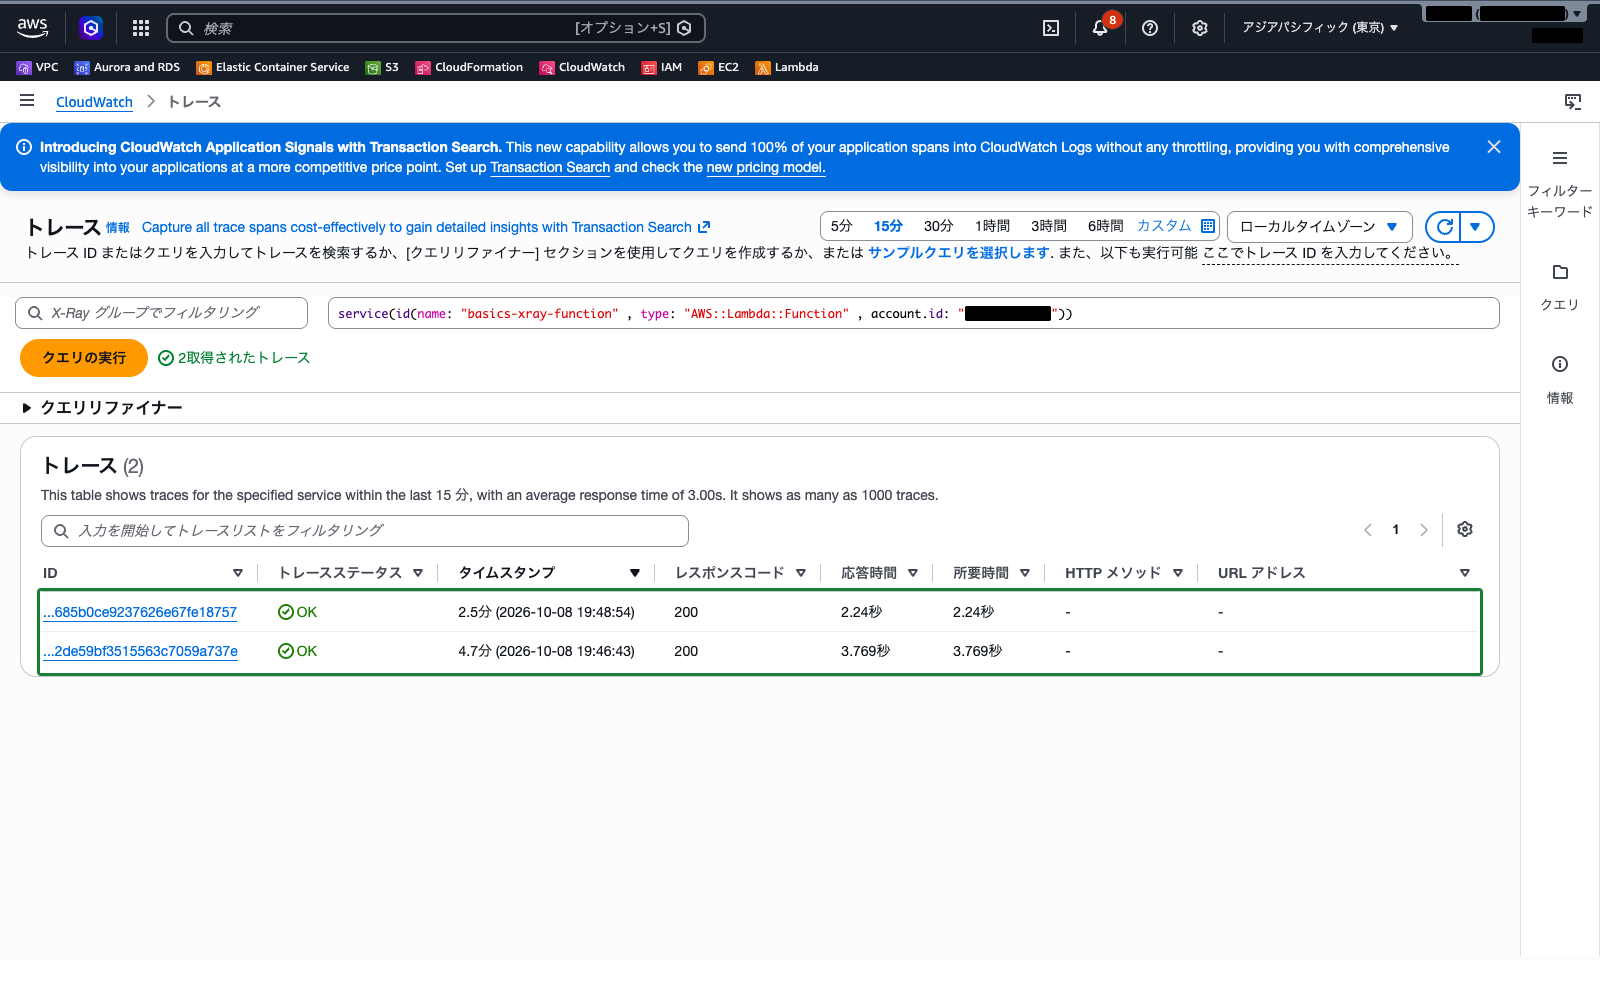
- 「トレース」セクションに、テスト実行した 2 回分のトレースが表示されることを確認します(
basics-xray-function以外の関数のトレースが同じアカウントにある場合も、この絞り込みで混ざらなくなります)
タイムラインで遅い区間を特定する
- 一覧から 2 回目に実行したトレースの ID をクリックし、トレースの詳細を開きます
- 「セグメントのタイムライン」の
AWS::Lambda::Functionのグループで、basics-xray-functionの下に並ぶサブセグメントの「所要時間」と横棒の長さを確認します
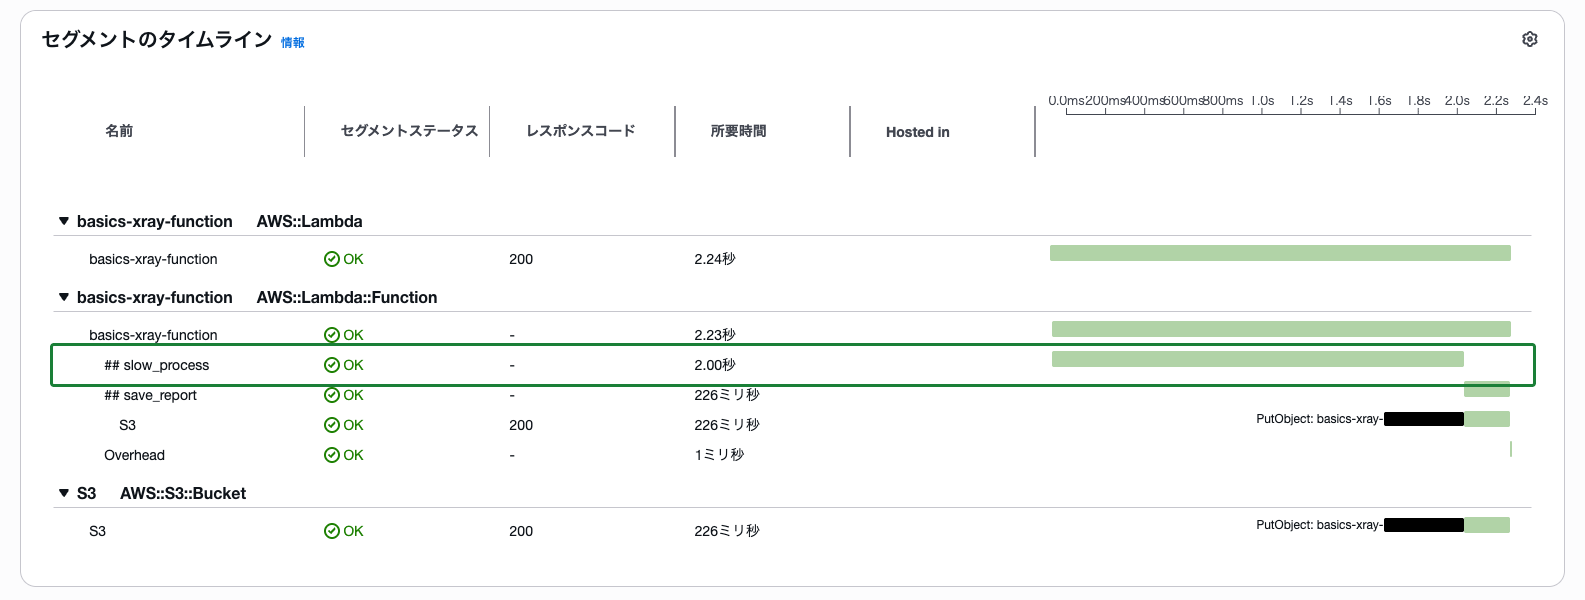
## slow_process がおよそ 2 秒を占めている一方、## save_report と、その中の S3 の PutObject の呼び出しは短時間で終わっていることが確認できます。関数全体の所要時間を押し上げているのは S3 の呼び出しではなく、自分のコードの slow_process だと特定できました。
- タイムラインで
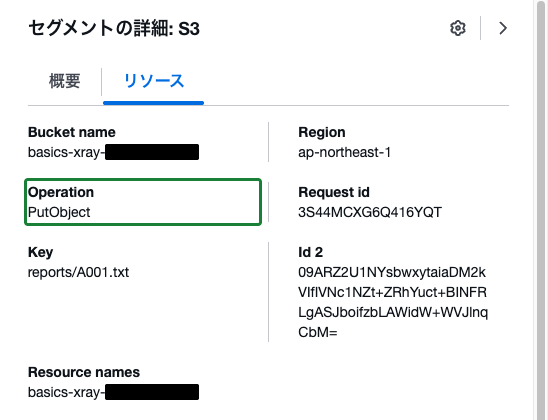
## save_reportの下にあるS3のサブセグメントをクリックし、右側に開く「セグメントの詳細: S3」パネルの「リソース」タブで、呼び出したオペレーション(PutObject)が記録されていることを確認します ## save_reportのサブセグメント名をクリックし、「注釈」タブにorder_idがA001として記録されていることを確認します
- 「トレースの詳細」の上部に表示されるトレースマップで、
basics-xray-function(Lambda Function)から S3 へのエッジが描かれていることも確認できます - 1 回目に実行したトレースも開くと、
AWS::Lambda::FunctionのグループにInit(初期化。コールドスタート)の行が追加で表示され、1 秒前後かかっていることが確認できます
クラウドおさる全体で 2 秒かかったことはメトリクスでも分かるでござるが、「2 秒のうちほとんどが slow_process、S3 は一瞬」と言い切れるのはタイムラインのおかげでござる。伝令が遅いときに、中継所を責める前に旅程表を見るのが猿山の新しい決まりになりそうでござるな。
まとめ
- AWS X-Ray は、アプリケーションが処理するリクエストのデータを集め、呼び出し先のサービスも含めた処理の流れを可視化する分散トレーシングのサービス
- トレースは 1 リクエスト分のセグメントの集まりで、セグメントはリソースごとの作業の記録、サブセグメントはその内訳(AWS サービスの呼び出しやコード内の処理)を表す。サービス間はトレースヘッダー
X-Amzn-Trace-Idでつながる - トレースマップでサービス間の呼び出しを俯瞰し、セグメントのタイムラインで遅い区間を特定する。X-Ray コンソールは CloudWatch コンソールに統合され、「Application Signals (APM)」の下の「トレース」「トレースマップ」から確認する
- サンプリングのデフォルトは「1 秒あたり 1 リクエスト + 追加リクエストの 5%」。Lambda 関数ではこのレートを変更できない
- CloudWatch のメトリクスは異常に気づくため、ログは詳細の確認、トレースは 1 リクエストの中の遅い区間やエラー箇所の特定に使う
- Lambda では「Lambda サービストレース」を有効にすると関数のセグメントが記録され、関数内の処理や AWS サービス呼び出しまで見るにはコード側の計装が必要
- X-Ray SDK とデーモンは 2026 年 2 月 25 日からメンテナンスモードで、AWS は OpenTelemetry ベースの計装への移行を推奨している。移行後もコンソールでのトレースの見え方は変わらない
関連記事として、Lambda の基本は AWS Lambda で関数を作成しイベント駆動で実行する、メトリクスとアラームは Amazon CloudWatch でメトリクスとアラームを設定する、S3 の基本操作は Amazon S3 でバケットを作成しオブジェクトを管理する、IAM ロールとポリシーは AWS IAM でユーザー・ロール・ポリシーを作成しアクセス制御する で解説しています。
参照先
- AWS X-Ray とは
- AWS X-Ray の概念
- サンプリングルールの設定
- コンソールを使用する
- トレースとトレースの詳細の表示
- X-Ray SDK とデーモンのサポートタイムライン
- X-Ray による計装から OpenTelemetry による計装への移行
- AWS X-Ray SDK for Python
- ダウンストリームコールを実装するためのライブラリへのパッチ適用
- X-Ray SDK for Python を使用したカスタムサブセグメントの生成
- AWS X-Ray を使用した Lambda 関数呼び出しの視覚化
- AWS Lambda での Python コードの作成
- Lambda でアプリケーションを有効にする
- Lambda 関数のメトリクスのタイプ
- Python Lambda 関数にレイヤーを使用する
- Python Lambda 関数で .zip ファイルアーカイブを使用する
- Lambda 関数のタイムアウトを設定する
- Lambda 環境変数の操作
- AWS CloudShell とは
- 汎用バケットの作成